S-Space 深化解读:多模态模型里的可读写空间工作区
这是深化版,不替代原稿。原稿存档:
S-Space-深度精读报告.md
一手材料:MirroS blog <https://mirros.ai/blog/s-space>;技术报告references/s-space-report.pdf(2026-09-07,18 页);代码来源与恢复说明(克隆 commit489f151e720e9ddb69c0617544cc0f7d5eabcbc3,README 更新时间 2026-09-08)。
本次新增核验:解析仓库发布的 5 套预提取坐标轴,计算三轴余弦/夹角,结果在references/axis_cosine_report.json与analysis-assets/;按仓库 config 的expected_sample_count=146反推 SpinBench 三个百分数的计数并计算 Wilson 置信区间,均标注为编者计算。
0. 相对原稿,本版改动四处
- 把“blog 说得是否有道理”改成可核对协议:样本量、层号、端点词、坐标轴文件、实验 config、模板代码逐项对齐。
- 原稿提出“三轴正交性未检验”是关键空缺;本版直接用作者发布的
tensors.safetensors算出夹角。结论需要修正:水平—垂直基本接近正交;垂直—距离在 Molmo 系列上有不可忽略的相关性,最高绝对余弦约 0.35;Qwen3.6-27B 在选层附近更接近正交。该结果削弱了“必然严重纠缠”的强猜测,但没有消除干预特异性需要按轴重估的问题。 - SpinBench 的 60.96%、94.52%、83.56% 不再只按百分数转述:仓库 config 给出
expected_sample_count=146,三个数对应 89/146、138/146、122/146;本版补算 Wilson 95% 区间,并说明哪些比较是同模型、哪些不是。 - CoT 演化实验的证据等级下调更明确:仓库脚本和模板文件写明这是“teacher-force / label-conditioned / supplied gold-conditioned reasoning template”,模板函数直接读取官方答案构造推理链。它可以证明“灌入正确三阶段文本后,物体 token 投影随阶段移动”,不能证明模型自主推理时会做心理旋转。
1. 材料身份与证据等级
这项工作有三种材料形态,证据强度不同:
| 材料 | 内容 | 能支持什么 | 不能支持什么 |
|---|---|---|---|
| Blog / Technical report | 方法叙述、核心图、少量百分数、附录算法 | 研究问题、方法设计、主要现象、作者结论边界 | 完整数值表、显著性检验、全部样本量 |
| GitHub 仓库 | 安装、数据准备、实验命令、部分 config、预提取坐标轴、若干 README/CSV | 复现路径、部分实验协议、坐标轴文件、CoT 模板性质、InstructPart 历史数值 | 所有图的原始输出;SpinBench 三个百分数的官方逐样本输出未随仓库直接给出 |
| 本地原精读稿 | 已读完 blog、附录和 README 的分析稿 | 问题框架和大部分判断 | 未实测坐标轴夹角;个别表述需要从“强质疑”改为“按模型和层有条件成立” |
本版把结论分成四级:A 可接受、B 有条件接受、C 只能作现象描述、D 不应引用为结论。
2. 总结论
A 可接受:在 COCO 提取分布和若干空间问答 benchmark 上,物体名词最后 token 的中间层激活里存在可线性读出的连续坐标结构;该结构对空间答案有因果影响;它不是只由成对提问格式临时诱导出来的。支持证据是 Fig 4 的连续相关、Fig 7 的干预特异性、Fig 8 的跨提问格式保持、附录 B 的层间鲁棒性,以及仓库发布的逐层坐标轴和验证准确率。
B 有条件接受:S-Space 可以超出可见物体,包含画外实体、观察者和语言隐含关系;多视角下坐标能跟随 prompt 指定视角。接受时要带限制:画外与观察者部分是少量案例加模板 bootstrap;多视角结果在报告里只给“高于随机”的定性表述,没有完整数值表。
C 只能作现象描述:socialist/conservative 落在物理左右轴附近;north/up、east/right 的方向耦合;动作监督让 part–whole 深度判断更准。三者都有机制启发性,但都缺关键对照:跨图像/跨语言/中性概念对照、方向词干预闭环、同规模非动作微调对照。
D 不应引用为结论:“模型内部已经有 94.52% 的视角转换能力”“CoT 会自主旋转 S-Space”“动作监督整体锐化 S-Space”。第一句漏掉外部旋转和规则;第二句与仓库的 gold-conditioned 模板冲突;第三句只覆盖 depth 轴,仓库 README 的历史数值显示 horizontal/vertical 与 overall 并不随动作训练单调改善。
3. 方法细节:坐标轴不是训练出来的探针,而是从答案对比量反推
3.1 基本对象
固定层 。每个样本有图像和 prompt ,prompt 比较 query 物体 和 reference 物体 沿轴 的关系。 同时指物体名最后一个重叠 subtoken 的位置;仓库 manifest 写明 object_token_protocol=last_overlapping_subtoken。最终答案端点 token 的 logit 记为 。
报告附录写的对比量是:
但仓库发布坐标轴的 manifest 与代码模板更具体:prompt 模板使用 above/below,artifact 的 positive_endpoints=[right,below,close]、negative_endpoints=[left,above,far],Molmo2-ER manifest 的 logit_contrasts=[right-left,below-above,close-far]。这与报告 prose “正方向为 right/up/close” 存在符号口径差异。最稳妥的理解是:图像平面坐标的垂直正方向在 artifact 里按 below 记录,而报告叙述按直觉把“上”叫正方向。做读出正负号判断或干预方向时,应以 artifact manifest 为准;只比较三轴夹角时符号不影响结论。
3.2 Jacobian 与角色反对称
答案对比量对物体 token 隐状态的梯度是:
它表示:在该层把物体表示往哪个方向轻推,right-left、below-above 或 close-far 的答案差增加最快。对 query/reference 作角色反对称:
附录的两条假设给出它的识别逻辑:
- Assumption 1: 可分解为空间成分 、非空间属性成分、上下文成分;三者相互正交。
- Assumption 2:空间成分在 query/reference 互换时变号;非空间属性不影响空间答案梯度;角色不对称上下文效应在期望下抵消。
在这两条假设下:
作差消去两物体共享的非空间/上下文分量,模板平均和顺序对调把措辞偏置变成期望为零的项。除以 只是尺度;最后统一 L2 归一化,所以方向识别不依赖该系数。
3.3 数据规模与配置
报告附录说:未裁剪 COCO 中取 6000 个物体对,每轴 2000 对;每对 5 个模板 × 2 种物体顺序。仓库 manifest 给出更细口径:train_samples=6000、train_jobs=30000、train_prompts=60000、axis_prompt_counts_hvd=[20000,20000,20000]。口径一致:每轴 个 prompt;三轴合计 60000 个 prompt。五个 prompt style 在 artifact 中记为 baseline/direct/natural/choice_first/terse。
坐标轴按每层独立估计,再在 COCO-1800 验证集上按 margin_sign_v1 选层。Molmo2-ER artifact 的选择结果是 zero-based layer 22,验证集 1800 例,整体准确率 93.39%,三轴准确率为 horizontal 98.50%、vertical 98.67%、distance 83.00%。注意报告 Fig 4 图注写 “layer 21”,仓库 object_coordinates/reference/coco_molmo2_er_l21 也保存 L21 投影;因此 Fig 4 展示层与最终 readout 选择层不完全相同。引用层号时要写清:Fig 4 是 L21 投影示例,COCO-1800 选出的 readout 层是 L22(zero-based)。
3.4 读出与干预
读出矩阵:
相对判断用坐标差:
符号决定 left/right、above/below、far/close;具体正负端点要按 artifact 的 endpoint 口径映射。干预是在选定层把某个物体 token 沿目标轴移动: 或移动到反事实坐标,保持 S-Space 外分量不变,然后继续 forward。仓库 spatial-causality config 扫 --alpha-values 0..6、--beta-values -30..30,每类 200 样本,模型为 Molmo2-ER。
4. 新增实测:三轴并不严格正交,但问题比原稿猜测的更分层
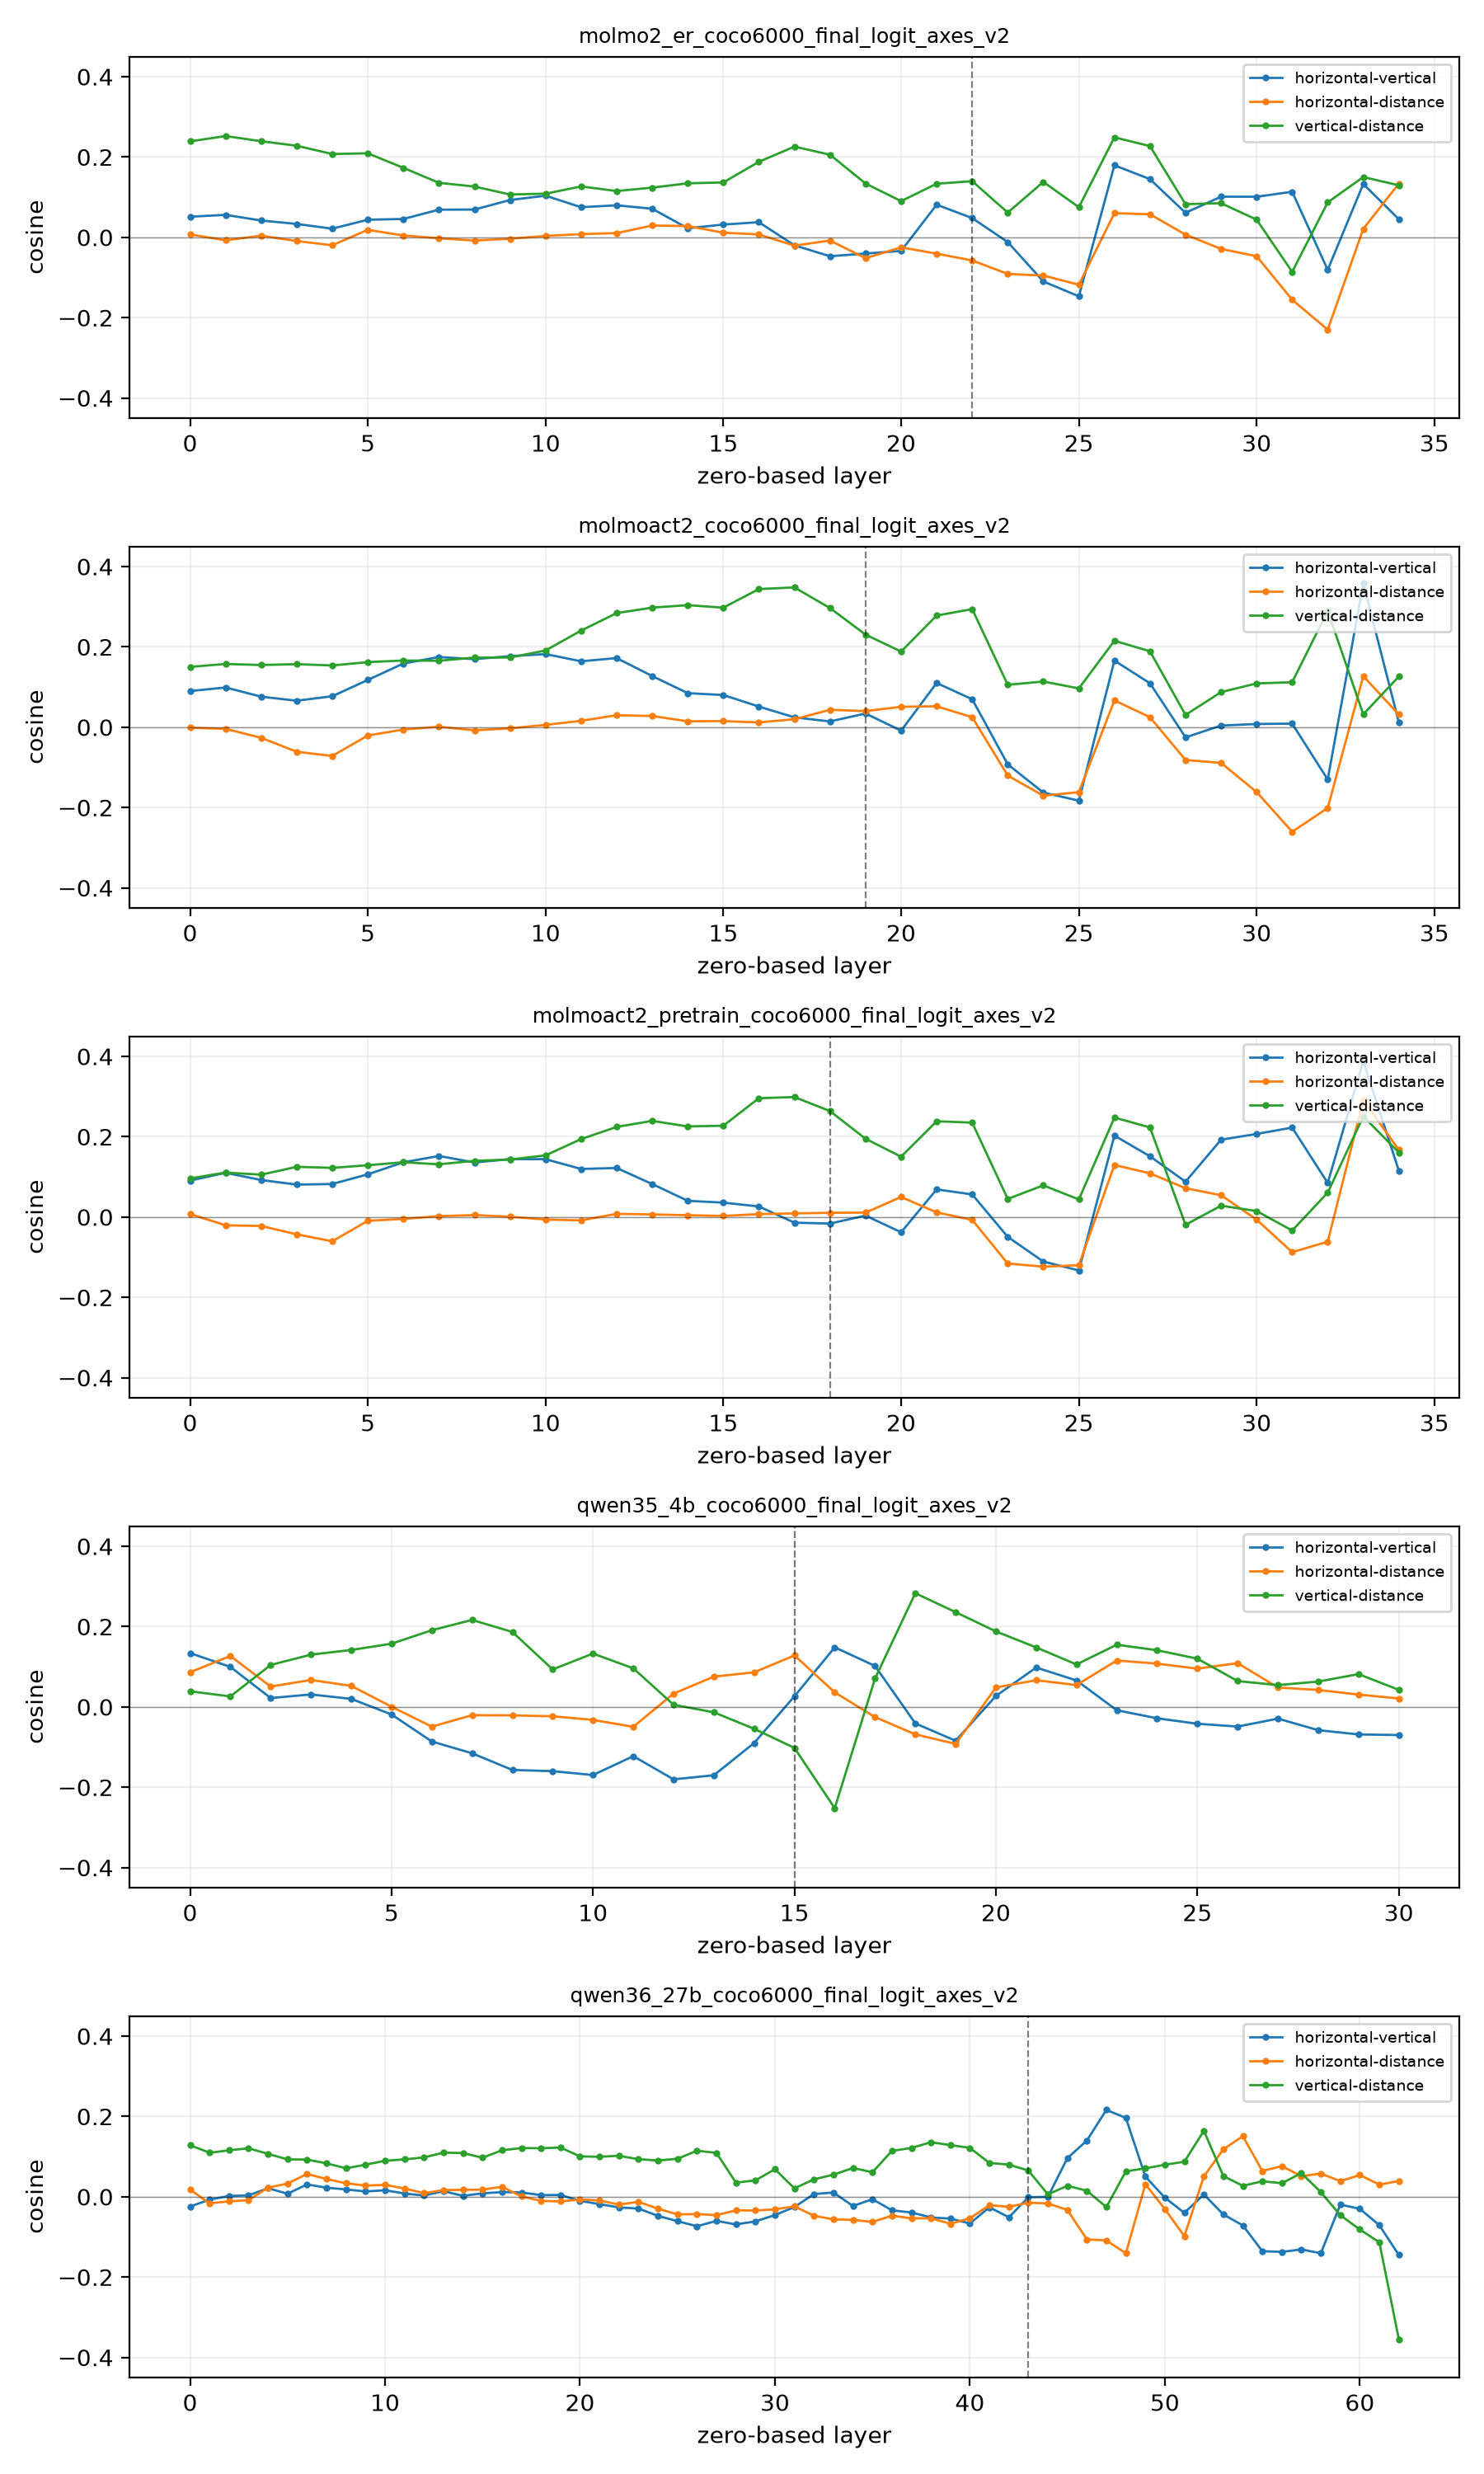
原稿指出:附录 Assumption 1 直接假设空间子空间与其他成分正交,却没有报告 v_x,v_y,v_z 两两夹角;而 SpatialTunnel 的设计动机和文献 [4] 标题都提示自然图像中“远”和“上”可能纠缠。仓库已经发布坐标轴,因此这个检查可以直接做。本版解析 5 个 tensors.safetensors,对作者选层计算余弦和夹角,并对“near-best layers”(COCO-1800 overall accuracy 距最佳不超过 5 个百分点的连续层)取最大绝对余弦。计算文件:references/axis_cosine_report.json。
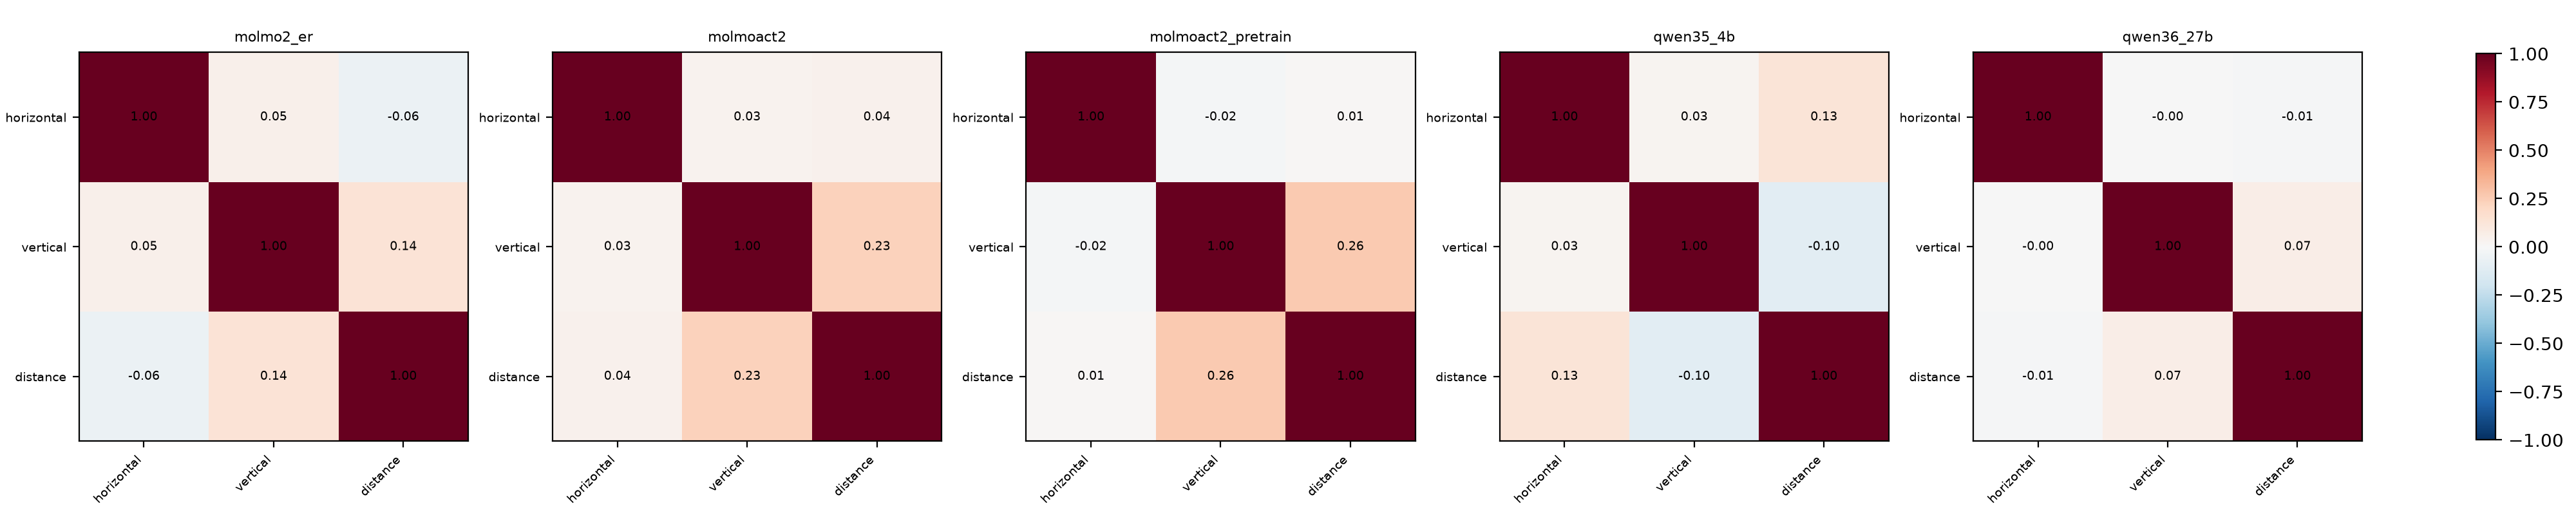
| 模型 artifact | 选层 zero-based | H-V cos | H-D cos | V-D cos | near-best 最大 |V-D| | |---|---:|---:|---:|---:|---:| | Molmo2-ER | 22 | 0.0479 | -0.0575 | 0.1399 | 0.2259 | | MolmoAct2 | 19 | 0.0341 | 0.0401 | 0.2305 | 0.3481 | | MolmoAct2-Pretrain | 18 | -0.0162 | 0.0107 | 0.2639 | 0.2988 | | Qwen3.5-4B | 15 | 0.0266 | 0.1282 | -0.1021 | 0.2520 | | Qwen3.6-27B | 43 | -0.0010 | -0.0148 | 0.0652 | 0.1358 |
解读要分三层:
- 水平—垂直:在五个模型选层上都接近 0,基本满足近似正交。
- 垂直—距离:MolmoAct2 与 MolmoAct2-Pretrain 在选层上分别为 0.2305、0.2639,near-best 最大到 0.3481、0.2988;这不是极端共线,但足以让“沿垂直轴干预完全不影响距离轴”的强特异性叙述需要按模型和层重估。Molmo2-ER 选层 V-D 为 0.1399,问题较小;Qwen3.6-27B 选层只有 0.0652。
- 方法边界:这里计算的是三条独立估计单位轴的余弦,不是子空间之间的 principal angles,也不是对
h^S与h^non-spatial/h^context正交性的直接检验。它能回答“发布的三条轴是否两两正交”,不能完整证明 Assumption 1 的三分解成立。
该实测把原稿的强质疑改成更可执行的结论:不要把 S-Space 默认当作正交三维坐标系;在 Molmo 动作模型上,垂直/距离两轴的耦合应作为干预实验的常规对照,而非附录假设。
5. 证据审计:每个结论到底由什么支撑
| 结论 | 协议与样本 | 报告/仓库证据 | 等级 | 主要替代解释或缺口 |
|---|---|---|---|---|
| 中间层有连续坐标 | COCO 子集;Fig 4 展示 Molmo2-ER L21;读出层另按 COCO-1800 选 | 单物体坐标相关 ρ:H 0.789、V 0.774、D 0.521;成对坐标差相关 ρ:H 0.871、V 0.872、D 0.688 | A | 相关系数来自图注,无逐点置信区间;D 轴明显弱于 H/V |
| 坐标可直接做空间 QA | CV-Bench、EmbSpatial、SpatialTunnel;坐标差符号判定 | Fig 5 文字称与直接回答相当;仓库 manifest 给 COCO-1800 选层准确率 | A- | blog/report 未给完整 benchmark 数值表;SpatialTunnel 是合成去纠缠分布,不能反推自然图像同样干净 |
| 坐标对答案有因果作用 | EmbSpatial;Molmo2-ER;干预 config 扫 α/β,每类 200 | Fig 7:目标判断随 edit scale 降级,非目标空间判断和颜色基本保留,虚线为 50% retention | B+ | 干预方向来自答案 logit 梯度,需随机方向/正交补方向对照;V-D 耦合在动作模型上不可忽略 |
| 不是成对提问格式诱导 | pairwise / single-object / color 三类 prompt;单物体单独前向后比较 | Fig 8 文字称固定 readout 仍准确 | A- | 无完整数值表;但三类 prompt 的计算上下文差异足够大,是全文最能排除“答案缓存”的证据 |
| 多视角下可被 prompt 选择视角 | HStar;固定 “In View 1”,交换两图 | Fig 9:坐标位移与视角变化对齐,三轴高于随机 | B | 只有定性“well above random”,缺数值表和显著性 |
| 画外实体/观察者/语言关系 | 扑救—球、牵引绳—主人、隧道—火车、you token、robot past/toward you | Fig 10:mean coordinate + 95% prompt-template bootstrap CI | C+ | bootstrap 跨模板而非跨场景;不能估计这些能力在真实分布中的频率 |
| 政治左右与物理左右共享结构 | 单张英国下议院图像;固定模板;三身份 token;各模型内 z-score | Fig 11:socialist 偏左、conservative 偏右、moderate 居中 | C | 单图单模板;图像本身带政治左右语义;无中文“左派/右派”或中性抽象概念对照 |
| 方位词耦合导致错误 | Qwen3.6-27B 在 MMSI-Bench 的 CoT 方向词投影 | Fig 12:east→right、north→up、northeast 兼具两分量;配两个错误案例 | B- | 相关链完整,因果链缺最后一步:抹掉方向词图像相对分量后错误率是否下降 |
| 动作监督锐化交互几何 | InstructPart;比较 Molmo2-ER → MolmoAct2-Pretrain → MolmoAct2 | 报告 Fig 13 depth:63.1%→67.1%→69.0%;仓库 README 历史 L18 表显示 H/V/overall 不单调 | B- for depth only | depth 为估计值;缺同规模非动作数据对照;不能外推为“动作监督整体改善 S-Space” |
| 感知强于内部空间运算 | SpinBench without premise;config expected_sample_count=146 |
Molmo2-ER direct 60.96%;S-Space readout+外部旋转 94.52%;Qwen3.6-27B CoT 83.56% | B | 94.52 使用外部旋转矩阵和确定性规则;83.56 与 94.52 不同模型,不能作同模型 CoT 对照 |
| CoT 会逐步旋转 S-Space | Qwen3.6-27B;三阶段 prefilled CoT;重复物体 mention 投影 | 报告 Fig 15;仓库模板写明 label-conditioned / supplied gold-conditioned | C | 模板读取官方答案构造推理链;不能证明自然 CoT 自主完成旋转 |
| 上下文精修 S-Space | SpinBench with-premise;文本 premise 陈述原视角关系 | Fig 16:中间层读出准确率提升,最强层接近满分 | B+ | premise 直接提供原视角关系,信息增量明确;更接近“证据注入后读出更准”,不是模型自主发现 |
6. SpinBench 三个百分数:计数、区间和可引用口径
仓库 SpinBench config 均写 expected_sample_count=146。按百分数反推:
| 指标 | 计数 | 百分数 | 编者计算 Wilson 95% CI | 可引用口径 |
|---|---|---|---|---|
| Molmo2-ER direct | 89/146 | 60.96% | [52.86%, 68.49%] | 同一模型直接生成答案 |
| Molmo2-ER S-Space readout + external rotation | 138/146 | 94.52% | [89.56%, 97.20%] | 同一模型读出坐标后,由外部给定目标视角旋转和确定性规则 |
| Qwen3.6-27B CoT | 122/146 | 83.56% | [76.70%, 88.70%] | 另一模型在 thinking/greedy 32k 协议下的 CoT 结果 |
两点必须写进引用:
- 60.96 → 94.52 的比较是同模型、同 SpinBench without-premise 分布,但后半段把坐标变换外包给确定性规则。它证明“模型中间层包含足以支撑视角转换的坐标信息”,不证明“模型原生推理能完成该变换”。
- 83.56 与 94.52 不是同模型对照。能说的只有:在作者设置下,Qwen3.6-27B 的长 CoT 仍留下错误;不能说“CoT 不如显式计算”已经在同一模型上封闭证明。Fig 14c 的措辞 “where applicable” 也提示 CoT 只适用于部分模型。
样本量只有 146,区间不窄。若后续复现发现 direct 或 projection 各错几题,百分数会明显移动;引用时不应把 94.52 当成稳定常数。
7. CoT 演化实验:代码证据比正文更保守
报告 §6.1 说 “Reasoning progressively transforms S-Space”。仓库两条材料应改变引用强度:
sspace/experiments/spinbench/evolving_cot/scripts/run_qwen36_prefilled_cot_activations.py的 docstring 是 “Teacher-force a fixed SpinBench CoT and capture object-token projections”。记录字段写明decision_protocol=label_conditioned_prefill_activation_intervention_v1。template.py的_relation_wordsdocstring 写明:“This intervention intentionally reads the official answer to instantiate a coherent reasoning path. It is an activation intervention, not an independent accuracy evaluation.” 模板按 observation → viewpoint-integration → completion 三阶段各放一次 object_a/object_b,且 winner/loser 由sample.answer决定。
因此该实验的准确表述是:当把一条按正确答案构造好的三阶段推理文本 teacher-force 进模型后,重复物体 mention 在发布坐标轴上的投影会随阶段向目标视角对齐。它说明语言上下文可以重写 S-Space,且这种重写与正确视角变换同向;它不说明模型在自然生成 CoT 时会自主完成同一变换。原稿已指出 gold-conditioning,本版把它从“警惕”升级为“实验性质定义”:它是 activation intervention,不是 reasoning 能力评测。
要证明作者 §6.1 的强版本,需要至少两组新实验:自然生成 CoT 上追踪相同 mention;用错误答案条件化模板做阴性对照,区分“文本复述答案”与“模型内部旋转”。
8. 动作监督实验:只支持 depth 轴的局部改善
报告 Fig 13 的叙述容易让人记住“动作训练让 S-Space 更准”。仓库 action_supervision/instructpart/README.md 给出更细历史数值:layer 18 上 Molmo2-ER / MolmoAct2-Pretrain / MolmoAct2 的 depth 为 63.07% / 67.11% / 69.02%,但 horizontal 为 82.75% / 78.71% / 78.26%,vertical 为 88.57% / 86.89% / 84.92%,overall 为 78.00% / 77.68% / 77.49%。README 还说明:博客误差棒是十个 prompt 的 Student-t 区间;模型间差异应使用把同一图像十个模板配对的 bootstrap。
结论应收窄为:在 InstructPart 的 part–whole depth 判断上,动作训练链路的 depth readout 单调改善;这不伴随 horizontal/vertical/overall 的同步改善,因此不能概括为动作监督全面提升 S-Space。候选机制仍有多个:动作数据强调可操作部件的深度关系;动作模型训练改变了语言头对 close/far 的使用;数据规模或领域分布差异。现有对照不足以区分。
9. 语言污染:哪些是真机制,哪些只是展示效果
方向耦合(Fig 12)是全文最有诊断价值的语言污染案例。 它把表征结构和错误答案连到同一个参照系混淆:模型已经知道 black box 在 potted plant 的 north,却又把 brown pot 相对 black box 的 right 当成 east,最后答 northeast。S-Space 投影显示方向词在 Qwen3.6-27B 的 CoT 中按地图惯例排布:east 偏右、north 偏上、northeast 同时有水平/垂直分量。缺的一步是干预:将 north/south/east/west token 在 S-Space 水平/垂直平面内的分量投影移除或重定向,再看 MMSI 中 northeast/northwest 类错误是否下降、非方向问题是否不受影响。
政治左右(Fig 11)更适合作为语言—空间共享结构的示例,不适合作为模型认知结论。 协议限制很硬:单张英国下议院图像、固定 prompt、三个身份 token、每个模型内部独立 z-score。它能说明 left/right 的物理义和隐喻义在表征上不是完全分离;不能说明模型把意识形态实体放入物理空间,也不能跨模型比较“谁更政治化”。
you token 的画外观察者定位是三类语言现象里最接近参照系证据的。 如果距离轴正端对应 close,而 you 强投影到 close 端,那么该轴的原点不是图像中心,而是语言引入的观察者。下一步应做跨语言代词、第一/第三人称、明示相机位置三种操纵,检验原点是否稳定跟随“被问及的观察者”。
10. 可复现检查清单
以下检查按成本从低到高排列;前两步不需要 GPU。
- 核对坐标轴端点和夹角:解析
sspace/core/artifacts/pretrained/*/tensors.safetensors与manifest.json。确认positive_endpoints/negative_endpoints/logit_contrasts;重算本版axis_cosine_report.json。若 V-D 耦合在目标模型上超过约 0.2,干预实验必须加轴间泄漏对照。 - 复现 prompt-generalization:运行 README 的
prompt-generalization。若 pairwise → single-object → color 的读出准确率掉到这个检查的噪声范围内,S-Space 的“非答案缓存”证据会变弱。 - 复现 COCO-1800 选层:运行
sspace-construction或直接读取 manifest validation。核对 Molmo2-ER 是否选 L22、三轴准确率是否接近 [0.985,0.9867,0.83]。 - 干预实验加三类对照:随机单位方向、V 的正交补方向、沿非目标轴移动相同范数。通过标准应是:目标轴答案翻转,非目标空间轴和颜色保留,随机/正交补方向不产生同向翻转。
- SpinBench 重算计数:用 config 的
expected_sample_count=146和输出逐样本结果核对 89/138/122;报告 Wilson 区间,不只报百分数。 - CoT 去答案条件化:自然生成 CoT、正确答案条件化模板、错误答案条件化模板三组对照。只有自然 CoT 也呈现阶段式坐标旋转,才能恢复 §6.1 的强表述。
- 方向耦合闭环:对方向词 token 做水平/垂直分量擦除,观察 MMSI 方位错误率和非方向任务退化。
11. 工程使用边界
可以用的部分:
- 把“先读坐标,再决定补感知还是补运算”加入空间任务排障。若坐标读出错,问题在视觉绑定或层选择;若坐标读对而视角转换错,问题更可能在后续运算/参照系管理。
- 把角色反对称 Jacobian 当作零训练方向探针,迁移到时间、数量、大小、价格、情绪强度等有序属性。迁移时保留三重去噪:角色作差、模板平均、顺序对调;并重新检查端点词频率和轴间夹角。
- 在低资源场景用发布坐标轴做诊断,不必重建轴;但坐标轴是模型相关、层相关、端点协议相关的,不能跨模型复用。
不要直接用的部分:
- 不要把读出坐标当世界坐标或度量深度。报告脚注明确:水平/垂直是图像平面坐标,未解耦透视;深度更接近相对序。
- 不要把 94.52% 当模型能力上限或下限。它是“感知读出 + 外部几何运算”的混合管线成绩。
- 不要在低容量 LoRA/冻结层场景默认 S-Space 仍稳定。发布轴来自全模型中间层;参数高效微调是否保持该结构,需要单独验证。
12. 本版新增文件与计算口径
references/s-space-report.pdf/references/s-space-report.txt:MirroS technical report,2026-09-07,18 页。- 代码来源与恢复说明:本地
references/S-Space-repo为 GitHub 浅克隆,commit489f151e720e9ddb69c0617544cc0f7d5eabcbc3。 references/axis_cosine_report.json:本版用 NumPy 解析 safetensors 后计算的三轴余弦、夹角、选层指标、near-best 层范围。near-best 定义为 COCO-1800 overall accuracy 不低于最佳值减 5 个百分点。analysis-assets/axis_cosine_selected_layers.png:五套发布轴在作者选层上的两两余弦热图。analysis-assets/axis_cosine_by_layer.png:三轴余弦随层变化曲线,虚线为作者选层。- Wilson 区间为编者按
x/146计算,非论文报告值。
13. 仍待核实
- SpinBench direct/projection/CoT 的官方逐样本输出未在浅克隆仓库根目录直接找到;本版计数由 config 的
expected_sample_count=146与报告百分数反推,复现前应运行对应 config 确认。 - Fig 5、Fig 8、Fig 9、Fig 16 的完整数值表和显著性检验未公开;当前只能按图注和文字定级。
- 报告 Fig 4 使用 L21,artifact readout 选择 L22;需要阅读
object_coordinates与sspace-construction输出确认二者的角色划分,避免把展示层和选层层号混写。 - 坐标轴的尺度跨场景可比性未验证。若同一物体在不同图像中的坐标尺度不可比,S-Space 更接近逐图局部坐标系,而不是全局一致地图。