《S-Space: Exploring Spatial Workspace in Multimodal Models》精读笔记
这项工作在多模态模型的中间层激活里找到一个三维线性子空间(S-Space),物体的左右、上下、远近以连续坐标写在物体名词的 token 上,可以读出,也可以通过干预改变模型的判断。它真正想说的是另一件事:模型的空间感知已经相当不错,弱的是感知之后的几何运算。这个结论有成立条件。坐标轴是从答案 logit 的梯度反推的,水平和垂直用的是图像平面坐标而非世界坐标,所以严格说它刻画的是一个 2.5D 的、任务定向的表征,离完整的三维世界模型还有距离。
| 项目 | 信息 |
|---|---|
| 标题 | S-Space: Exploring Spatial Workspace in Multimodal Models |
| 作者 | MirroS Team(代码仓库当前唯一贡献者署名 Jialong Wu) |
| 来源 | MirroS 官方 Research Insight(blog,含数学附录),2026-09-08 |
| 链接 | https://mirros.ai/blog/s-space ;代码 https://github.com/MirroS-Lab/S-Space (Apache-2.0) |
| 类型 | 机制可解释性实验研究 |
| 阅读重点 | 机制、证据强度、可信边界、可复用性 |
一、先给结论
它解决的是什么问题
模型答对「杯子在书的左边」,从输出看不出它靠的是什么:可能是记住了某个局部视觉模式,可能是语言先验(某类物体在训练数据里总出现在左侧),也可能是真的在内部搭出了场景的空间布局。三种机制的外部表现一模一样,但对下一步的指示完全不同。前两种意味着要补数据,第三种意味着感知没问题,该修的是后面的运算环节。
这篇论文给了区分三者的办法,答案落在第三种,并且量化了感知和运算之间的落差:SpinBench 视角转换任务上,Molmo2-ER 直接作答只有 60.96%,把坐标从 S-Space 读出来、旋转矩阵和判定规则由外部给定之后,能到 94.52%。需要的信息模型内部本来就有,是内部计算把它浪费了。
解决程度要分开说:表征的存在性和因果作用证据扎实;表征怎么从训练中长出来(§4)、推理时怎么动态变化(§6),这两块目前是相关性证据,因果没有分离干净。
三个主要判断
-
真正的新意有三层,按重要性排:提出感知—计算解耦这个诊断框架(思想价值最高);用角色反对称 Jacobian 提取语义方向,这个探针不需要训练、不需要坐标标注(工程价值最高);用干预实验把「能读出」推进到「因果参与」。「发现模型有空间表征」本身反而是最不新的部分。
-
全文最有分量的证据是 §3.3 的跨提问格式实验(Fig 8),不是传播最广的 94.52%。原因第四节展开:只有这组实验能排除「S-Space 只是答案缓存」这个替代解释。
-
边界有三层。方法上,方向从答案 logit 梯度反推,和「模型自发维护一张地图」之间还有没跨过去的距离。几何上,作者脚注自承水平垂直是图像平面坐标、透视未解耦,「3D」是宽松说法。形态上,这是 blog 不是完整论文,除三个关键百分数外没有数值表、样本量和显著性检验可核对。
值不值得用
值得引用和跟进,探针方法可以直接拿来用,但引用时要带上限定。
- 做空间或具身智能的,这个诊断框架可以直接进工作流:加数据之前先测中间层读出的坐标对不对,坐标对了还答错,就别再灌感知数据,去补外部几何运算。
- 做可解释性的,角色反对称 Jacobian 值得当方法基线。
- 想拿它做强结论的要克制,尤其是 socialist 映射到左侧、94.52% 这两处,最容易被转述过头。
- 复现门槛比同类工作低:代码和预提取的坐标轴都放出来了,但需要 CUDA 主机和三套模型环境。
二、论文全貌
背景和缺口
作者先借神经科学起头:人对空间的理解靠两套系统配合,顶叶后部追踪物体相对自己的位置,海马系统在移动中把不同视角整合成较稳定的地图。人脑中的空间表征不是照片,而是一份可以操作的内部几何——能换视角想象同一个房间,能在心里挪动物体。论文由此立论:空间理解的核心是构造一个可操纵的工作区,物体绑定位置,关系可以维持、变换、供推理调用。
现有研究的缺口在「可操纵」这半边。空间问答的准确率评测都是行为指标,区分不了机制。团队自己的前作在 2D 网格世界里观察到隐状态会追踪实体坐标,而且这些坐标从没出现在推理链文本里(Fig 2b-c),说明有一个不经语言表达的内部状态。2D 网格世界太干净,离真实场景远,本文要把这件事推到三维真实图像上。
作者声称的贡献,和实际能确认的贡献
| 作者表述 | 深读后能确认的范围 |
|---|---|
| 模型内部携带空间世界地图 | 中间层确有线性可读的三维坐标结构,连续相关、可干预、跨提问格式稳定。「地图」是合适的隐喻但别按字面理解:没有证据表明它有全局一致性,也不知道能否跨场景复用 |
| 编码连续 3D 位置 | 连续性有实证(Fig 4 同时验证单物体坐标和成对坐标差)。但应读作「图像平面 x、y 加相对深度序」,作者脚注 2 自承透视未解耦 |
| 超出可见范围 | 现象成立,证据是少量案例加模板 bootstrap 置信区间,不是统计结论 |
| 知道位置却不会推理 | 成立,也是最有价值的判断。但 94.52% 里旋转和规则是外部给的,不代表模型内在有这个水平 |
| 工作区会在测试时演化 | 上下文精修(§6.2)较可靠;推理内部变换(§6.1)证据偏弱,见第五节 |
论证结构
七节是一条递进链,每节都在回应上一节留下的质疑,这个设计比多数可解释性论文讲究:
- §3.1 先证明读得出,且与真值连续相关;
- §3.2 回应「读得出不等于模型在用」,做干预;
- §3.3 回应「会不会是探针自己制造的假象」,换提问格式;
- §3.4 回应「是不是只是检测框缓存」,测画外物体和语言蕴含的关系;
- §4 追问表征从训练的哪里来;
- §5 追问既然有表征为什么还答错;
- §6 追问这个表征是死的还是活的。
判断这篇论文成色,主要看 Fig 8(跨格式泛化)、Fig 7(干预特异性)和附录 A(算法假设)、Fig 17(层间鲁棒性)。Fig 5 的答题准确率和 Fig 11 的政治光谱传播度最高,但判别力反而有限。
三、研究故事
问题的起点是外部行为无法区分内部机制。前作只在 2D 网格世界看到线索。本文的核心洞察带一点必然性:模型要预测 left、right 这类空间词,就必须把实体绑定到相对位置,并且让语言头访问得到,这个预训练压力不需要任何显式坐标监督,就足以把激活组织成稳定的空间轴。同一套压力也会把语言自身的结构带进来,包括隐喻和参照系冲突,这解释了 §4 那些「污染」现象为什么会出现。
方法上,用答案 logit 对两个物体 token 的梯度差提取三条方向,再用连续相关、因果干预、跨格式泛化、画外补全逐层验证,最后落到感知与计算的落差,以及测试时的演化。
链条里有一处跳步,在 §4。语言监督和动作监督被并列为塑造 S-Space 的两种模态,但证据类型对不上:语言侧观察到的是表征结构(socialist 落在左边、east 对齐右边),动作侧靠的是 VLM 到 VLA 三个检查点的性能递进。后者要证明「是动作监督起了作用」,得排除数据规模和领域分布的混杂,而这个对照实验没做。所以 §4 标题问的是「如何形成」(因果问题),实际交付的是相关性。
四、方法拆解
基本假设
物体名词最后一个 token 的隐状态 里线性混入了它在观察者中心参照系下的坐标,存在三条单位方向:
三条方向张成的子空间就是 S-Space,正方向分别是 right、up、close。选中间层是因为早期层贴近输入,后期层已经对齐语言输出,中间层才处于「感知完成、表达未开始」的状态。
方向怎么求
分四步。
先造对比题:从未裁剪 COCO 取 6000 个物体对,每条轴 2000 对,每对在对应轴上有清晰序关系,提问如「Is the apple to the left or right of the cup?」,apple 是 query,cup 是 reference。
再定义答案对比量,取端点 token 的 logit 差:
然后反传到两个物体 token,做角色反对称化:
最后在 6000 对、5 个模板、2 种物体顺序(共 10 种配置)上平均、归一化,得到 。
附录用两条假设说明这套操作为什么成立。Assumption 1 把隐状态拆成相互正交的三块:空间成分、非空间属性(身份外观功能)、上下文成分(问题语义和措辞)。Assumption 2 规定:空间成分在 query 和 reference 互换时变号,非空间属性对空间答案梯度为零,角色不对称的上下文效应在期望下抵消。于是作差消掉两物体共享的部分,模板平均消掉措辞偏置,顺序对调消掉位置偏置,期望意义下留下的就是空间雅可比。
这套方法便宜的地方在于:不训练 probe(没有 probe 过拟合问题),不需要数值坐标标注(只要「谁在谁左边」这种序关系),一次前向一次反向就够。它几乎可以原样搬到任何有序连续属性上:时间、数量、大小、温度、价格、情绪强度。就可迁移性而言,这个范式比 S-Space 这个具体发现更值钱。
三个软处
第一,循环性。 方向是从「对答案 logit 有影响的方向」反推的,那么「用读出的坐标回答空间问题准确率高」(Fig 5)在同分布上接近自证:提取的本来就是最能左右答案的方向。这个批评如果成立是致命的,化解它靠三条彼此独立的侧证:
- Fig 4 的连续性。坐标值和真值连续相关,单物体坐标和成对坐标差都相关。答案对比量只含二元信息,解释不了连续标度。
- OOD 泛化。EmbSpatial-Bench、SpatialTunnel 不在提取分布内,读出仍然有效。
- Fig 8 的跨格式泛化。换成单物体提问,每个物体单独前向、事后才比较;甚至换成纯颜色提问,模型完全没有生成空间答案的压力,坐标依然在。
第三条最关键。颜色提问下坐标还在,说明它不是答案计算的临时缓存,更接近物体表征本身的固有组织。这是全文的承重墙,判别力高于 94.52%。
第二,正交性被假设但没检验。 Assumption 1 直接假定三个子空间相互正交,可文中有两个信号指向相反方向:引入 SpatialTunnel 的理由写明是消除自然图像里的垂直—距离纠缠;参考文献 [4] 的标题就叫《Why Far Looks Up》,远处的物体在图像里显得更高,这是透视的必然。两条线索都说明 和 在自然图像上应该部分共线。而报告三条方向的夹角几乎零成本,用已发布的预训练轴就能算。这个自检缺失,影响不小:如果三轴显著非正交,「三维子空间」要改叫「二维流形加一条纠缠的深度分量」,沿 的干预也会顺带改动 ,Fig 7 的特异性结论要重估。
第三,垂直轴的词对不对称。 附录 A.1 里垂直轴用的是 。up 和 below 不是对称词对,对称的写法应是 above/below 或 up/down。两者语料频率、句法角色(副词对介词)、搭配都不同,可能混入与空间无关的词汇偏置。文中没有替代词对的消融。这是读附录才看得到的细节,不致命,但三条轴里垂直轴的可信度该单独下调一档。
Jacobian 是怎么把空间方向算出来的(数值图解)
附录的 Jacobian 容易被符号吓住,用一个能手算的小例子就能走完。下面三张图是为讲解自绘的示意:把模型的几千维压到 4 维、再投影到纸面 2 维,图中数字是教学示例,不是论文实测值;论文的真实规模是 6000 个物体对、约 6 万个配置。
先说 Jacobian 本身。对向量值函数 ,它是一个 矩阵,第 个元素是第 个输出对第 个输入的偏导,回答「输入轻微一动,每个输出怎么变」。本文的输出是答案 logit 差 ,一个标量(),Jacobian 因此只剩一行,退化为 对物体 token 隐状态的普通梯度 ,一个 维向量。它的几何含义是:在隐状态空间里沿这个方向轻推 ,「右减左」的答案差增加得最快。
搭一个 4 维小世界。设隐状态 ,第 1 维 编码水平位置(右为正),后三维是身份、颜色、上下文,真正的空间方向是 (我们假装不知道,要把它算出来)。再设模型内部 ,系数 2 只是放大倍数。
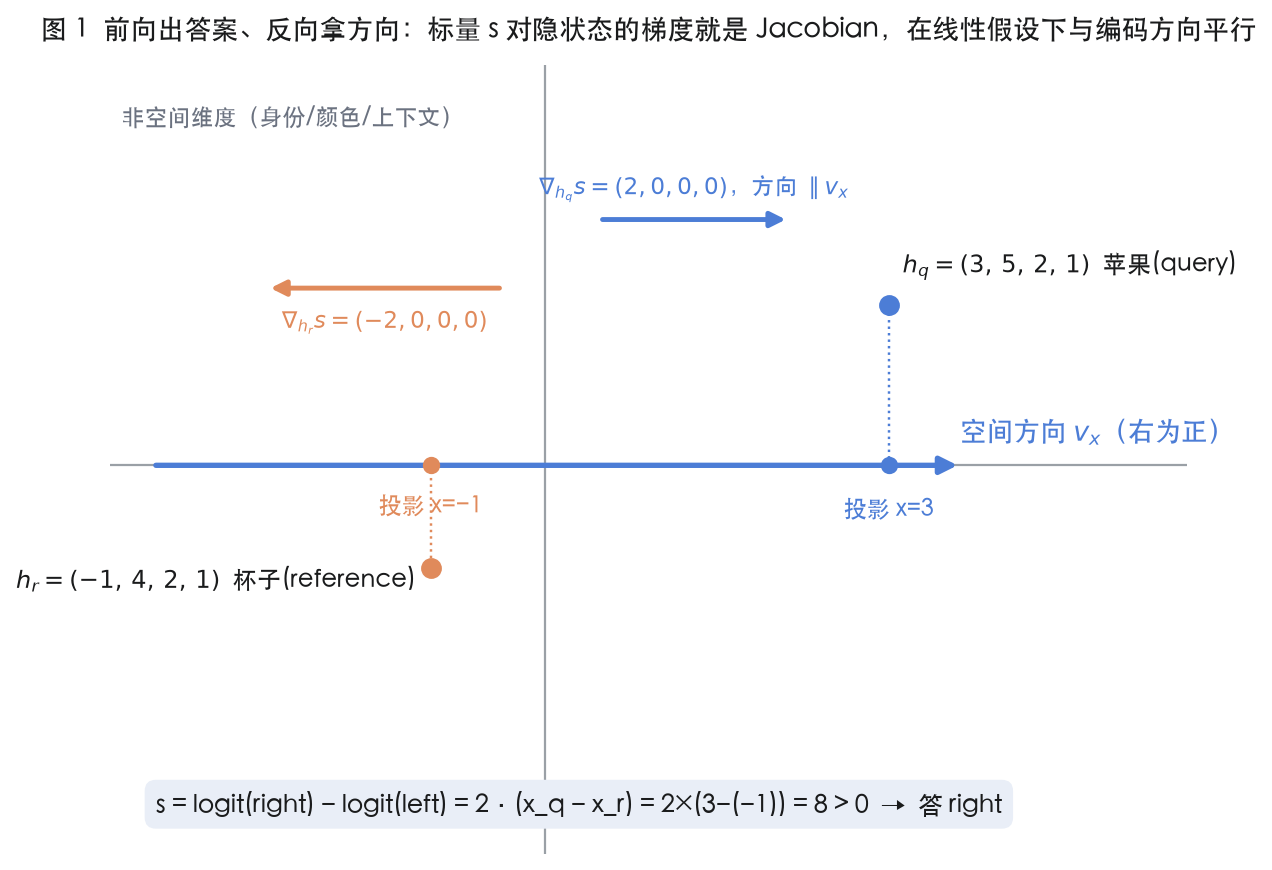
图 1 同时走前向和反向。苹果 、杯子 ,前向 ,答 right。反向得到 、。前一个念出来是「苹果第 1 维每加 1, 加 2;其他三维怎么动 都不变」,归一化(除以长度 2)后正好是 。这是链式法则的必然:坐标 ,而 是 的线性函数,梯度方向必然平行 。杯子一侧带负号,因为杯子越靠右,「苹果在杯子右边」越不成立。一次反传就能拿到方向,不需要坐标标注,也不需要梯度下降训练探针,原理就在这里。
真实网络的梯度会漏到非空间维上,要洗两遍。
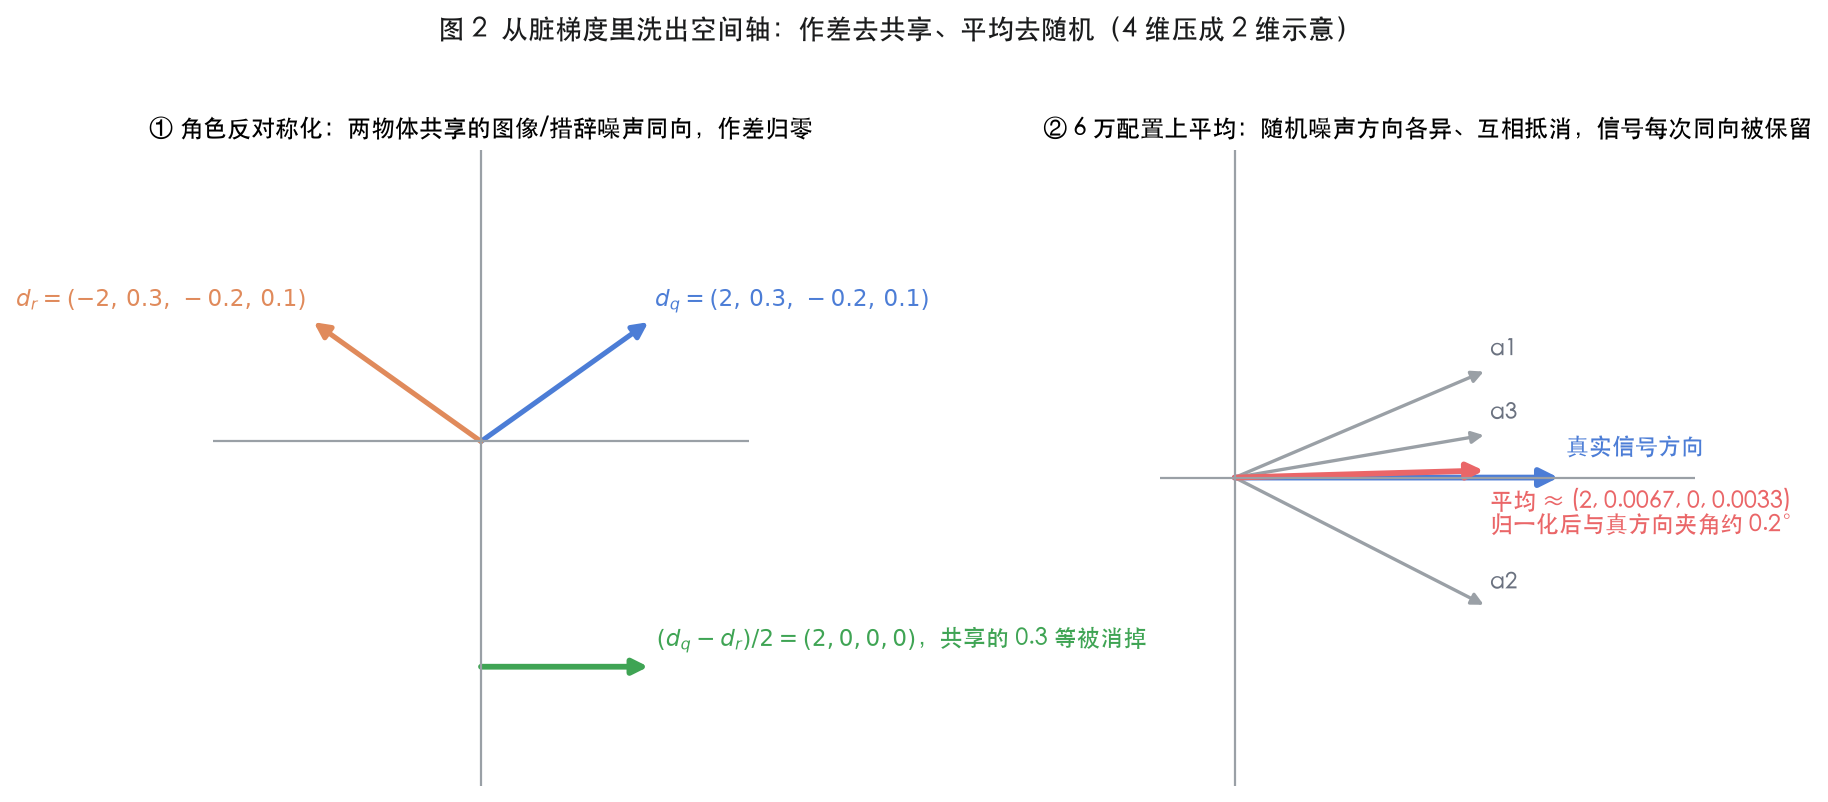
第一遍是角色反对称化(图 2 左)。设苹果梯度 ,杯子 ,多出来的 0.3 等小尾巴来自同一张图、同一种问法,对两个物体相同。作差除以 2:,共享尾巴逐项抵消,空间分量翻倍后被还原。第二遍是跨配置平均(图 2 右)。作差后还剩随机抖动,三个样本 、、 的第 1 维每次都是 2(信号同向),其他维正负乱跳(噪声随机);平均后得到 ,归一化后与真方向的夹角只有约 0.2 度。论文用 5 个模板、2 种物体顺序、6000 对把平均做到约 6 万次,连措辞偏置都变成可抵消的随机项。除以 2 只是让结果在形式上等于 query 侧的空间梯度,因为最后要归一化,不除也不影响方向。
方向拿到之后,读和改都沿它进行。
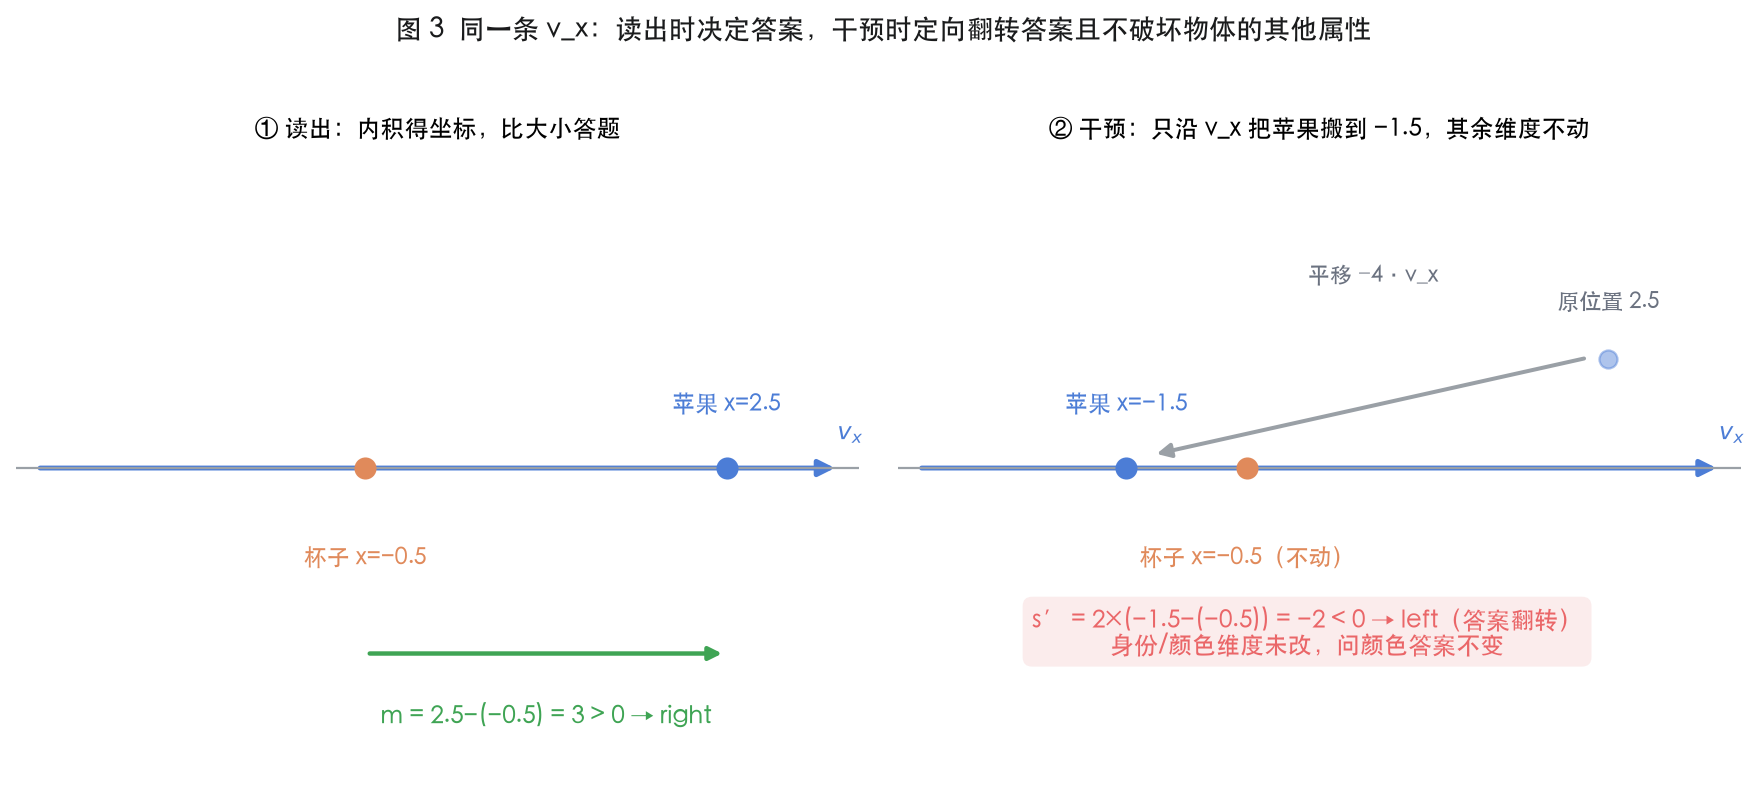
读出(图 3 左)就是内积:新样本苹果 、杯子 , 判 right;身份维的差异(6 对 4)垂直于 ,被自动无视。干预(图 3 右)是把苹果沿 平移 −4,从 2.5 搬到 −1.5,写成 ,只改第 1 维、后三维不动;重算 ,答案翻成 left,而问颜色时颜色维没动,答案不变。这就是 Fig 7「干预有特异性」的最小数值版本。
三个实现细节顺带说清。用 logit 差而不是 softmax 概率,因为概率的梯度带饱和项,模型很自信时梯度趋近零,方向测不准。梯度长度受系数影响、跨样本不稳定,但朝向稳定,所以统一归一化成单位向量,坐标尺度事后标定。最后,这条路线的软肋前面已经点过:方向从答案反推,天然绑定答案通路,所以要靠 Fig 8 的颜色提问等侧证证明它不是答案缓存(见本部分「三个软处」第一点)。
五、证据与实验
结论—证据对照
| 结论 | 决定性证据 | 判断 | 边界 |
|---|---|---|---|
| 编码连续坐标 | Fig 4,Molmo2-ER 第 21 层,单物体坐标与成对坐标差均与真值相关 | 强 | 水平垂直为图像平面坐标,深度是相对序 |
| 对输出有因果作用 | Fig 7,沿目标轴移入反事实坐标,答案按预期翻转;颜色判断和非目标轴基本不变(50% 保留线)。干预在 EmbSpatial 上做(据代码仓库) | 中偏强 | 干预方向来自答案 logit 梯度,无法完全排除「直接推高答案 logit」的成分 |
| 不是探针诱导的 | Fig 8,成对/单物体/非空间三类提问都成立 | 强 | — |
| 层选择鲁棒 | Fig 17,每层独立构建,1800 例 COCO 验证集上中间层有连续高准确率区间 | 强 | 首尾层明显下降,须取中间层 |
| 可被语言引导到指定视角 | Fig 9,固定「In View 1」交换两图,坐标位移跟随视角,三轴均高于随机。代码显示用 HStar 数据集 | 中偏强 | 提取只用单视角样本,多视角属泛化验证 |
| 定位画外实体、放置不可见观察者 | Fig 10:扑救方向上的球、牵引绳外的主人、隧道深处的火车;you 投影到距离轴 close 端;「经过你」改「朝你移动」反转 you 的深度而机器人不动 | 现象成立,统计不足 | 少量案例加模板 bootstrap,无样本量和检验 |
| 感知优于计算 | §5.1,Molmo2-ER 直接 60.96% 对读出加外部旋转 94.52%(SpinBench) | 中 | 旋转矩阵和判定规则外部给定,详见下文 |
| CoT 补不齐空间运算 | §5.1,Qwen3.6-27B 带 CoT 为 83.56%,仍有错 | 弱到中 | 与 94.52% 不是同一模型,详见下文 |
| 方位词与图像相对方向耦合致错 | Fig 12,Qwen3.6-27B 在 MMSI-Bench 的 CoT 方位词坐标:east 对齐右、north 对齐上、northeast 兼具两分量;对应错误是已定 north 还把「偏右」当 east 答成 northeast | 相关性成立,因果未闭环 | 缺干预实验 |
| 动作监督锐化交互几何 | Fig 13,Molmo2-ER → MolmoAct2-Pretrain → MolmoAct2 在 InstructPart 上部件—整体深度判断递进改善 | 弱到中 | 深度是估计值;缺同量非动作数据对照 |
| 上下文精修 S-Space | Fig 16,SpinBench with-premise 下逐层读出精度提升,最强层接近满分 | 中偏强 | premise 直接陈述了原视角关系,信息增量明确 |
两个百分数要小心读
60.96% 到 94.52% 的落差里,目标视角的旋转矩阵和判定规则都是外部给的,模型只负责感知。它证明的是「感知信息够用,任务一旦被外部分解就能做对」,不能读成「模型内部本来就有 94.5% 的视角转换能力」。作者原文措辞是克制的(when the required coordinate transformation is performed proficiently),浓缩成 takeaway 之后这个前提容易丢。
83.56% 和 94.52% 并置也有问题:前者是 Qwen3.6-27B 带 CoT,后者是 Molmo2-ER 读出加旋转,不是同一个模型。正文相邻叙述,读起来像「CoT 不如显式计算」的同模型对照,严格说不成立。Fig 14c 写的是「substantially outperforms direct generation and, where applicable, chain-of-thought」,where applicable 暗示只有部分模型支持 CoT,同模型对照可能在图里,但 blog 没给数值。引用「CoT 补不齐运算」时要说明同模型证据未公开数值。
几处反直觉的结果
几何延伸到不可见对象(§3.4)是概念上最精彩的部分。扑救动作推断画外的球、绷紧的牵引绳推断狗之外的主人、铁轨推断隧道深处的火车,说明 S-Space 会从动作、物理关系和场景几何补全世界,而不只是登记检测到的物体。
其中理论分量最重的是 you 的行为。问「farther from or closer to you」时,you 这个 token 极强地投影到距离轴的 close 端。这意味着距离轴编码的实际是「到观察者的距离」,观察者就是轴的原点,哪怕它从没出现在图里。这是自我中心参照系在表征层面的证据,比行为正确率深一层。「经过你」改成「朝你移动」后 you 的相对深度反转、机器人位置不动,是同一结论的操纵性佐证。
传播最广但证明力最弱的是 socialist 落在物理左侧(Fig 11)。限制很多:单张英国下议院图像,而图像本身的席位布局就带左右政治语义;固定模板;各模型内部独立 z-score;没有样本量、没有跨图像和跨语言对照(比如中文「左派」)、没有中性概念对照。作者自己限定了「不代表模型字面地把意识形态放进物理空间」。合适的读法是:物理义和隐喻义共享了一部分表征结构。
诊断价值最高的是方位耦合(Fig 12),这是全文唯一把表征结构和具体错误连起来的分析。但它停在相关性:看到了 north/up、east/right 的对齐,也看到了对应的错,中间差一步干预。实验其实很直接:抹掉 north token 的水平分量,看 northeast 类错误降不降。这是全文性价比最高的空缺实验。
代码仓库暴露的一处折扣
§6.1 说 CoT 展开时坐标逐步转向目标视角。仓库 README 对该实验的原话是跟踪「supplied, gold-conditioned reasoning template」。比正文更透明,也更需要警惕:推理链不仅是外部构造的(正文已说是 formulated CoT,固定经过原关系、目标视角、变换后关系三阶段),还以正确答案为条件。那么观察到的坐标旋转,有多少是模型自己的心理旋转,有多少是模板文本直接灌进去的,就分不清了。「reasoning progressively transforms S-Space」在这个条件下说强了。要证明模型自主旋转,必须在模型自然生成、未经答案条件化的 CoT 上重做。这是我对全文最实质的一条意见。
六、可信度、局限与复现
可以放心接受的部分
三块证据互相独立、失败模式不同,很难被同一个混杂同时解释:中间层存在线性可读、连续、跨格式稳定且层选择鲁棒的坐标结构(Fig 4、8、17);干预对空间输出有轴向和语义特异的因果影响,颜色判断不动(Fig 7);补充多模态上下文能精修它(Fig 16,干预和效应都明确)。
按影响程度排的问题
会动摇主要结论的:三轴正交性未检验(关系到「三维子空间」的刻画和干预特异性);干预方向与答案梯度同源(关系到因果解释强度);§6.1 的 gold-conditioned 模板(关系到「推理内部旋转」能否成立)。
限制适用范围的:图像平面坐标(度量场景不可用)、深度只有相对序、up/below 词对不对称、§4.2 缺对照。
不影响主结论但该知道的:没有随机方向 baseline,没有非线性 probe 对照,也没有排除「直接用视觉编码器 patch 位置做线性探测」这个更简单的替代解释;遮挡、镜像、俯拍等非自然视角的表现未报告;COCO 6000 对「清晰序关系」的筛选标准没写细,是个隐性调参点。
局限分三类
作者自己承认的:脚注 2 的图像平面坐标与透视未解耦;脚注 1 的参照系可被上下文引导、在 CoT 中重定向;§6.1 承认内部变换 imperfect;§4.1 对政治语义对齐和方位耦合成因都用了留有余地的措辞(does not necessarily、we suspect)。
我基于证据推断的(非原文):由 SpatialTunnel 的设计动机和文献 [4] 标题推断 、 在自然图像上应显著相关;up/below 不对称可能引入词汇偏置;感知—计算落差的幅度依赖外部给定的运算,无法据此估计模型内在上限;gold-conditioned 模板存在信息泄漏路径。
目前无法确认的:各图具体数值、样本量和检验(blog 形态所限,图注是主要来源,未标注的数值不做推测);配套技术报告的内容范围,第三方报道给出的报告链接指向 code-as-world.pdf,而 Code-as-World 从描述看是该团队另一项「视频重写为 MuJoCo 程序」的工作,链接是否为报道笔误未能核实;干预效果能否迁移到自由描述或下游任务;S-Space 有无跨场景全局一致性。
复现条件
门槛低于同类工作。代码 Apache-2.0,预提取坐标轴已发布(sspace/core/artifacts/pretrained/),评测可直接复用,重建轴可选;十个实验的脚本和配置齐全,覆盖 Molmo2-ER、MolmoAct2-Pretrain、MolmoAct2、Qwen3.5-4B、Qwen3.6-27B。选 Molmo2-ER 当主模型是合理的,它完全开放、训练配方透明,做「训练如何塑造表征」这类问题必须有这个条件。
实际要注意:需要 CUDA 主机和 uv,安装脚本建三套互不兼容的环境,Qwen3.6-27B 的显存开销大;坐标轴必须逐模型提取,不能迁移;仓库目前 3 次提交、单人、无 release tag,成熟度早期;数据集要备 COCO、SpatialTunnel、EmbSpatial、CV-Bench、SpinBench、HStar,MMSI 和 InstructPart 另备;干预要扫 edit scale,效应对它敏感。
最小验证路径,按性价比排:
- 先复现 Fig 8 的跨格式泛化(跑 prompt-generalization 即可,不需要干预代码)。这步不过,后面都不用做。
- 用已发布的轴算 、、 两两余弦相似度,几乎零成本,直接检验最关键的未验证假设。
- 加随机方向和正交补方向的干预对照,压住「梯度方向天然影响 logit」的替代解释。
- 在自然生成的 CoT 上重做 §6.1,去掉 gold-conditioning。
- 给 Fig 12 补因果闭环:抹掉方位词的图像相对分量,看错误率。
七、可以拿走什么
值得复用
角色反对称 Jacobian 探针:零训练、只要成对序关系,三重去噪(角色作差、模板平均、顺序对调)要保留,可直接迁移到其他连续属性。
感知—计算解耦的诊断流程:空间任务排障时先测读出坐标是否正确,再决定修感知还是接运算,这个判断可能直接改变投入方向。
干预实验配特异性对照:不只证明改动有效,还证明颜色判断和非目标轴不动,这个做法值得当因果实验的标配。
用第二人称代词定位参照系原点:you 探针是个巧妙设计,可用于检验任何模型是否维护自我中心参照系。
不能照搬
读出坐标不能当度量三维位置用,水平垂直是图像平面的,深度是相对序,抓取导航这类要真实距离的场景不行;坐标轴不能跨模型复用;94.52% 不能当模型能力引用;§4 的两个「监督塑造表征」目前是解释不是因果;垂直轴在词对和纠缠问题澄清前别做强推断。
它在文献里的位置
三条线索交汇:线性表征假设(ref 3、20,提供方法前提)、柏拉图表征假设(ref 10,提供多模态收敛到共享结构的解释)、Anthropic 关于可言语化表征构成全局工作区的工作(ref 19,Jacobian 定义的直接来源,也是「工作区」概念的来源)。相对前作的增量是四点:2D 网格推进到真实图像、加入因果干预、提出感知—计算解耦、考察测试时动态性。
「工作区」这个用词比「世界模型」谨慎,也更贴合证据:能读写、可操作、临时性,不承诺完整性和全局一致性。目前看到的更像一份可读写的暂存结构,而不是持久的全局地图。
后续问题
都从本文的机制或失效处直接推出:
- 三轴正交吗?如果 、 显著相关,「远看起来像高」的透视混杂是不是垂直判断错误的机制来源?训练中显式解耦透视能否同时改善两轴?
- 干预效果能迁移多远?改坐标后让模型自由描述,它会不会自发说出改后的位置?多轮里是否持续?只在被干预的题上有效的话,「工作区」要收窄成「答案通路上的中间量」。
- 方位耦合能否定向消除?抹除方位词的图像相对分量能否降低 northeast 类错误而不伤其他能力,这是把可解释性发现转成能力改进的最短路径。
- 自然 CoT 真的会旋转 S-Space 吗?去掉 gold-conditioning 重做,答案为否的话,「内部心理旋转」要撤回,感知—计算解耦反而更硬。
- §4.2 里起作用的到底是动作监督还是更多数据?需要同规模非动作微调对照。
- S-Space 有全局一致性吗?同一物体在不同图像里的坐标标度可比吗?不可比的话它只是逐图标定的局部坐标系,能支撑的下游运算要重新评估。
- 能否把 S-Space 做成显式接口:模型把坐标写到结构化槽位,外部几何引擎处理后读回,这正是作者 §7 和 ref 17 指向的 agentic spatial reasoning 的具体形态。
行动顺序
- 现在就能做:把「先测读出坐标」纳入自己空间任务的排障流程;引用三个百分数时带上第五节的限定。
- 一周内:拉仓库,用预训练轴复现 prompt-generalization,顺手算三轴余弦相似度。
- 再往后:跨格式泛化成立且三轴大致正交,就把探针迁移到自己关心的连续属性;做空间系统的,试「读出加外部运算」的混合架构,和端到端方案在视角转换任务上对比。
八、阅读范围说明
材料:mirros.ai/blog/s-space 全文 30,680 字符,分两次完整读取,覆盖第 1–7 节、20 条参考文献、BibTeX、附录 A(记号、两条假设、识别算法、五个模板、读出算法)和附录 B(层间鲁棒性)。另读了 GitHub 仓库 MirroS-Lab/S-Space 的 README,用于核对数据集归属、实验配置和复现路径。
关键数字出处:60.96%、94.52%、83.56% 在 §5.1;第 21 层和 COCO 子集见 Fig 4 图注;6000 对、每轴 2000、5 模板乘 2 顺序见附录 A.3;1800 例验证集见附录 B 和 Fig 17;图像平面坐标见 §2 脚注 2;up/below 词对见附录 A.1;gold-conditioned、HStar、EmbSpatial 的实验归属见仓库 README。
保留判断的部分:各图未标注的数值和检验不做推测;技术报告内容范围未核实;Fig 14c 的同模型对照数值未公开。所有基于文献标题、数据集设计动机或代码描述做出的推断,正文均已标明为分析推断。
第四节末尾的三张 Jacobian 图解(assets/ 目录下)为本笔记自绘的教学示意,把高维向量压缩为 4 维再投影到 2 维展示,图内数字(如 3、−1、8、0.2 度)是为演算设定的示例,用于说明机制,不是论文实测结果;论文真实规模为 6000 物体对、5 模板、2 顺序。论文自身报告的真实数字只有 60.96%、94.52%、83.56% 等,正文引用处均已标注出处。
这份笔记基于公开材料,没有运行代码,不构成复现、同行评审或正确性认证。批评的目的是标定结论范围和可补强的实验,不否定工作本身:以 blog 形态的机制可解释性研究而论,它的论证设计和证据组织在同类里属于上游。