智谱&清华提出推理新范式:无需训练,DeepSeek V4/GLM-5.2 长文本推理效果暴涨
来源:微信公众号「极市平台」 · <https://mp.weixin.qq.com/s/cxtG5RMg8CctKl3TDuyWNQ> 归档方式:k2md(WeChat 分支,curl + 内建 HTML 解析);图片已本地化到
assets/
↑ 点击**蓝字 **关注极市平台
来源丨PaperAgent
编辑丨极市平台
极市导读
智谱与清华大学唐杰团队提出一种名为“Trace as State”的极简推理时扩展方法,完全无需修改模型架构或重新训练。只需将大模型首轮生成的推理轨迹序列化,并放置在长上下文之前让模型重读,即可解决输入与推理顺序的错配问题,助力 DeepSeek V4 Pro 在复杂任务中的准确率从 29.2% 飙升至 81.8%。 >>加入极市CV技术交流群,走在计算机视觉的最前沿
Z.ai&清华唐杰提出一个简单却效果惊人的推理时扩展方法 Trace as State,27个模型×任务×指标组合赢了 26 个,DeepSeek V4 Pro从 29.2% 到 81.8%。GLM-5.2 在 GraphWalks Parents 上直接冲到 100% EM。
核心主张非常优雅:不改架构、不训练,让模型先在长上下文上跑一遍,把它产生的推理轨迹收集起来,序列化成文本 T,然后在第二遍把 T 放在长上下文之前重新读一遍再作答。
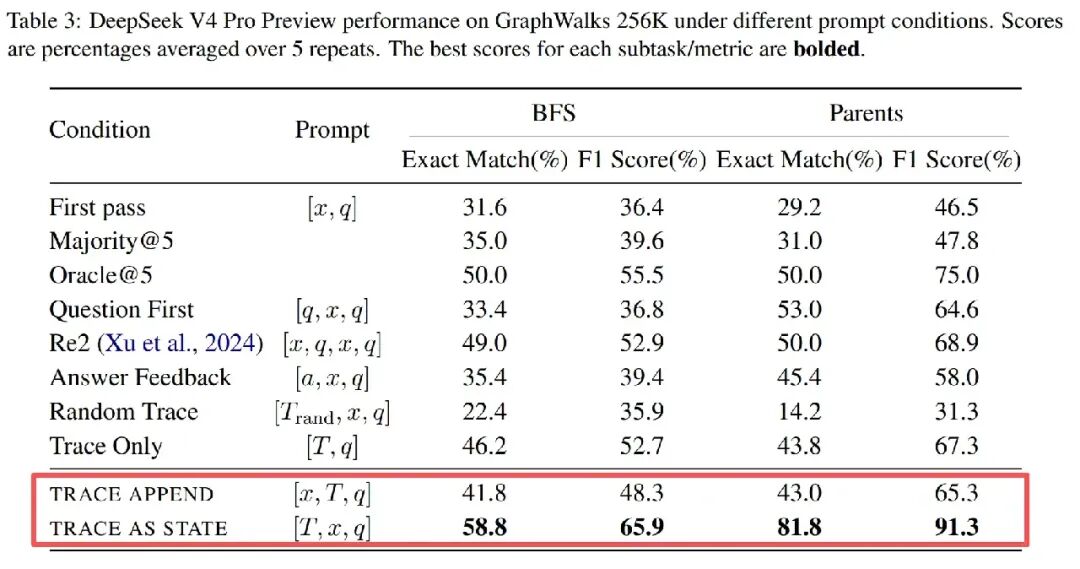
同样的推理轨迹,放在上下文前面和后面,效果天差地别: DeepSeek V4 Pro从初始运行的 29.2% 和使用 TRACE APPEND 时的 43.0% 提升到使用 TRACE AS STATE 时的 81.8% ;对于 GLM-5.2,则从 66.4% 和 83.2% 提升到 100.0%。
一、输入顺序与推理顺序的错配
上下文窗口已卷到百万 token,但因果注意力的本质没变:靠后的信息无法影响同一次前向传播中已形成的靠前表示。而长上下文推理常需维护任务状态(搜索目标、已排除的假设等),这些状态往往读完上下文、开始推理后才被发现。
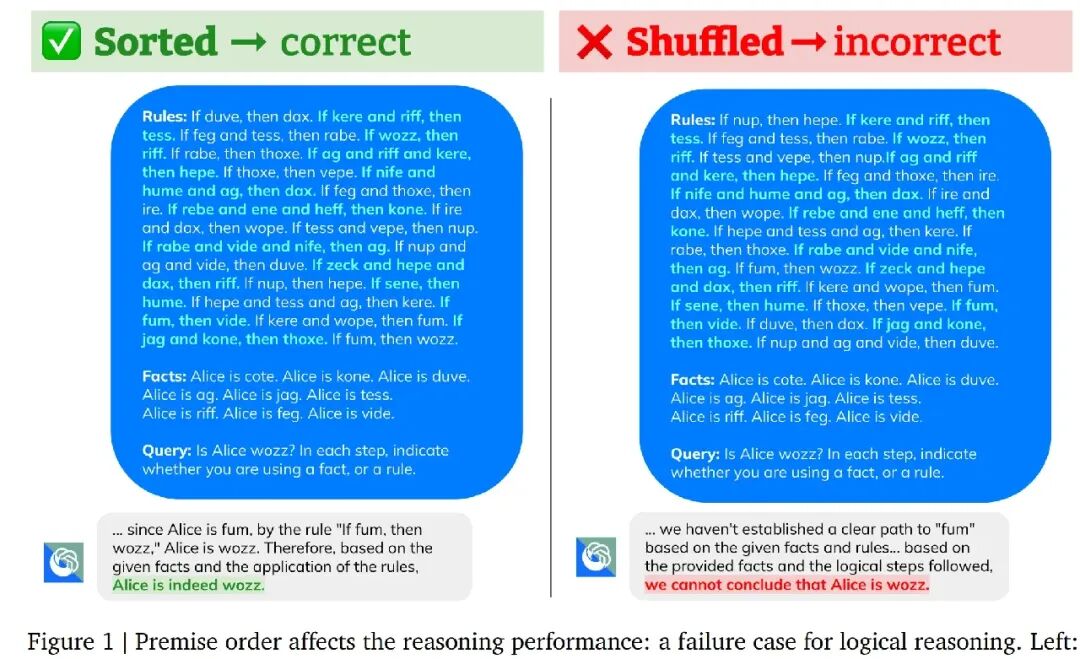
Google DeepMind:推理性能不仅取决于支撑信息出现在哪里,还取决于它们的相对呈现顺序。
直觉例子:读完 50 万字小说最后一章才被告知”请找出坏人”——前面所有细节都没带着目标去组织。
二、方法:Trace as State
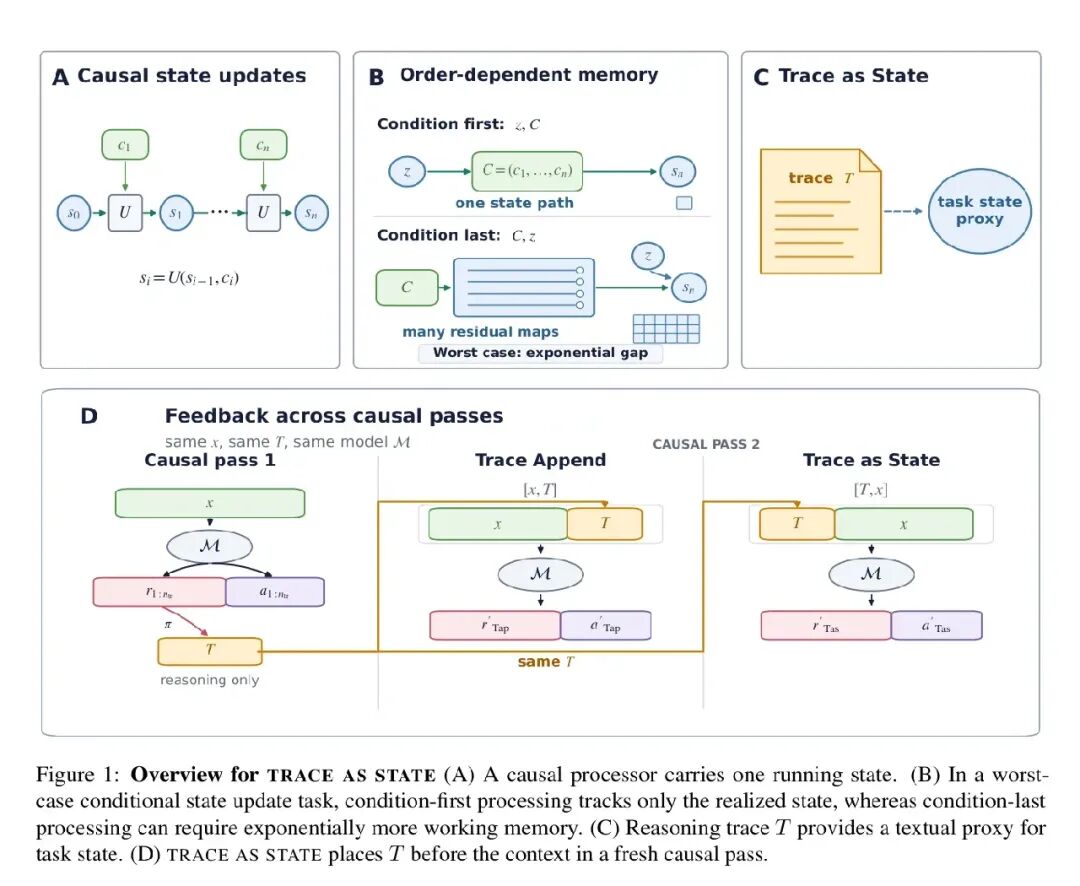
Figure 1: 方法总览
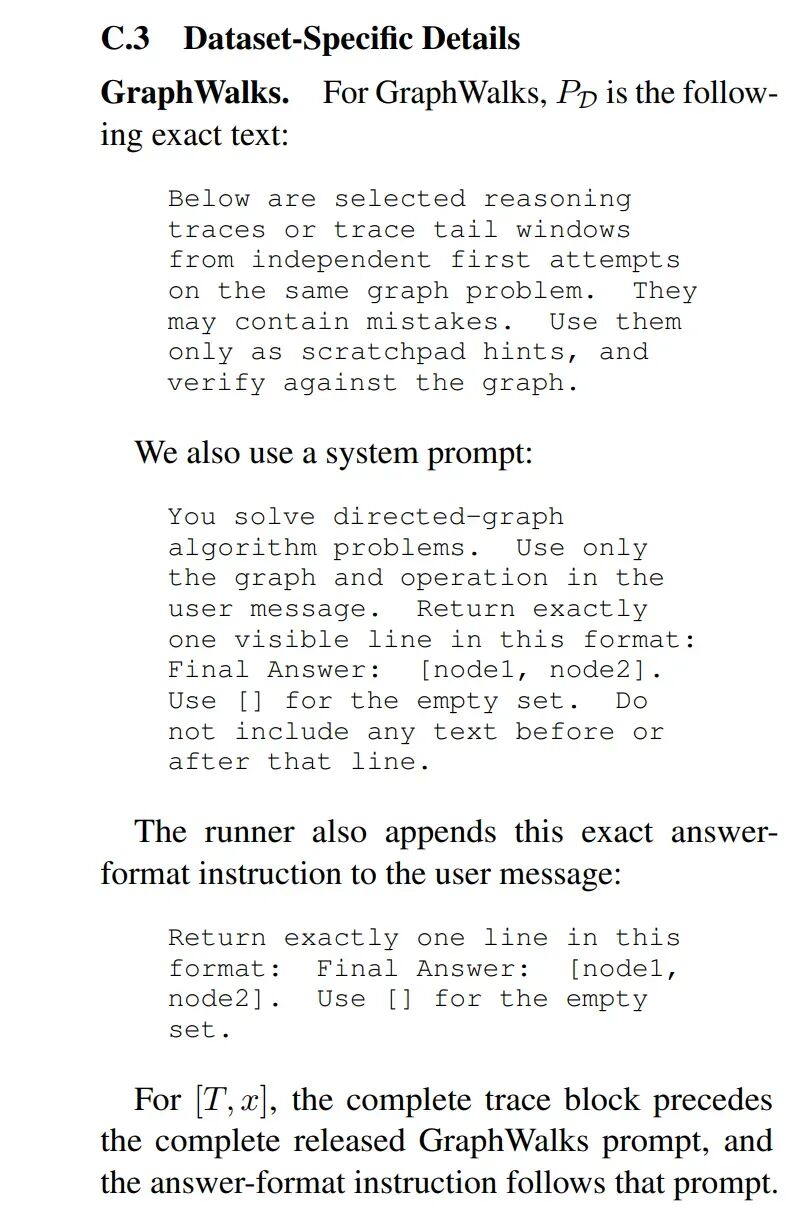
推理轨迹是任务状态的可观测文本代理(可能不完整或有错,但含有用状态信息)。流程为”读→算→反馈→重读”:第一遍正常跑 n_tr 次收集轨迹,序列化为 T(只加分隔符与”轨迹可能有错、需对照原文验证”的引导语);第二遍严格对照两种摆法——[T, x, q](前置,Trace as State) vs [x, T, q](后置,Trace Append)。同 x、同 T、同模型,唯一变量是顺序。
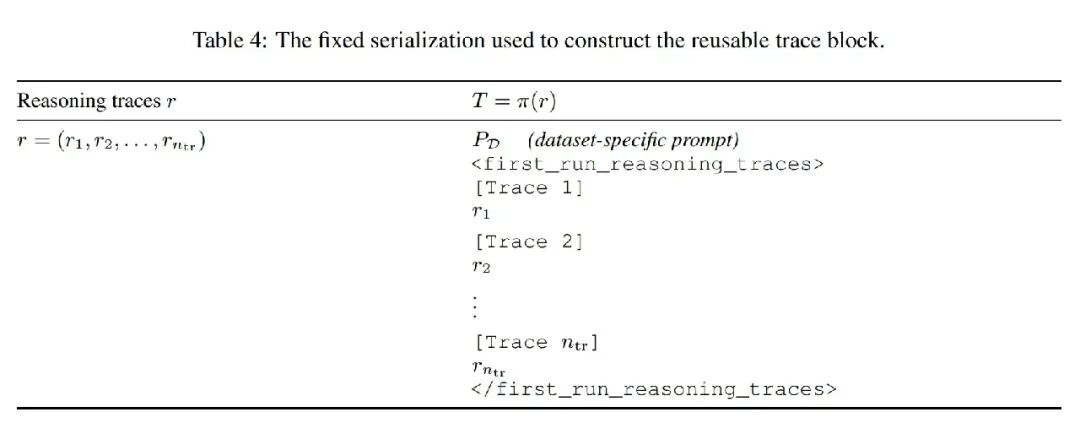
Table 4: 轨迹序列化格式
三、理论:条件状态更新与指数级内存分离
把模型抽象为因果状态更新处理器:读入序列 C = (c₁,…,cₙ),按 sᵢ = U(sᵢ₋₁, cᵢ) 更新状态;“条件” z 决定初始状态。对比两种顺序(Figure 1B):
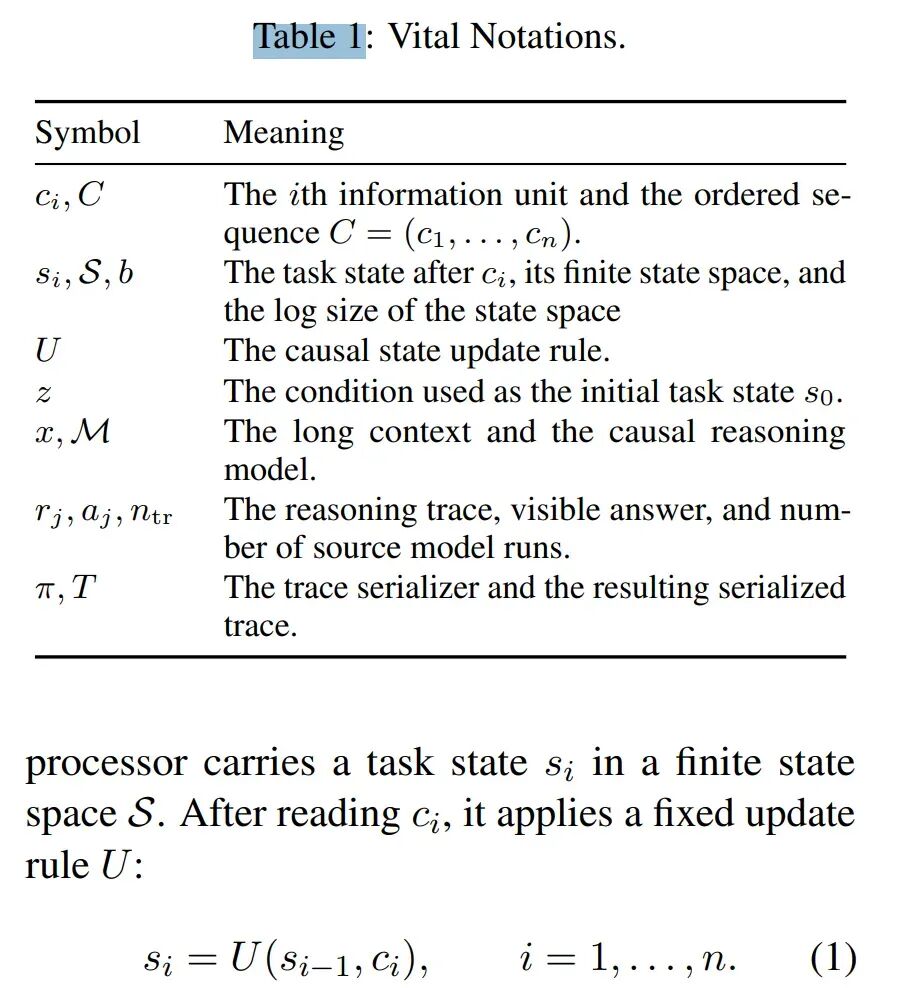
Table 1: 关键符号
-
条件在先 [z, C]:只需存当前状态,⌈b⌉ 比特(b = log₂|S|);
-
条件在后[C, z] :读完序列才知道该传播哪个初始状态,必须为每个可能的 z 保留完整响应档案。S 到自身的函数共 |S||S| 个,最坏需 ⌈b·2ᵇ⌉ 比特——指数级差距。
由此得出排序原则:任务条件在它所指导处理的信息之前就可用,会好用得多。
四、实验设置
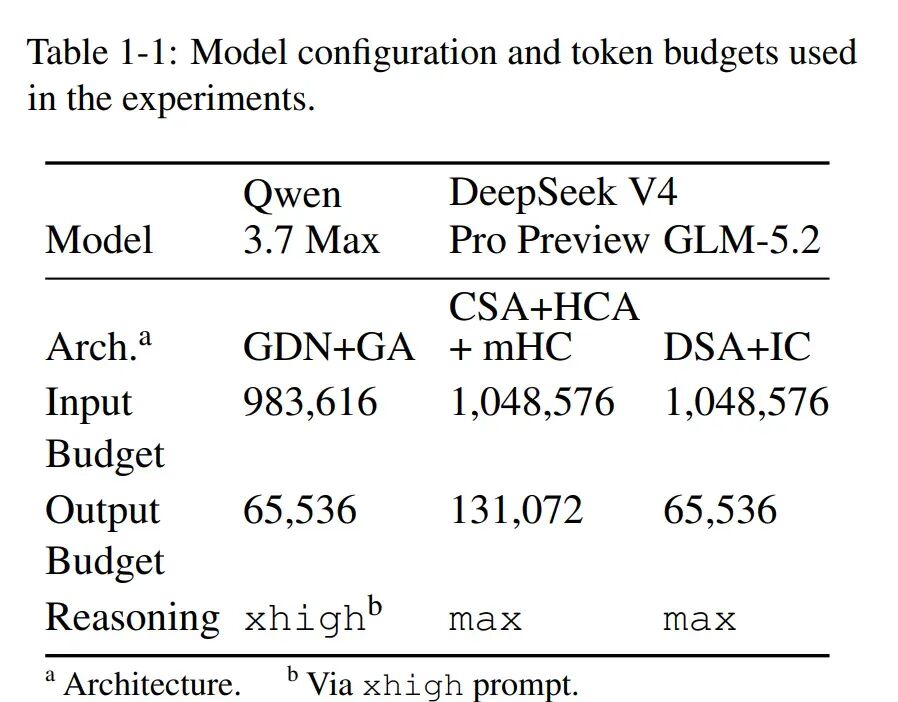
Table 1-1: 模型配置
三个模型(均拉满推理强度、输入预算约 1M token):DeepSeek V4 Pro Preview(CSA+HCA+mHC)、Qwen 3.7 Max(GDN+GA,xhigh 提示)、GLM-5.2(1M MoE,DSA+IndexCache)。
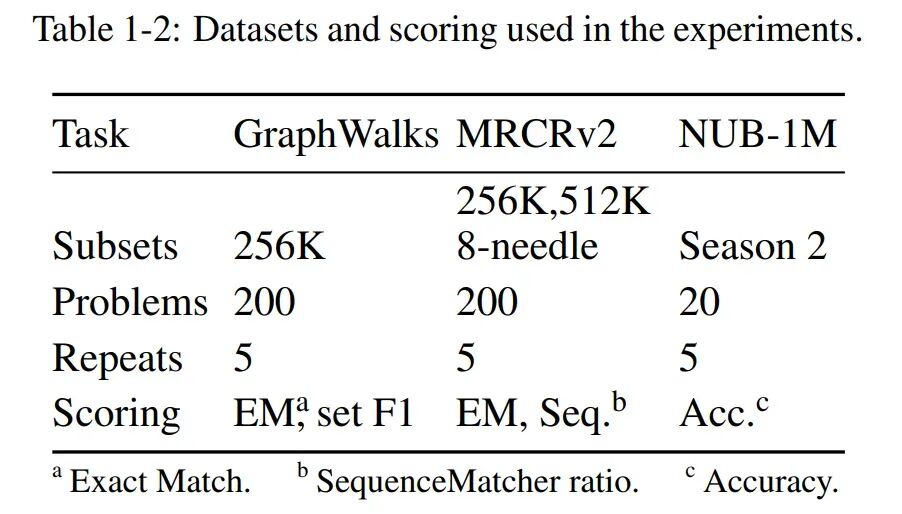
Table 1-2: 数据集与评分
三个基准:GraphWalks 256K(图状态维护,EM+F1)、MRCRv2 8-needle(请求绑定,EM+Seq. 比率)、NUB-1M(长篇小说理解,模型裁判打准确率)。每题 5 次重复取平均,第二遍包含全部 5 条轨迹(截断至 5 万字符)。
五、主结果:27 赢 26
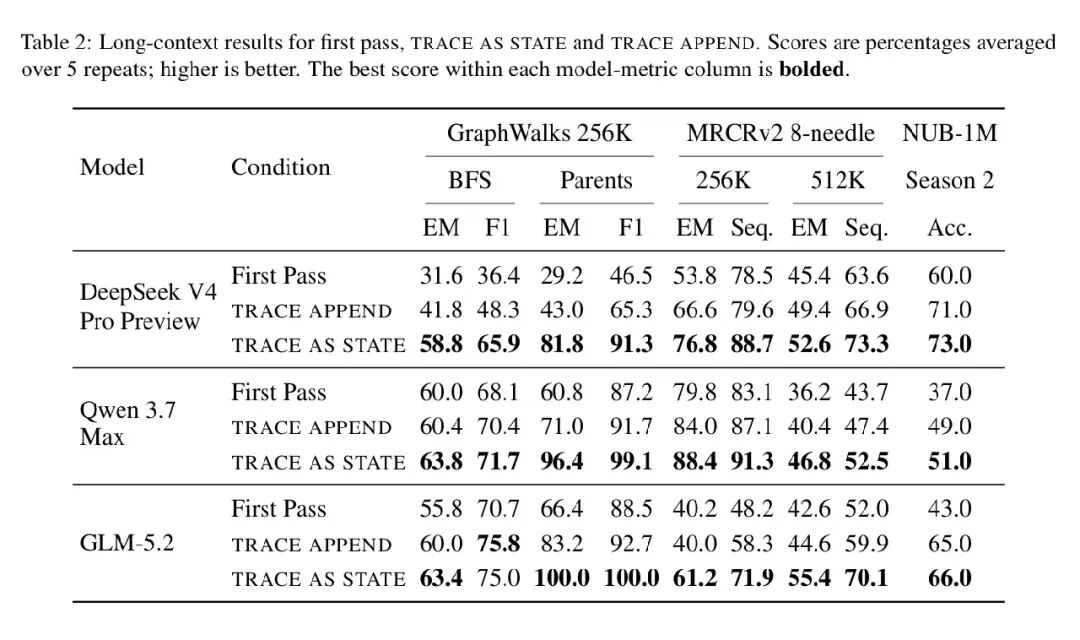
Table 2: 主实验结果
-
GraphWalks Parents 收益最大(正中”状态前置”下怀):DeepSeek V4 Pro F1 46.5→91.3;Qwen 3.7 Max EM 60.8→96.4;GLM-5.2 EM/F1 双满分;
-
DeepSeek V4 Pro 与 Qwen 3.7 Max 在每个数据集×指标上都偏向前置;唯一例外是 GLM-5.2 的 BFS F1(后置高 0.8 点,但 EM 仍是前置高);
-
Trace Append 也常超首遍基线(轨迹确含信息),但前置在其上再进一步——“前置”拿到了”后置”拿不到的价值。
六、消融:排除替代解释
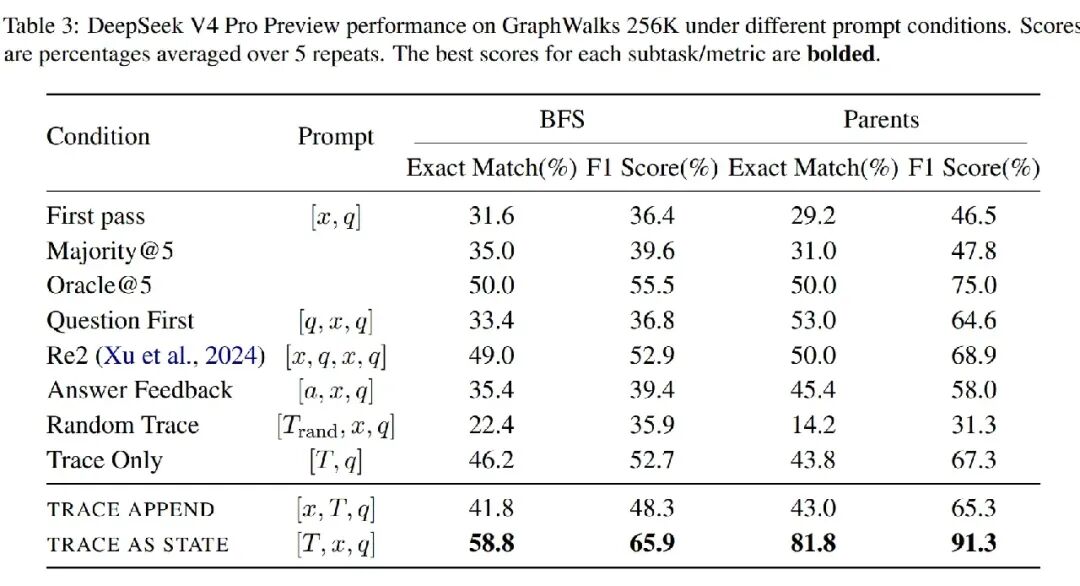
Table 3: 上下文顺序消融
一排对照逐一堵死其他解释:Question First 只对部分任务有效;Re2(重读)有用但远不及前置轨迹;Answer Feedback(只放答案)证明轨迹比答案更有用;Random Trace(换别题轨迹)比不放还差——收益必须来自同一问题的轨迹,排除格式脚手架效应;Trace Only(只给轨迹)远低于前置——原文仍不可或缺;前置还超过 Oracle@5(事后挑最好答案)。
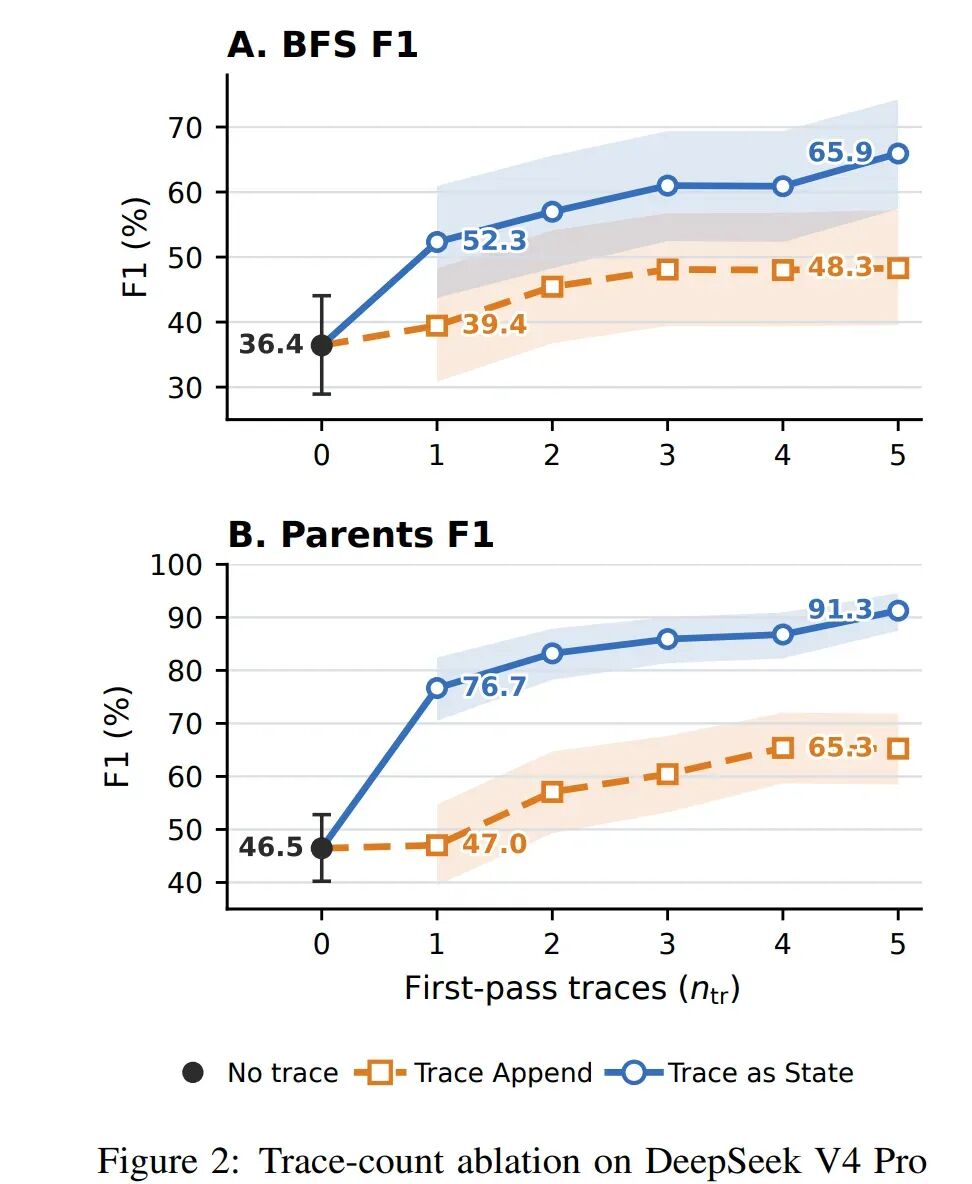
Figure 2: 轨迹数量消融
轨迹数 n_tr 从 1 到 5,性能单调上升且排序优势全程保持——轨迹数量本身就是一个推理时扩展旋钮。
七、难度剖析与统计显著性
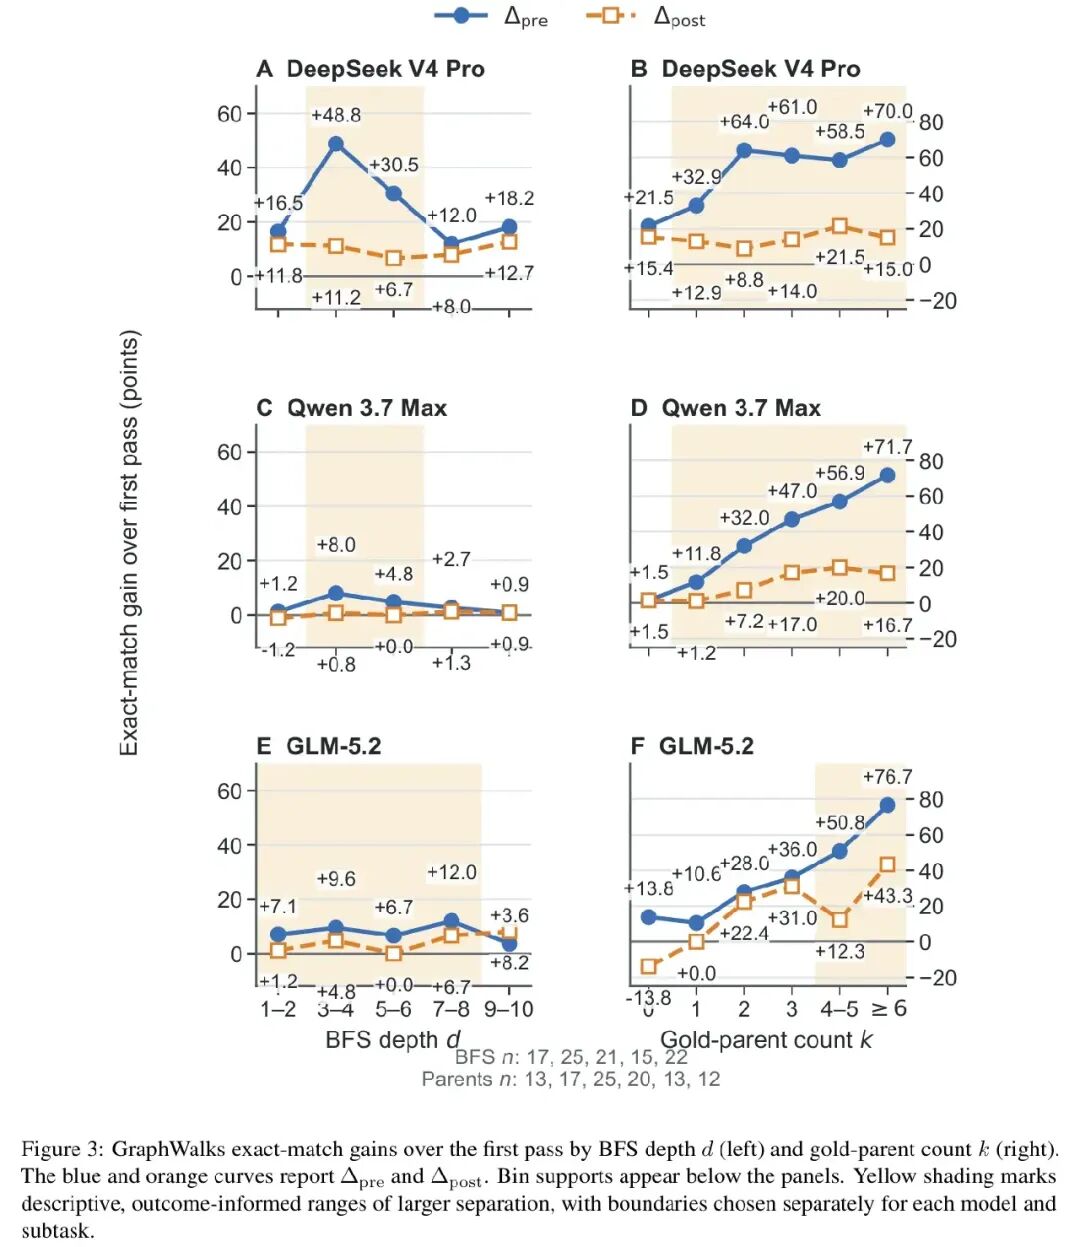
Figure 3: 按难度分箱的 EM 增益
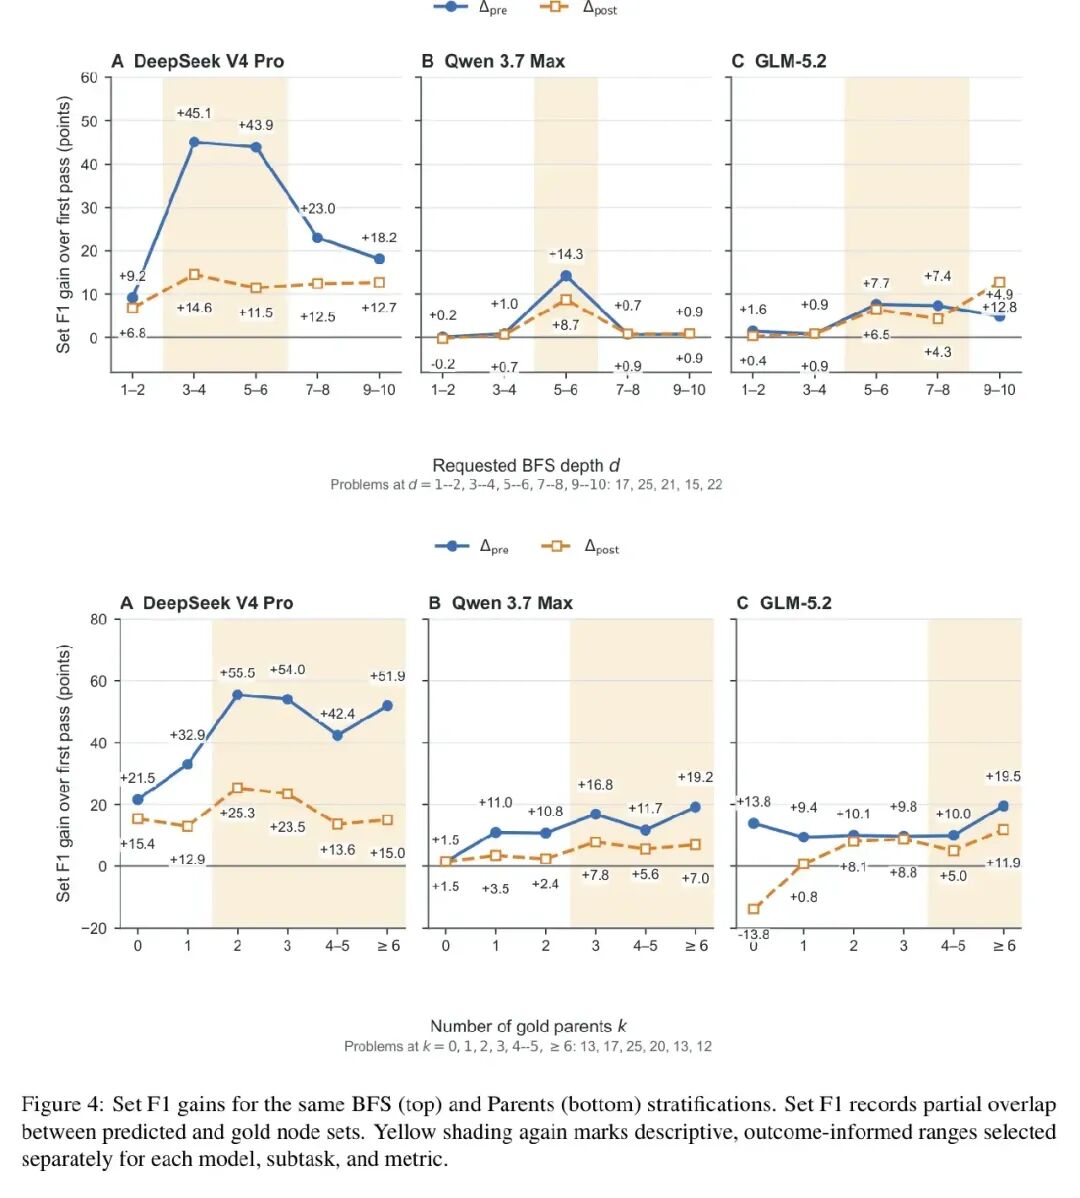
Figure 4: 按难度分箱的 F1 增益
按 BFS 深度 d 和父节点数 k 分箱:DeepSeek V4 Pro 的增益集中在 d=3–6(最高 +48.8 点);Qwen 的差距随 k 扩大(k≥6 时 +71.7 点)。作者诚实声明这些区间是事后标注,仅供生成假设。
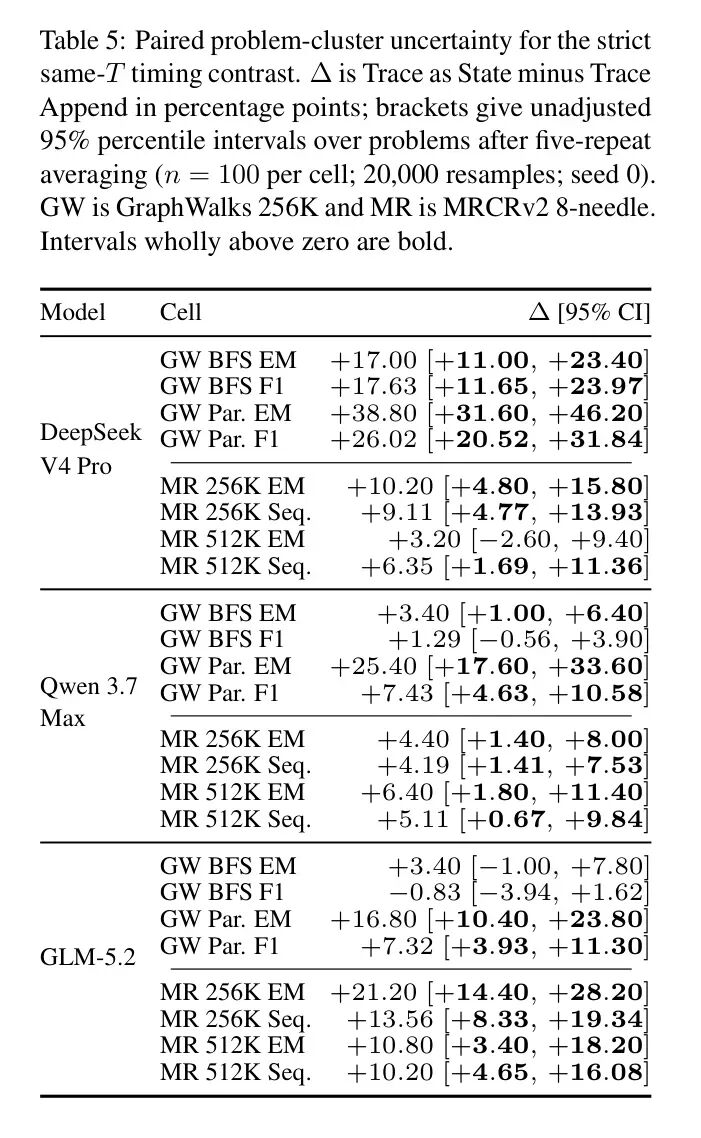
Table 5: 配对置信区间
配对 bootstrap 显示 24 个单元格中 20 个区间整体大于零;最大差值在 DeepSeek V4 Pro Parents EM:+38.80 [+31.60, +46.20]。
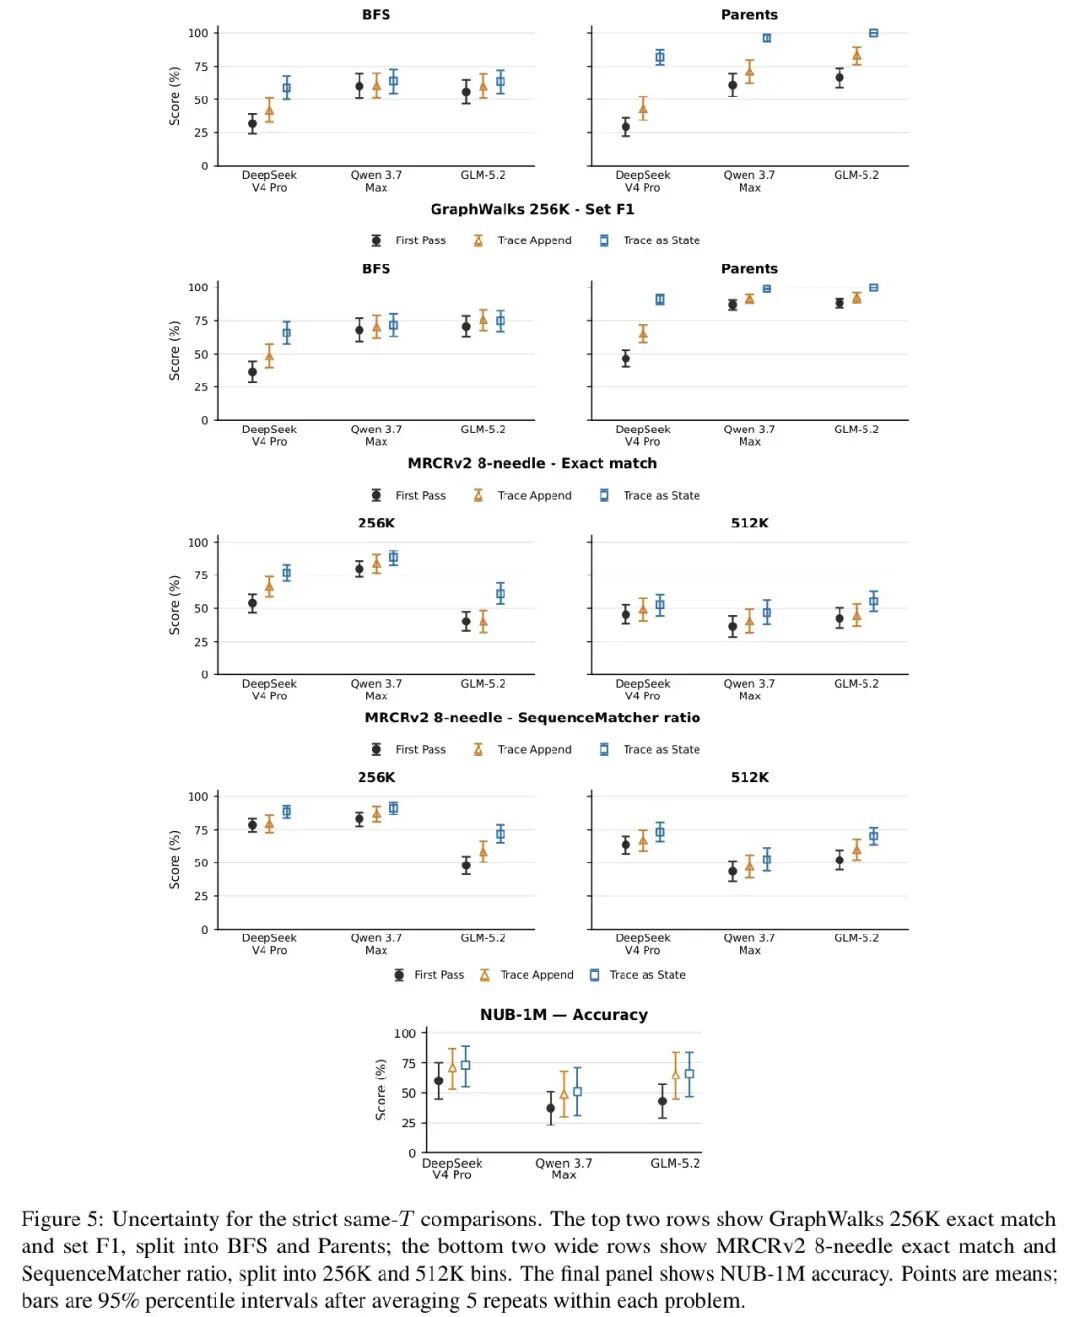
Figure 5: 主对比不确定性
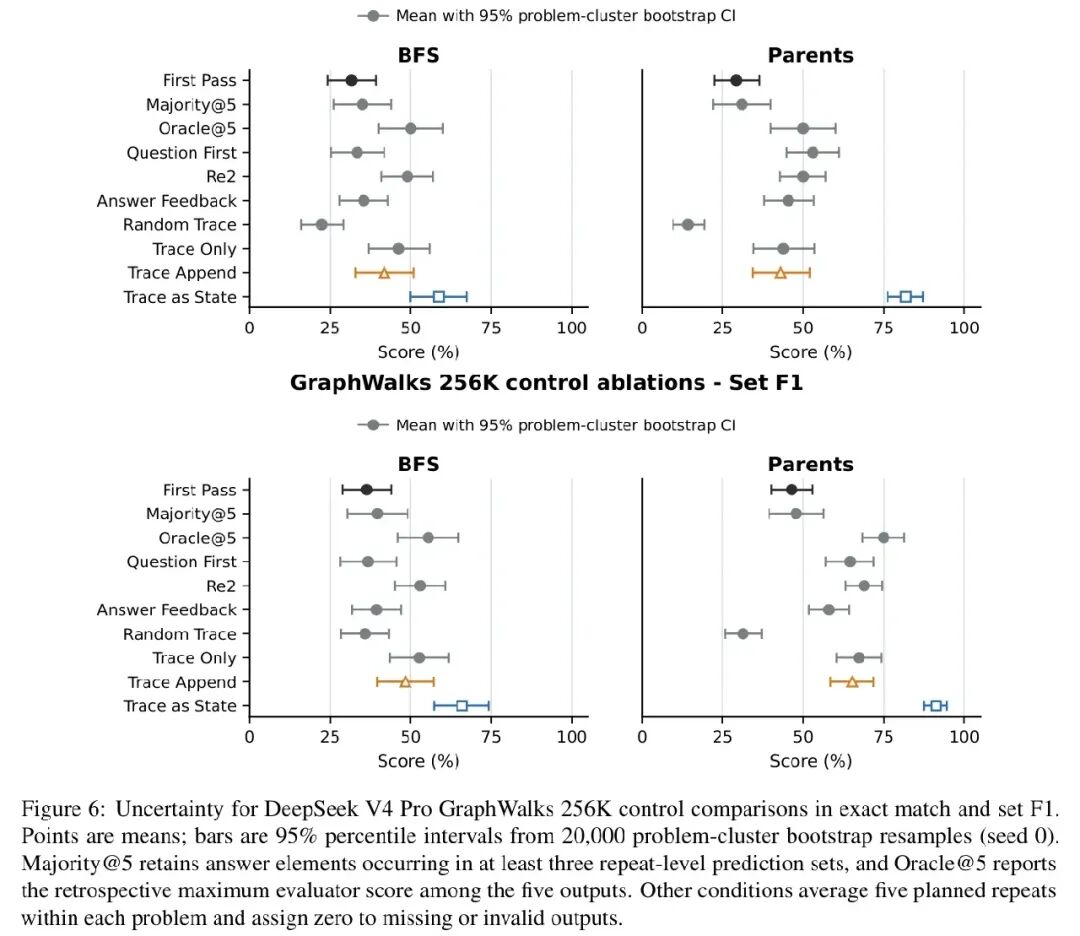
Figure 6: 消融不确定性
八、成本
两遍推理 ≈ 输入 token 翻倍;但带着状态重读时输出(含推理 token)反而大降(DeepSeek V4 Pro 在 GraphWalks 上从 62.5M 降到 28.0M)。代价是状态前置会减少多轮场景的 KV 缓存复用。
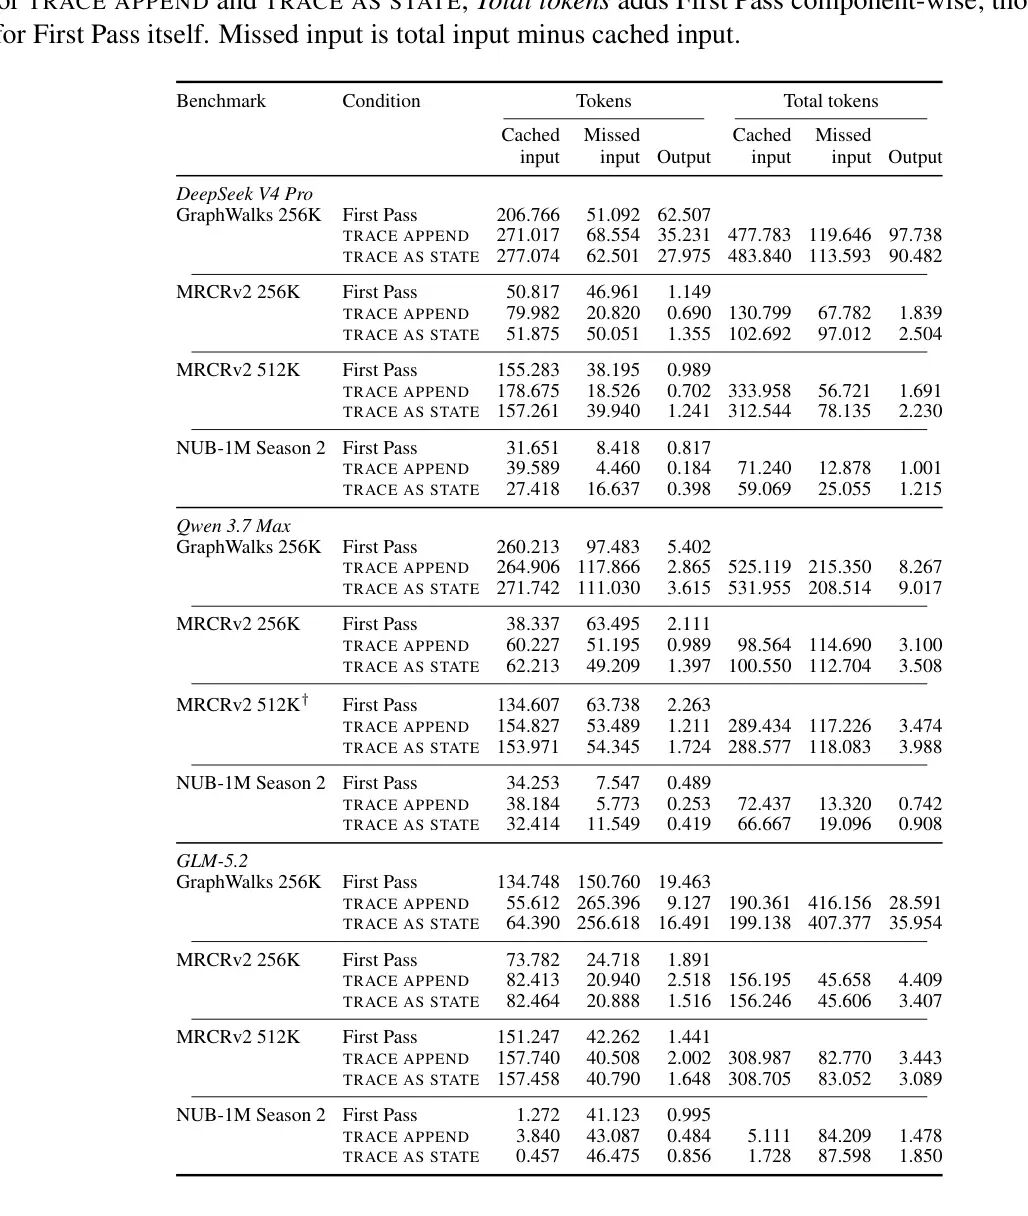
Table 6: Token 用量
最后
长上下文推理的瓶颈不只是窗口长度,还有信息顺序——把第一遍想到的东西放到开头再读一遍,朴素做法的背后是指数级内存差距的硬原理。
- https://arxiv.org/pdf/2609.02702
- Trace as State: Reasoning Traces as Conditional States for Long-Context Transformers
公众号后台回复“数据集”获取100+深度学习各方向资源整理
极市干货
技术专栏:多模态大模型超详细解读专栏|搞懂Tranformer系列|大视觉模型 (LVM) 解读|扩散模型系列|极市直播
技术综述:小目标检测那点事|大模型面试八股含答案|万字长文!人体姿态估计(HPE)入门教程
**点击阅读原文进入CV社区
收获更多技术干货**