Trace as State:前置推理轨迹,引导长上下文重读
符号速查表
| 符号 | 读法 | 含义 |
|---|---|---|
| 艾克斯、丘 | 长上下文、任务问题 | |
| 阿尔下标杰、诶下标杰 | 第 次首轮运行的推理文本、可见答案;下标 是运行编号 | |
| 恩下标 trace | 收集的首轮推理轨迹数量;tr 表示 trace | |
| 派、提 | 固定的轨迹序列化规则、序列化后的轨迹文本 | |
| 提、艾克斯、丘的顺序拼接 | 将轨迹放到上下文之前、问题保留在最后的输入布局 | |
| 西、西下标艾、恩 | 理论模型中的信息序列、第 个信息单元、序列长度 | |
| 艾斯下标艾、艾斯零、优 | 处理第 个单元后的状态、初始状态、状态更新函数 | |
| 泽德、花体艾斯 | 指定初始状态的条件、有限状态集合 | |
| 比、以二为底的对数、艾斯集合大小 | ;表示编码一个状态所需的信息量 | |
| 向上取整、二的比次方 | 理论内存界中使用的取整算子和指数 |
二次解读,整理于 2026-09-15。公众号正文与素材原样保留,以下说明依据论文 v1。 公众号离线原文 · 论文主页 · 本地论文 PDF 作者:Xu Zou(Z.ai)、Jie Tang(清华大学);首次公开:2026-09-02。归类为通用长上下文推理方法,不作为个人项目已完成的实验成果。
1. 方法与输入布局
Trace as State 是一种推理时方法:先运行模型,保存其对当前问题生成的推理文本,再将这些文本放到原始长上下文前,发起新一轮推理。无需为该方法额外更新模型参数。
推理轨迹是生成出来的文本,可以记录搜索目标、已解析的引用和中间发现;它可能出错,并不等同于模型内部隐藏状态。序列化是按固定规则拼接文本、加分隔符与提醒,不是训练或压缩模型权重。
这里拼接的是同一问题的推理轨迹;独立的最终答案不是轨迹的替代品。第二阶段比较三种输入:
| 条件 | 输入 | 用途 |
|---|---|---|
| 首轮基线 | 测量未反馈轨迹时的表现 | |
| Trace Append | 轨迹放在原文之后,控制额外信息带来的收益 | |
| Trace as State | 轨迹放在原文之前,让原文处理过程可以利用它 |
两种反馈条件使用相同模型、原文、轨迹和问题,核心干预是轨迹位置。它们与首轮基线相比则同时增加了信息与计算,不能将全部收益归给位置。
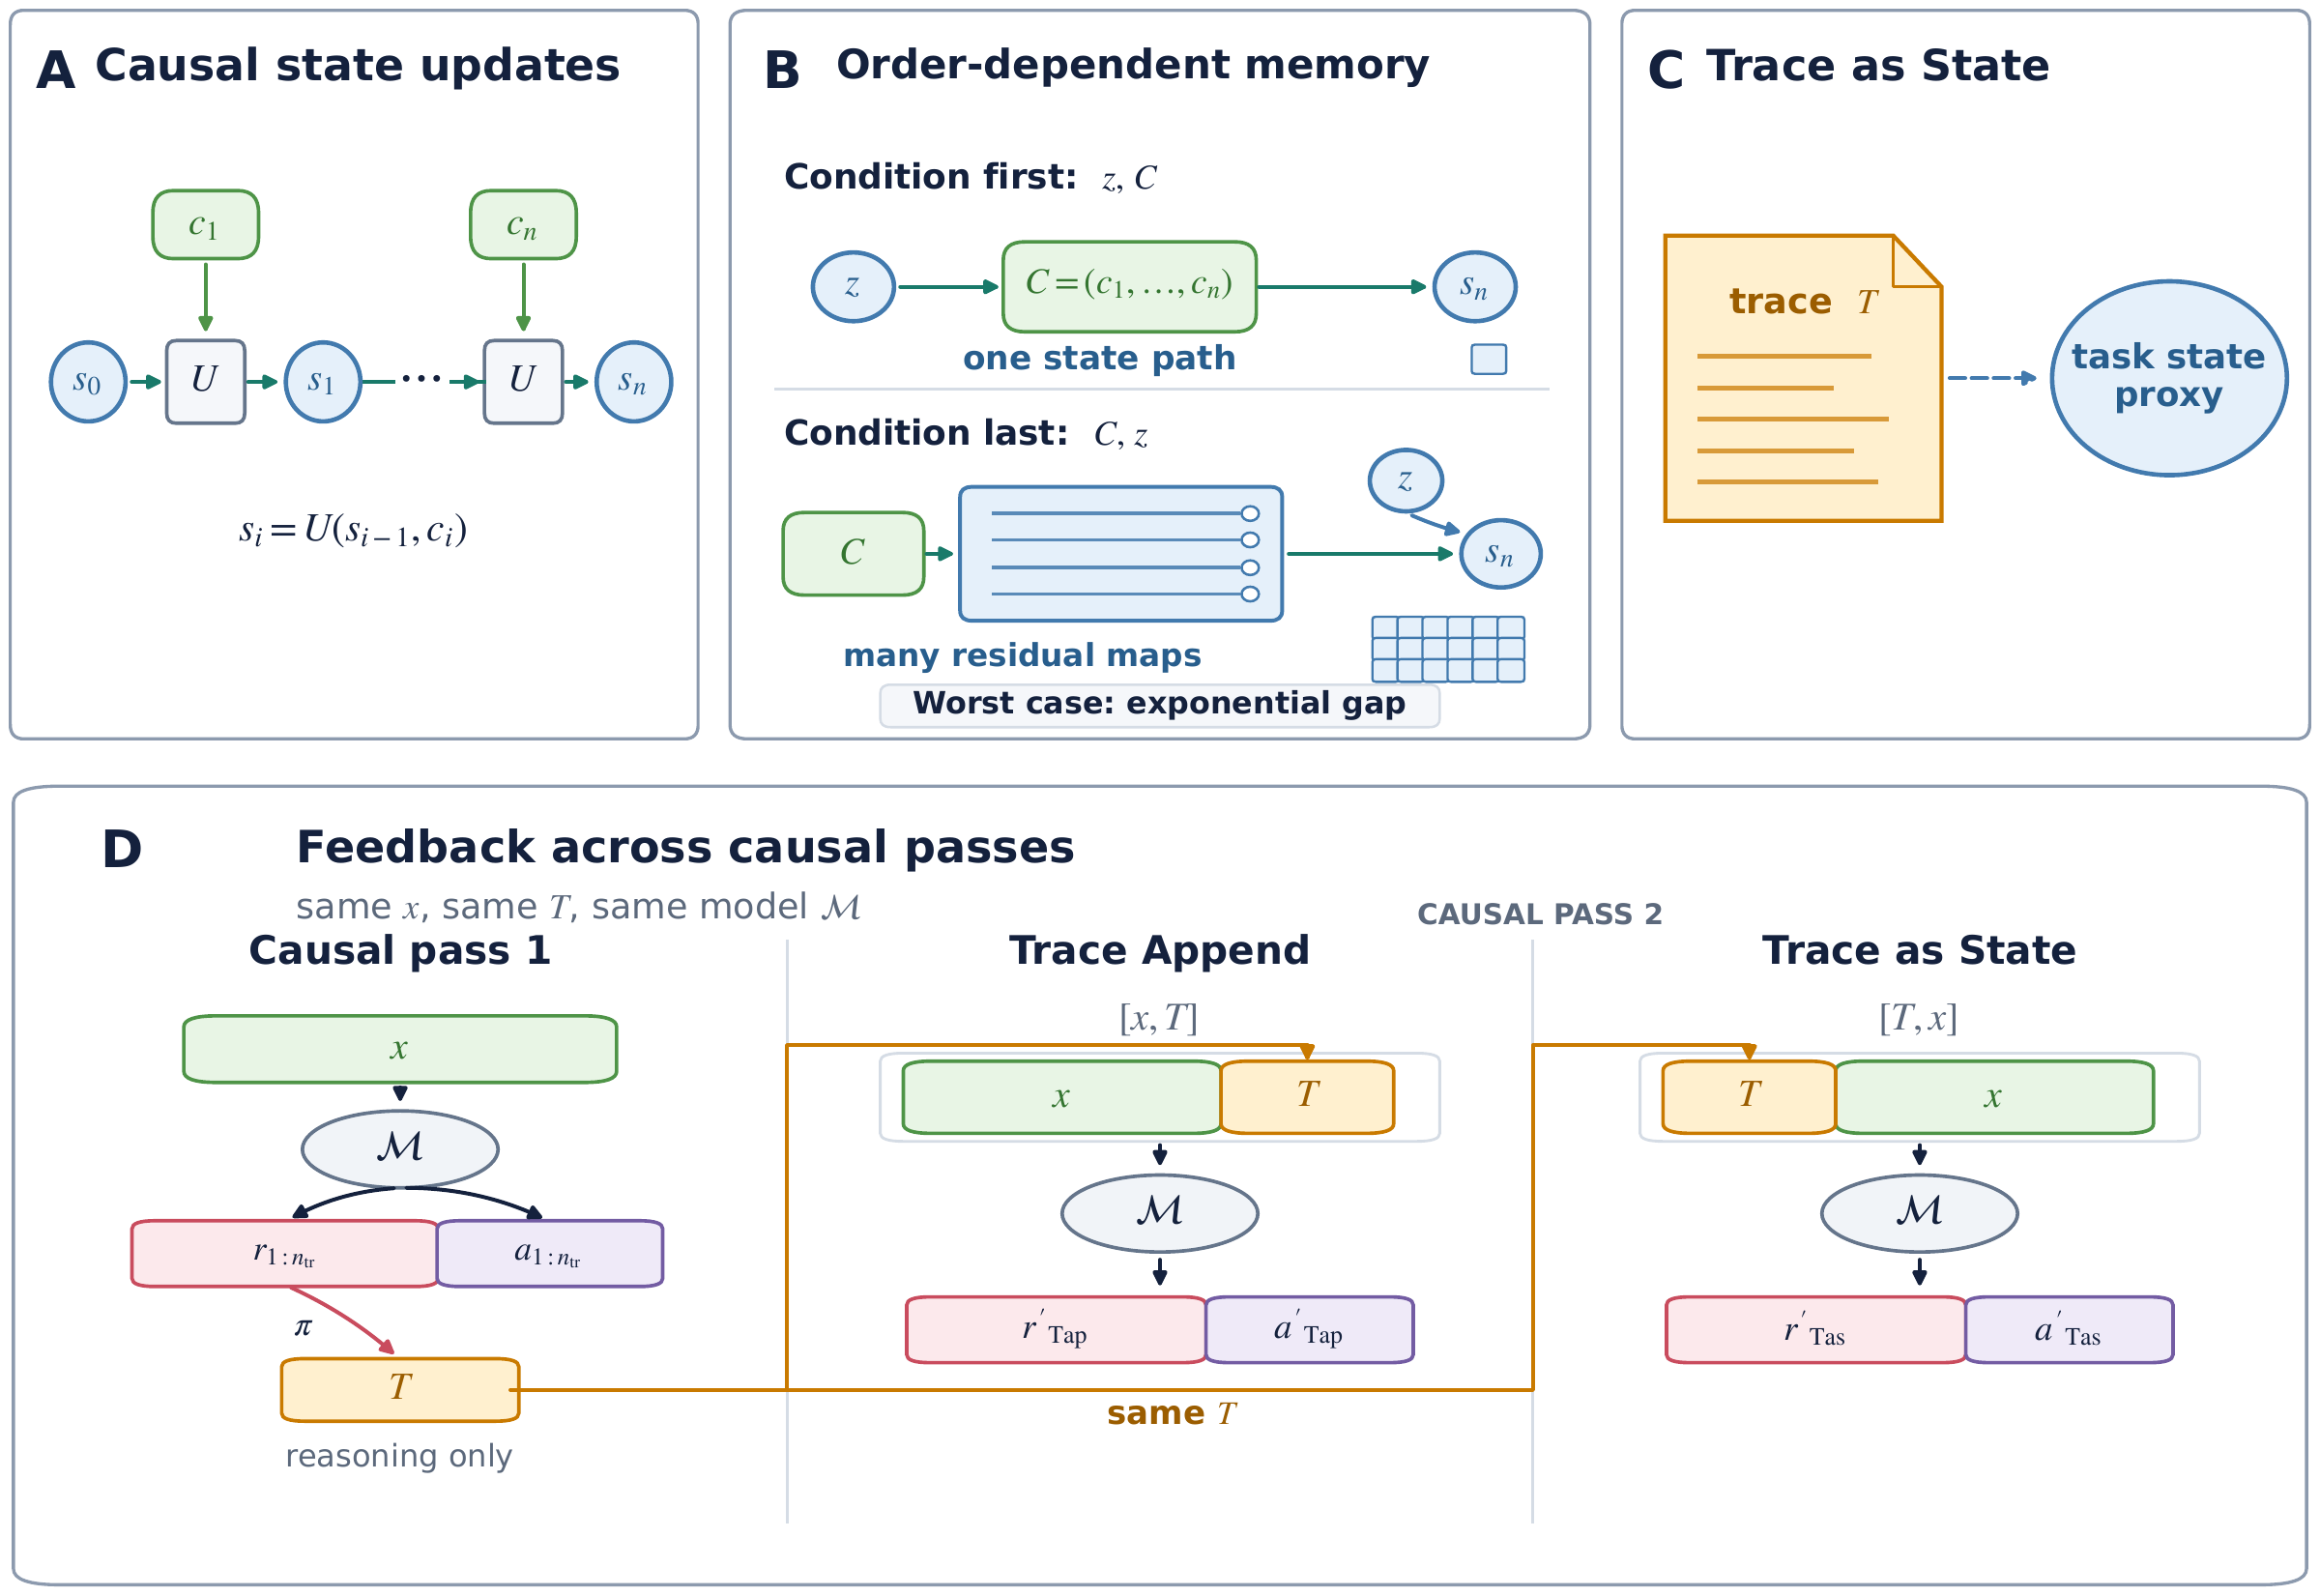
高清图取自论文 TeX 源中的矢量 PDF,对应公众号 assets/img-005.jpg;矢量原图。公众号压缩图未被覆盖。
2. 因果注意力与理论边界
因果注意力允许当前位置使用前缀信息,同一轮中后出现的轨迹不能修改此前已经形成的上下文表示。将轨迹前置并重新处理原文后,轨迹中的线索在处理原文时就已可用。后置轨迹仍能影响后续答案生成,不能说后置完全无效。
论文以单遍读取的因果状态更新处理器解释这一动机:
先给条件 ,处理器可以维护实际发生的一条状态路径;后给条件,则可能必须记住信息序列对各种初始状态的响应。在论文构造的最坏情形下,前者仅需 比特,后者需要至少 比特。
这是特定形式化任务的最坏情况内存分离,不等于实际大模型显存、推理时间或正确率获得指数级改善。推理文本也不保证完整表示理论条件 。论文将该结论作为输入顺序设计的动机,再通过实验检验。
3. 实验阅读口径
论文评估 DeepSeek V4 Pro Preview、Qwen 3.7 Max、GLM-5.2,以及三类长上下文任务:GraphWalks 图关系推理、MRCRv2 多轮请求匹配、NUB-1M 小说理解。EM(Exact Match)是答案完全匹配率;F1 是精确率与召回率的调和平均,在图任务中评价输出节点集合。
- “27 个组合中赢 26 个”比较的是 Trace as State 与 Trace Append,组合单位为模型、任务和指标,不是 27 篇数据集,也不是对所有任务的通用保证。
- 29.2% → 81.8% 对应 DeepSeek 的 GraphWalks Parents EM,不能写成模型整体准确率提升;该任务中后置轨迹为 43.0%。
- 主设置收集五条首轮轨迹,另有重复运行评估。两阶段是流程划分,不等于总共只调用两次模型。
- 论文中的轨迹数量消融与输入位置对照应分开理解:前者改变可用轨迹数量,后者固定轨迹改变位置。
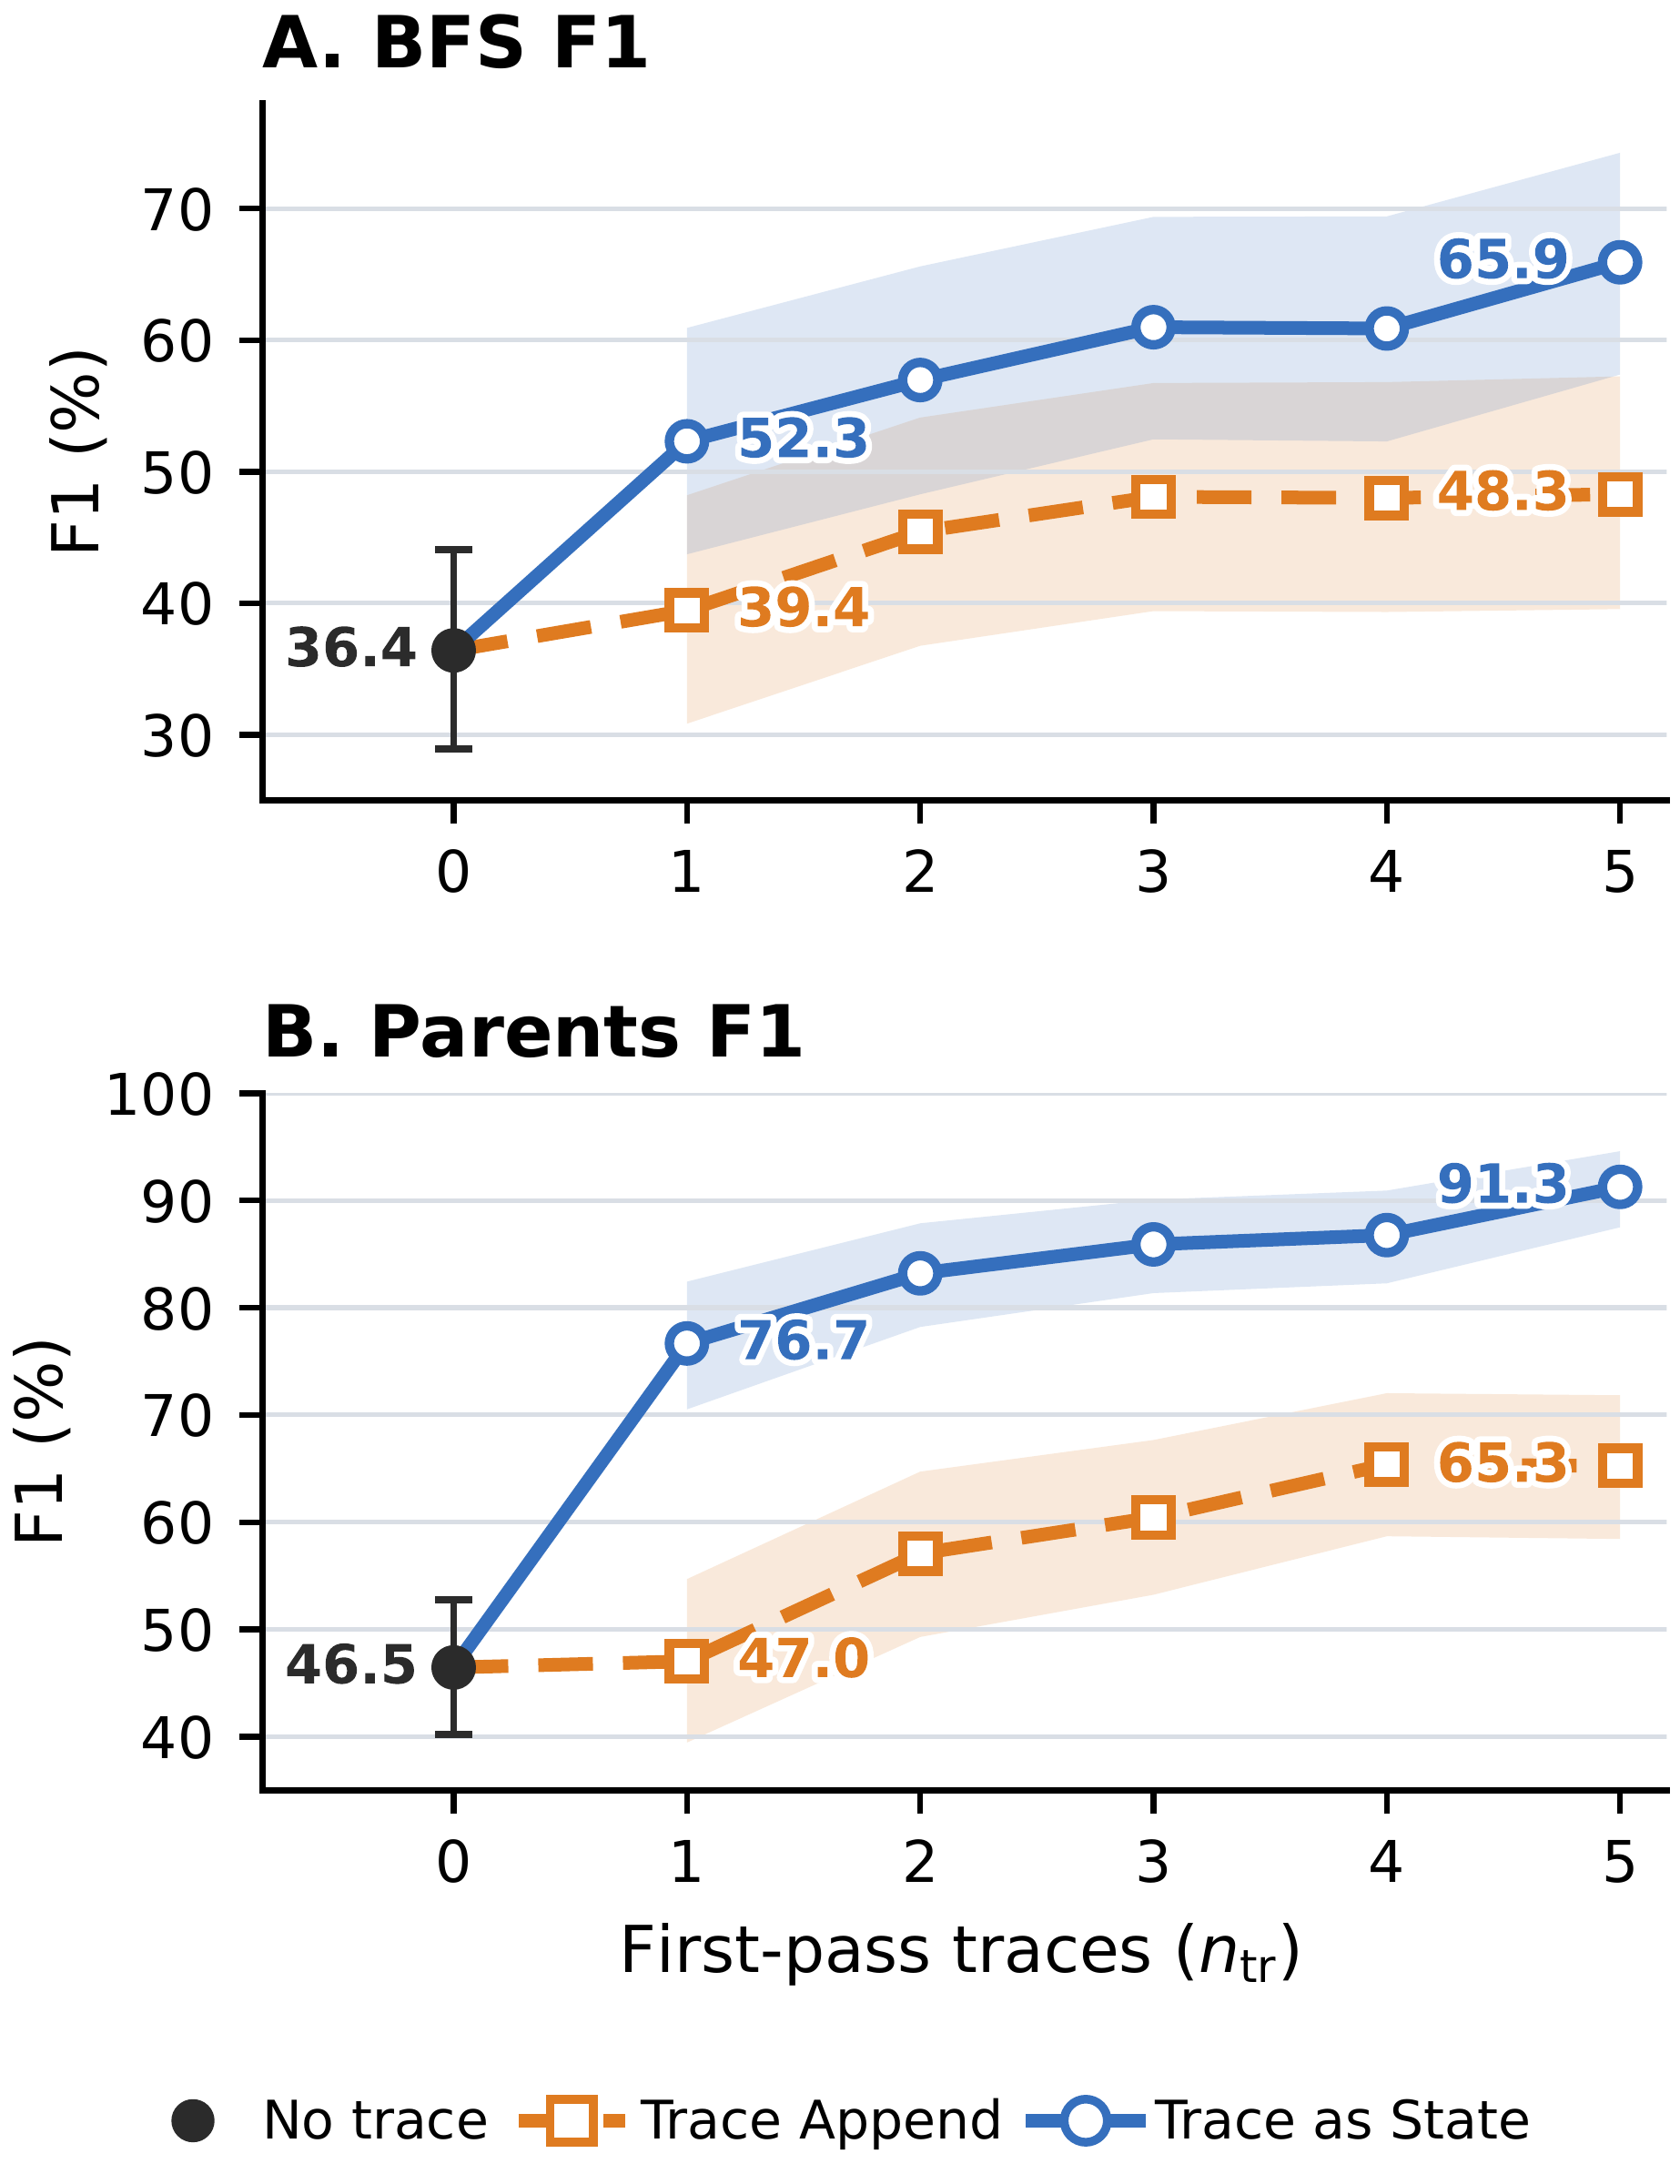
对应公众号 assets/img-013.jpg;矢量原图。BFS 指广度优先搜索。蓝线与橙线分别对应轨迹前置和后置;阴影表达图中报告的不确定性。
4. 成本与接口限制
论文附录 Table 6 将“当前阶段”和“包含首轮的累计量”分开统计。DeepSeek 的 GraphWalks 输出量为:首轮 62.507M token,Trace as State 第二阶段 27.975M,累计 90.482M;token 是模型分词后的计量单位,M 表示百万,输出统计含推理 token。
因此,“重读阶段输出较短”与“整个流程比单次运行更便宜”不是同一个结论。应同时计入首轮轨迹生成、第二阶段输入输出、缓存命中及延迟;前置状态还可能降低多轮场景中键值缓存(KV cache)的复用率。
复现需要可获得的推理文本或其他公开状态接口。只返回最终答案的服务,不能直接复现论文的原始轨迹设置;另行生成摘要是可研究的改动,但需要重新验证。论文尚未评估多轮 Agent 交互任务,不能直接当成 Judge–Fix 或 AutoResearch 已验证的收益。
5. 归档与来源
- 公众号来源:极市平台,转引 PaperAgent;保存完整正文及 20 张本地素材,不下载视频。
- 论文 v1:方法见 §3,实验见 §4,限制与成本见 Limitations、附录 F。
- 两张高清图来自 arXiv TeX 源,保留独立矢量文件并渲染为 2400 像素长边 PNG;未修改作者图形内容。
- 公众号原文和原文件名保留转换器输出,包括标题中的 HTML 实体
&;仅外层目录采用语义命名。原图表中的细字可结合本地 PDF 放大阅读。