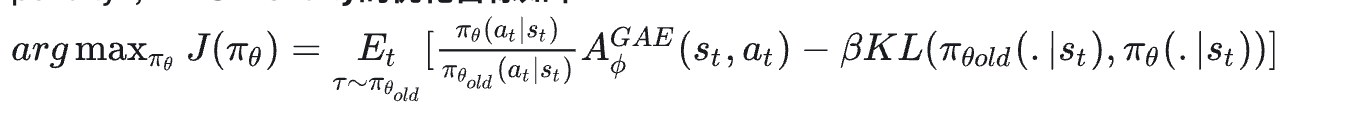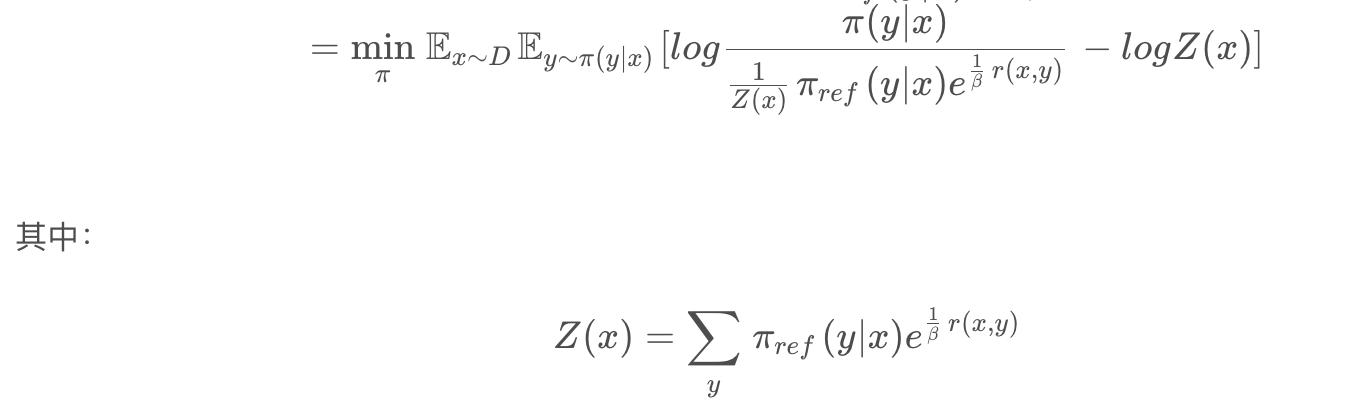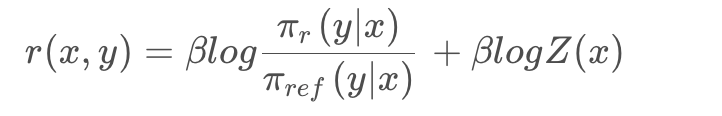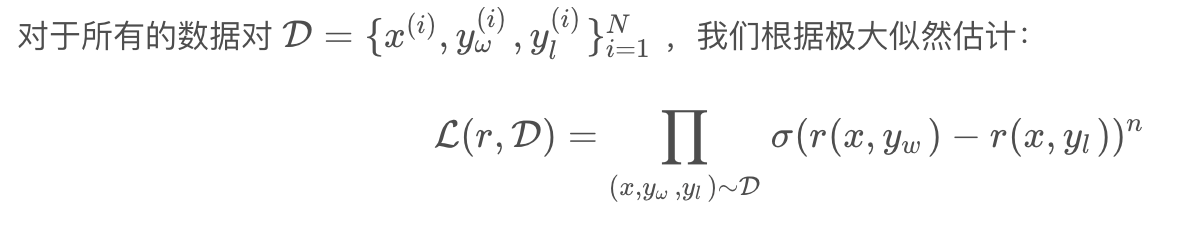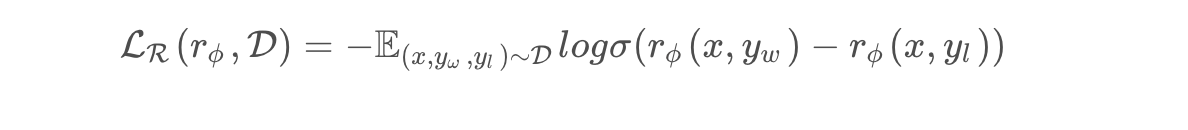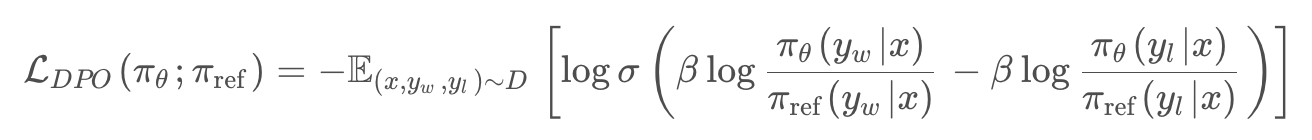章节总览
后训练、偏好优化与蒸馏 / 26 · 正文
原目录

从 SFT、PEFT 到 PPO、GRPO、DPO 与 KTO,保留后训练入门材料中的公式和图解。

来源:内部资源

Basics of LLM Post Training

SFT

SFT是使用最多的post training方法,使用的是supervised数据集,目的是使Pretrained LM获取遵循instruction的能力,数据格式一般是 (prompt, output)。SFT的训练使用next token prediction的cross-entropy loss进行训练,几乎等同Pretraining阶段的做法,区别在于SFT的loss是不计算prompt部分的loss的,所以在数据处理时会mask掉这一部分。

class InstructionDataset(Dataset):

    def __getitem__(self, index):
        IGNORE_INDEX = -100  # The default setting in CrossEntropyLoss

        ann = self.ann[index]
        if ann.get("input", "") == "":
            prompt = PROMPT_DICT["prompt_no_input"].format_map(ann)
        else:
            prompt = PROMPT_DICT["prompt_input"].format_map(ann)
        # 注释1: 这里,prompt = instruction + input

        example = prompt + ann["output"]
        # 注释2: example = prompt + output

        prompt = torch.tensor(
            self.tokenizer.encode(prompt), dtype=torch.int64
        )
        example = self.tokenizer.encode(example)
        example.append(self.tokenizer.eos_token_id)
        # 注释3: example = prompt + output + <eos>
        example = torch.tensor(
            example, dtype=torch.int64
        )
        labels = copy.deepcopy(example)       # 深拷贝, labels = example = prompt + output + <eos>
        labels[: len(prompt)] = -1
        # 注释4: label里prompt的部分置-1

        example_mask = example.ge(0)
        label_mask = labels.ge(0)
        example[~example_mask] = 0
        labels[~label_mask] = IGNORE_INDEX
        # 注释5: label里prompt的部分置-100

SFT Loss计算部分:
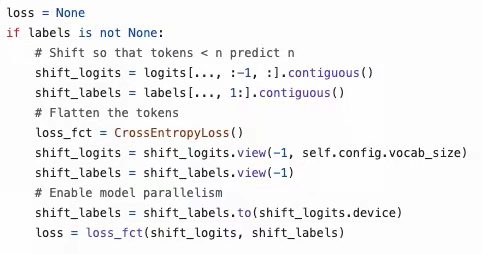
图片展示的是SFT Loss计算部分的代码。代码中,当标签不为空时,对token进行移位操作,将logits和labels进行相应处理,再将token展平,使用交叉熵损失函数计算loss_fct,接着为启用模型并行性,将shift_labels移至shift_logits所在设备,最后通过loss_fct计算出loss。这段代码与上文提到的SFT训练使用next token prediction的cross - entropy loss进行训练,且处理时会mask掉prompt部分loss的内容相呼应,是对SFT Loss计算的具体代码呈现。

SFT最重要的部分应该是数据了,从Andrej Karpathy的教程里看chatgpt的SFT其实是conversation形式的(部分是多轮的,提问的是prompts,output是人工写的结果),这样可以使LLM获取更好的多轮理解能力。SFT的数据的关键词包括:高质量(一般采用人工标注)、多样性(e.g.,InsTag)、高复杂度(Complex Instruction往往能带来更好的效果,需要提高prompts里的instruction数量)。标注标准遵循Helpful,Truthful,Harmless原则。

当我们有一个LLM之后,再做针对某些单个任务的SFT(一般在小size的LLM上),这种做法其实更偏向于prompt learning的做法,利用了pretrained model的基础知识(GPT2,T5等)做task-specific的微调来强化特定任务, 区别只不过prompt从pretrained model的text infilling的形式变为了LLM的instruction的形式。但是这种SFT会产生对其他任务的灾难性遗忘,解决遗忘的方法就是需要混合一定比例的旧数据(>1% rehearsal, from meta的一篇paper)。

PEFT

parameter-effecient finetuning的方法可以大体上分为三类:adapter、prefix tuning、lora,这是在缺少显卡的时候SFT一个llm必备的技能,虽然整体效果可能会比全参微调要差一点,好处是训练的资源需求很少训练的快很多(因为固定了llm本身的参数)。

1、Adapter tuning在llm内部(比如transformer里)添加一些网络结构(一般包括向下投影、非线性激活、向上投影、残差)来训练。

2、lora在llm的全连接层上加入一个旁枝,旁枝采用先向下投影再向上投影的低秩做法,lora一般加在q和v的转换矩阵上(paper里实验了这种组合效果最好)。lora的一个好处是这些参数在推理时可以合并到llm本身参数里,相当于没有添加增加任何推理成本

3、prefix tuning在模型输入或者隐层前添加一段连续的、任务特定的前缀序列,称为 prefix。这段序列不对应真实的 tokens,是可学习的自由参数。p-tuning多了一个lstm和全连接层对prefix编码后再传入llm,p-tuning-v2将添加的prompts从输入层拓展到每一层。

RLHF

PPO

Reward Model

PPO一般是在SFT模型之上进行训练,首先,我们需要一个reward model,一般是由标注的pairwise数据(prompt, chosen, rejected)数据训练得到。具体的偏好采样训练过程如下:

  • prompt x -> SFT model,产生 pairs of answer (y_1, y_2)
  • then 展示给人,获取偏好(y_w, y_l)
  • 假设这些偏好是由某种潜在的奖励模型产生的,模拟偏好的方法如 Bradley-Terry model,该方法将人类的偏好分布规定为:

p∗(y1≻y2∣x)=er∗(x,y1)er∗(x,y1)+er∗(x,y2)=sigmod(r∗(x,y1)−r∗(x,y2))p^∗(y_1≻y_2|x)=\frac{e^{r^∗(x,y1)}}{e^{r^*(x,y_1)}+e^{r^∗(x,y_2)}}=sigmod(r^*(x,y_1)-r^*(x, y_2))

  • 所以可以将SFT model加上一个线性层(nn.Linear(n_embed*1))来预测一个分数r,然后采用CrossEntropy loss来训练模型即可:
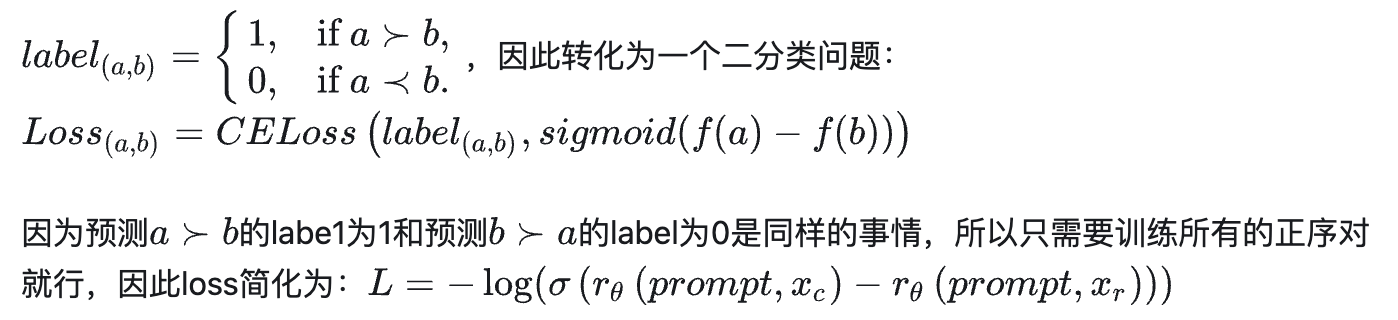
图片展示了偏好采样训练中损失函数的计算公式。当a≻b时,label为1;a≺b时,label为0,转化为二分类问题。损失函数Loss(a,b) = CELoss(label(a,b), sigmoid(f(a) - f(b)))。因预测a≻b和b≻a的label相同,只需训练正序对,loss简化为L = -log(σ(rθ(prompt,xc) - rθ(prompt,xr)))。该公式与上下文介绍的偏好采样训练过程紧密相关,用于说明如何通过损失函数训练模型预测人类偏好。

PPO算法

PPO是一个Proximal Policy Optimization算法的缩写,他是一种policy-based RL方法,区别于value-based RL方法(e.g.,q-learning, SARSA)先优化Q函数,然后通过argmaxQ来确定最优action,policy-based RL直接拟合一个策略网络来选择action,所以可以输出随机策略(value-based RL是确定性策略)。PPO采用actor-critic架构,我们简单回顾下PPO算法的发展过程。

Reinforce
  • agent的每一条轨迹数据(episode/trajectory)被定义为一个sar的序列,表示在状态s中,执行动作a,得到奖励r:

τ={s1,a1,r1,s2,a2,r2,…,sT,aT,rT}\tau=\{s_1, a_1, r_1, s_2, a_2, r_2, \dots, s_T, a_T, r_T \}

  • 优化目标为最大化总奖励的期望:R表示一条轨迹的总收益

Στ∼p(θ)pτ(θ)R(τ)=∑τR(τ)p(s1)Πt∼T(p(at∣st,θ)∗p(st+1∣st,at))\varSigma_{\tau \sim p(\theta)}p_{\tau}(\theta)R(\tau) = \sum_{\tau}R(\tau)p(s_1)\varPi_{t\sim T} (p(a_t|s_t, \theta)*p(s_{t+1}|s_t, a_{t}))

  • 用一个网络拟合策略模型p(at∣st,θ),通过梯度上升法,得到策略梯度为:用一个网络拟合策略模型p(a_{t}|s_{t}, \theta), 通过梯度上升法,得到策略梯度为:

∇=∑τR(τ)∇p(τ)=∑τR(τ)p(τ∣θ)∇p(τ∣θ)p(τ∣θ)=∑τR(τ)p(τ∣θ)∇log⁡p(τ∣θ)\nabla = \sum_{\tau} R(\tau)\nabla p(\tau) = \sum_{\tau}R(\tau)p(\tau|\theta)\frac{\nabla p(\tau|\theta)}{p(\tau|\theta)} = \sum_{\tau}R(\tau)p(\tau|\theta)\nabla\log p(\tau|\theta)

  • 从当前的policy newwork(actor)采样N条轨迹,通过蒙特卡洛(MC)的方法求上式的策略梯度,然后更新网络 ,求梯度时去除掉不含参数项,可以得到:

∇∼∑n=1NR(τn)∇∑t=1Tlog(p(at∣st,θ))=∑n=1N∑t=1TR(τn)∇log(p(at∣st,θ))\nabla \sim \sum_{n=1}^{N}R(\tau_n)\nabla \sum_{t=1}^{T}log(p(a_t|s_t, \theta))=\sum_{n=1}^{N}\sum_{t=1}^{T}R(\tau_n)\nabla log(p(a_t|s_t, \theta))

  • 然后更新网络参数即可:

θ=θ+α∗∇其中α为学习率\theta = \theta + \alpha*\nabla 其中\alpha为学习率

  • 奖励的定义:RL需要设置每个时间步下执行动作之后得到的r(如果没有就要打标每个action的好坏),用Return来表示总奖励,一般加上折扣系数,并减去一个baseline(e.g.,取R的average)来使得reward不总是为正。

Return=R(τ)=∑t=1Tλt−1rt−bReturn = R(\tau) = \sum_{t=1}^{T}\lambda^{t-1} r_{t}-b

Actor-Critic

可以看到Reinforce由于是通过MC来更新梯度的,所以需要每次都采样完整的轨迹之后才能更新参数,由于采样成本较高,我们无法获得大量的样本,这导致估计的回报具有较大的方差,可能会使得训练过程变得不稳定,因此MC是低偏差,高方差的方法。 有没有不用采样完整轨迹也能更新的办法呢?

首先,我们把整个轨迹的reward拆分到每个时间步,这样R(τ)R(\tau)只跟当前时间步t之后的Reward相关,定义A(st,at)=∑t′=tTλt′−trt−bA(s_t, a_t)=\sum_{t^{'}=t}^{T}\lambda^{t^{'}-t}r_t -b为时间步t之后能获得的总收益,这个在标准Reinforce算法里是用MC来估计的,在RL里,我们还可以使用(时间差分/TD)的方法来估计收益。

参考value-based RL方法(比如q-learning),我们用Q(st,at)Q(s_t, a_t)表示在状态s_t下执行动作a_t能获得的总reward的期望,也叫动作价值函数,Value(st)Value(s_t)表示状态s_t下能获得的总reward的期望,也叫状态价值函数; 我们可以用两个网络来近似拟合这两个值,但是根据bellman方程这两个值是可以互相转化的:

Q(st,at)=rt+λ∗Value(st+1)Q(s_t, a_t) = r_t + \lambda*Value(s_{t+1})

Value(st)=∑aπ(st,a)Q(st,a)Value(s_t) = \sum_{a}\pi(s_t, a)Q(s_t, a)

所以可以用只用一个网络(Critic模型)来近似Value(s_t)即可,而Q可以通过上式计算得到,这样我们可以得到A(st,at)=Q(st,at)−V(st)=rt+λ∗Value(st+1)−Value(st)A(s_t, a_{t}) = Q(s_t, a_{t})-V(s_t) = r_t + \lambda *Value(s_{t+1}) - Value(s_t),这个A叫做优势值(Advantage),后面的式子的期望就是GAE,用TD error的形式作为A的无偏估计;但是这样的计算只往前看了一步,如果往前看多步,就是多步TD的计算方法(看到结束就是MC的方法),一般会看k步来平衡方差和偏差,然后再用一个指数加权平均平衡TD和MC,最终得到一个单步优势GAE:
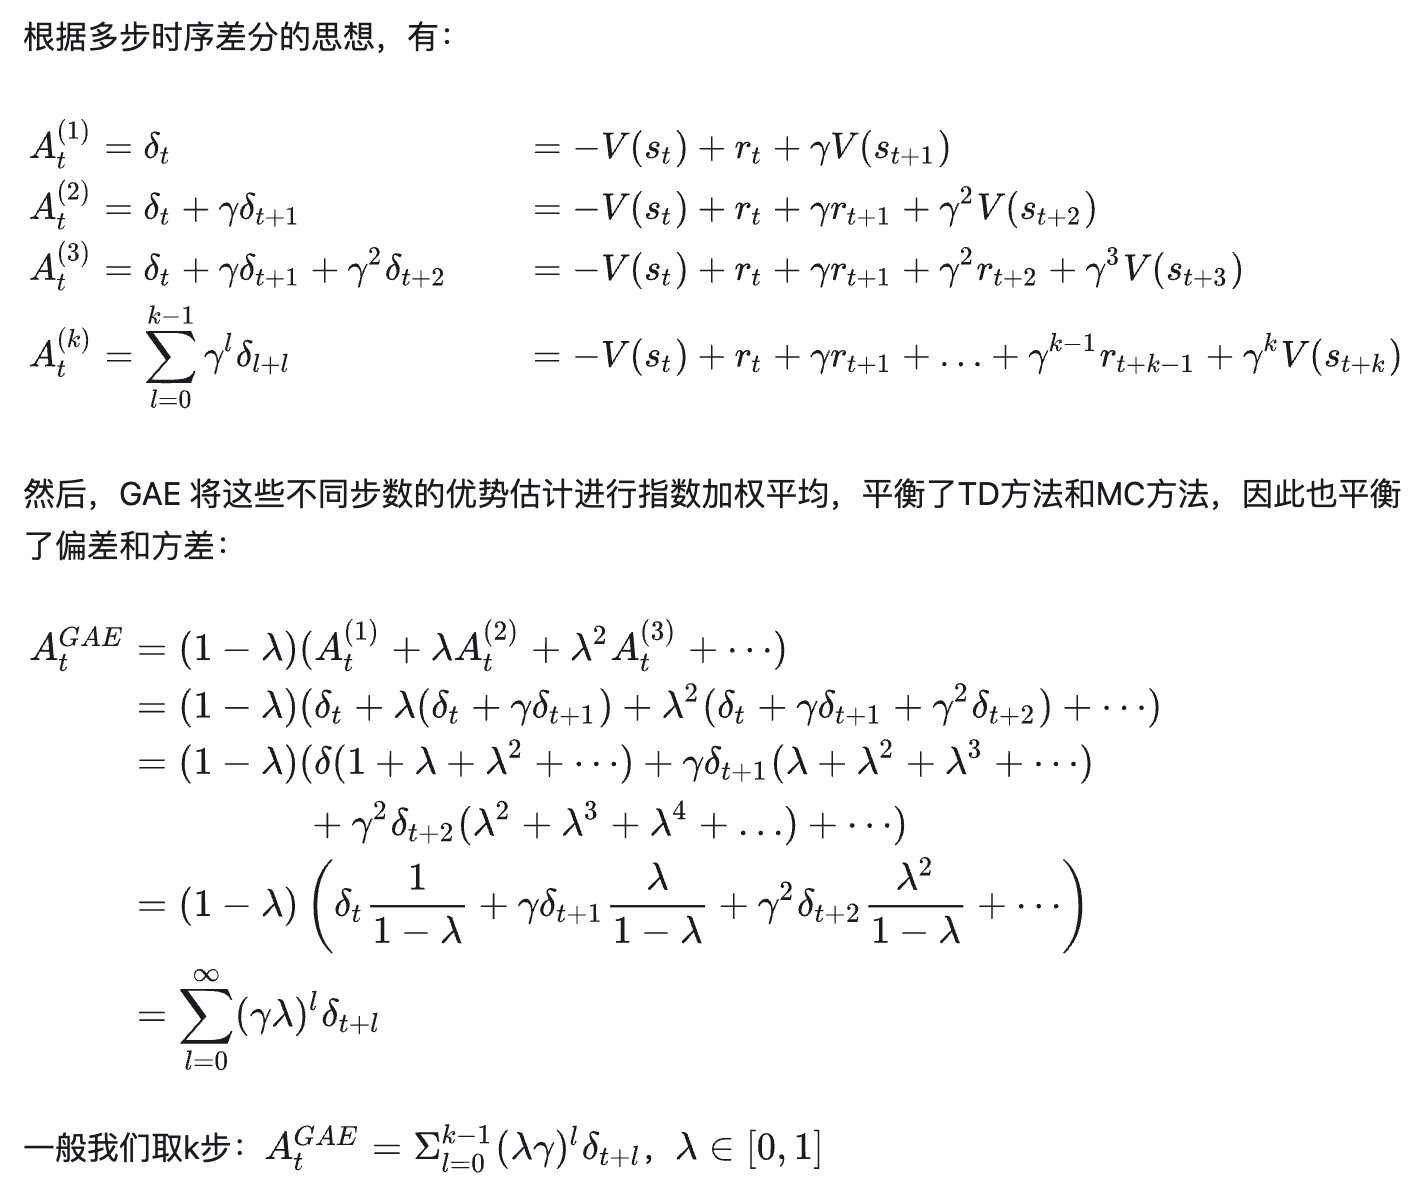
图片展示了多步时序差分思想下的单步优势GAE(Generalized Advantage Estimation)计算公式。通过将不同步数的优势估计进行指数加权平均,平衡了TD方法和MC方法,从而平衡了偏差和方差。公式中,A_t^{GAE} = ∑{l=0}^{k-1} (λγ)^l δ{t+l},λ ∈ [0, 1],其中δ_t = r_t + γV(s_{t+1}) - V(s_t)。该公式是对上文PPO算法中单步优势GAE计算方法的数学推导,用于拟合critic网络。

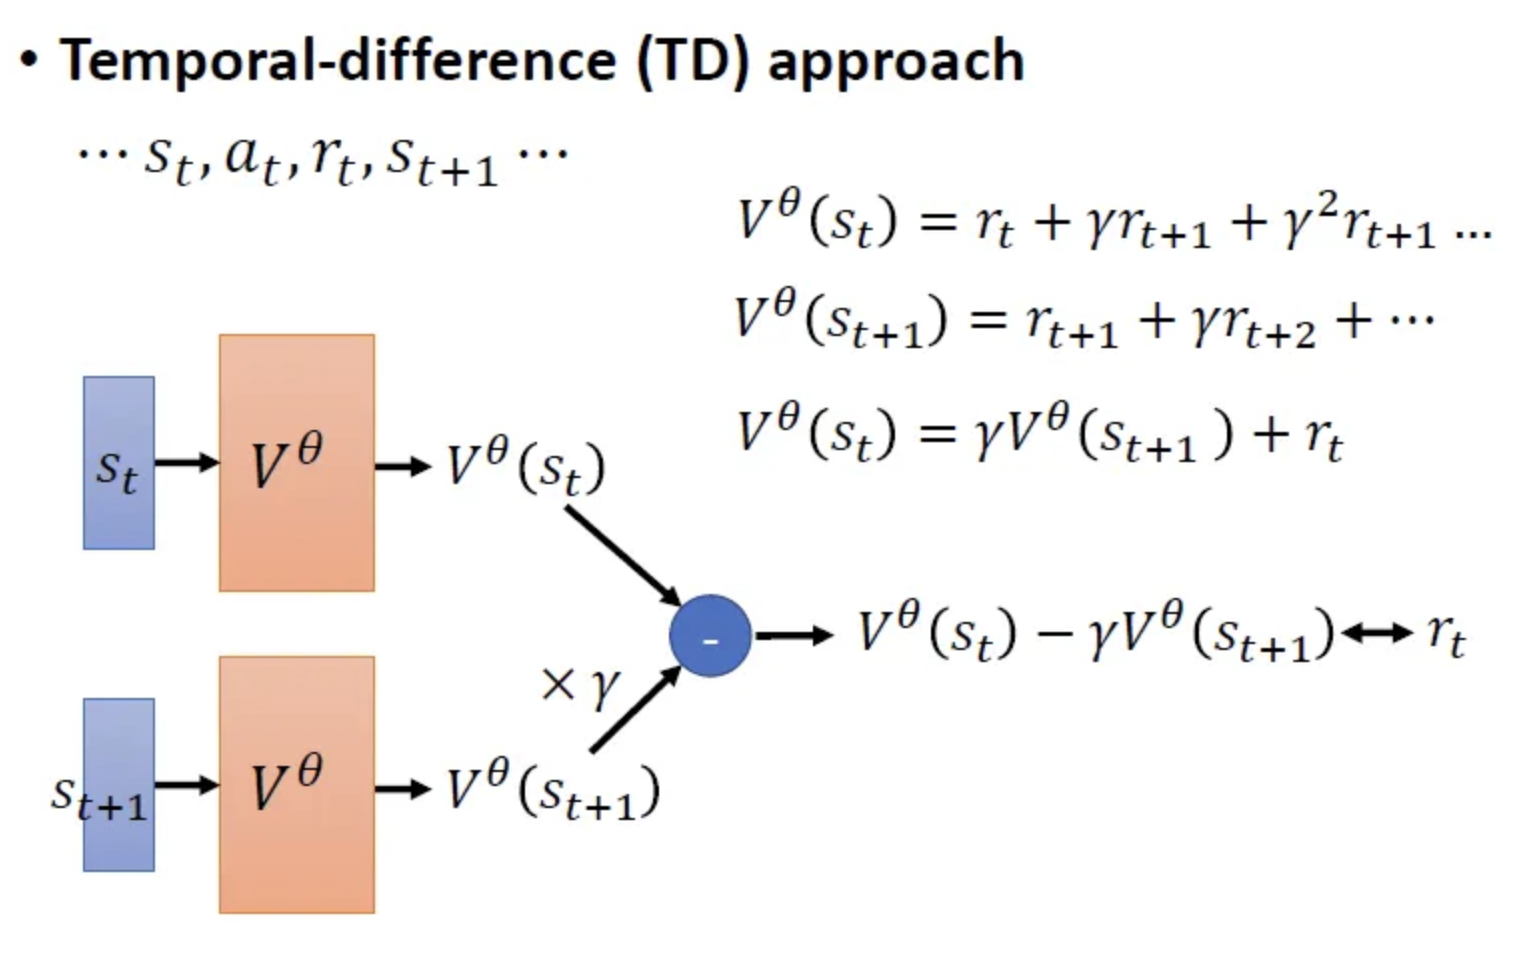
那么怎么去拟合critic网络呢?MC的方法当然可以,但是需要取得完整的轨迹才能更新参数,还有另外一种更常用的就是TD方法了:actor在s_t执行动作a_t,得到reward r_t之后,转移到s_t+1之后,就可以更新参数了,更新的目标就是使Value(st)−λ∗Value(st+1)和rtValue(s_t)-\lambda * Value(s_{t+1})和r_t尽量接近即可(比如用MSE作为loss)。

图片展示了强化学习中TD(Temporal-difference)方法的相关内容。图中呈现了状态 $s_t$ 和 $s_{t + 1}$ 分别输入到 $V^\theta$ 网络得到 $V^\theta(s_t)$ 和 $V^\theta(s_{t + 1})$ 的过程,以及 $V^\theta(s_t)$ 的计算公式 $V^\theta(s_t) = \gamma V^\theta(s_{t + 1}) + r_t$ 。还给出了 $V^\theta(s_t)$ 和 $V^\theta(s_{t + 1})$ 的展开式。图中通过箭头和公式清晰地展示了TD方法中值函数的计算和更新逻辑。此图与上下文紧密相关,是对上文提到的用TD方法拟合critic网络,使 $Value(s_t) - \lambda*Value(s_{t + 1})$ 和 $r_t$ 尽量接近这一内容的可视化呈现。

Off-Policy

当我们在Actor-Critic框架下更新模型时,仍然有一个问题,就是从actor采样的轨迹,每次只能用一次,因为策略网络更新后发生了变化。这其实是一种on-policy的方法(保持更新的网络和采样的网络是同一个),这种方法一个很大的缺点就是参数更新慢,因为我们每更新一次参数都需要进行重新采样、每批样本只能用一次。
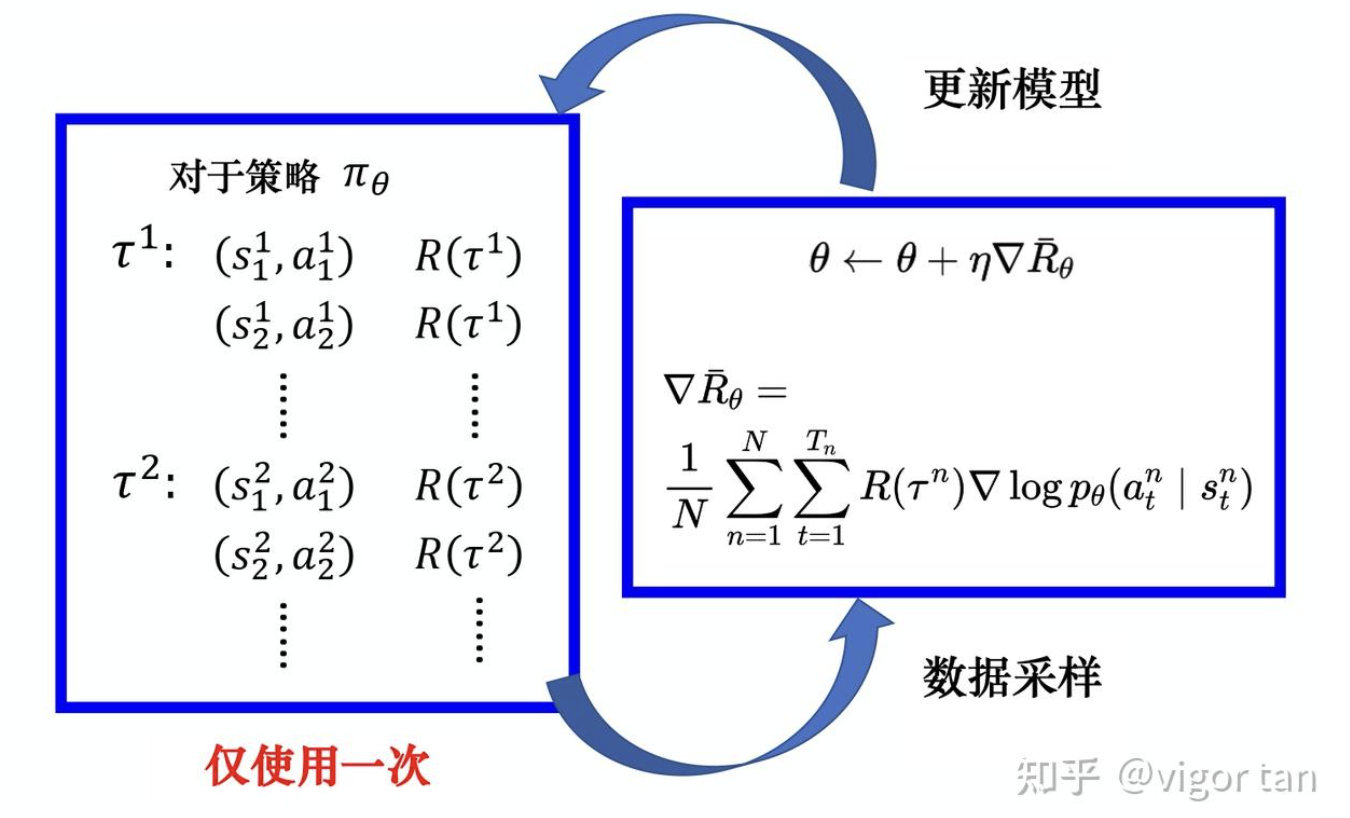
图片展示了PPO算法的流程。左侧为数据采样部分,对策略πθ进行采样,得到τ1、τ2等轨迹,每个轨迹包含状态、动作及奖励,仅使用一次。右侧为更新模型部分,通过公式θ←θ+η∇Rθ更新模型参数θ,其中∇Rθ为Rθ的梯度,Rθ由N个轨迹的奖励R(τn)和动作概率对数的梯度计算得出。该图与上下文介绍的PPO算法相呼应,直观呈现了其采样与模型更新的步骤。

与之相对应的就是off-policy方法,比如我们使用一个冻结的策略模型(离线模型)采样,更新目标策略模型(在线模型),离线模型定期与在线模型同步,这样的话样本能利用多次(A2C)。但是使用的时候需要加上重要性采样(Importance Sampling):
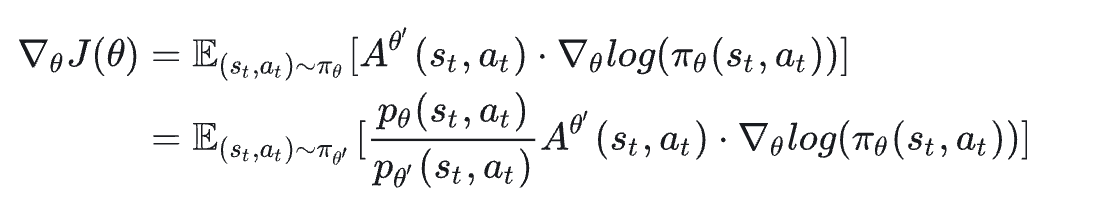
图片展示了PPO算法中目标函数的计算公式。公式为J(θ)的梯度,等于离散时间t状态下,根据策略πθ选择动作at时,期望Aθ'(st,at)与策略πθ的对数概率梯度的乘积;也可表示为离散时间t状态下,根据策略πθ'选择动作at时,Aθ'(st,at)与两个策略概率比值的乘积。该公式是PPO算法中策略优化的核心,与上下文介绍的PPO算法目标函数计算紧密相关。

Importance Sampling

Importance Sampling可以通过采样另一个分布来估计当前分布的期望,但是它的一个问题是如果两个分布的差别太大的话,需要采样非常多的样本才能做到准确的估计,所以PPO就限制了旧策略和新策略两个分布的差异,有两种限制的办法:

1、Clip:
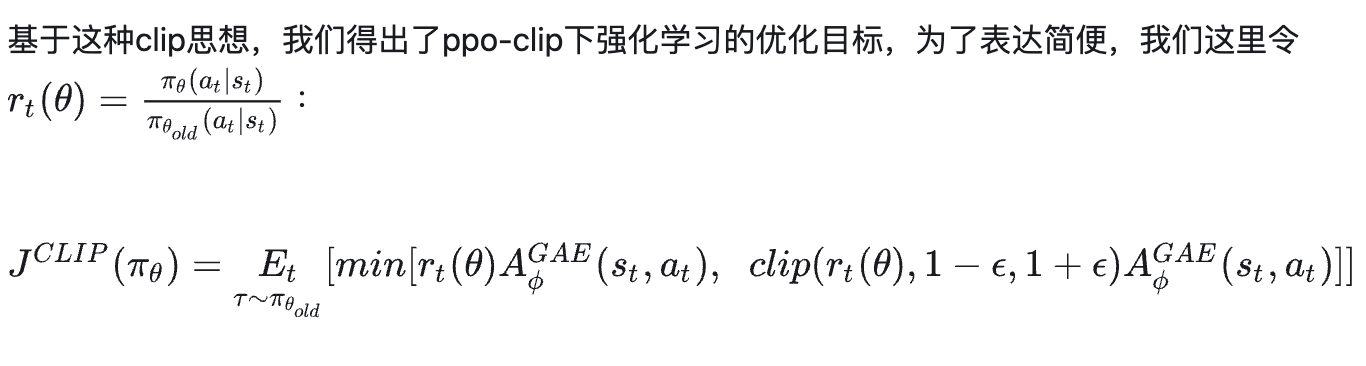
图片展示了PPO算法中clip策略优化目标的公式推导。在PPO - CLIP下强化学习的优化目标中,令r_t(θ) = πθ(a_t|s_t) / πθold(a_t|s_t),则JCLIP(πθ) = Et[τ~πθold min[r_t(θ)AφGAE(st,at), clip(r_t(θ), 1 - ε, 1 + ε)AφGAE(st,at)] ]。该公式用于限制旧策略和新策略两个分布的差异,是PPO算法中的一种重要采样方法。

2、KL Divergence正则项penalty:

图片展示的是PPO算法中的目标函数公式。公式为arg max_πθ J(πθ) = Eτ~πθold [πθ(a_t|s_t)AφGAE(s_t, a_t) - βKL(πθold(.|s_t), πθ(.|s_t))]。其中,πθ为策略函数,J(πθ)为目标函数,Eτ~πθold表示在旧策略πθold下对τ的期望,AφGAE(s_t, a_t)是优势函数,βKL为KL正则项系数,KL(πθold(.|s_t), πθ(.|s_t))是两个策略的KL散度。该公式是PPO算法优化策略的核心表达式。

RLHF

以上就是PPO的原理,具体怎么用在LLM上的呢,总体步骤如下:

#输入:一个奖励模型rm,一个语言模型LM,一个prompt语料库从LM初始化模型: actor, critic, ref。ref和rm不更新参数.
for i in train_epochs:
    采样一批prompt, 用actor模型解码生成文本, 再用actor模型得到生成的每个token的logits: actor_logits,同时用ref model生成每个词的logits:ref_logits, 奖励模型打分得到奖励(生成完整答案时的奖励)reward_score,用critic模型得到生成当前句子的每个token的Value.
    for j in ppo_epochs:
        用上面生成的文本计算优势,利用PPO算法更新actor和critic模型.
根据上面的原理部分,首先需要计算GAE:

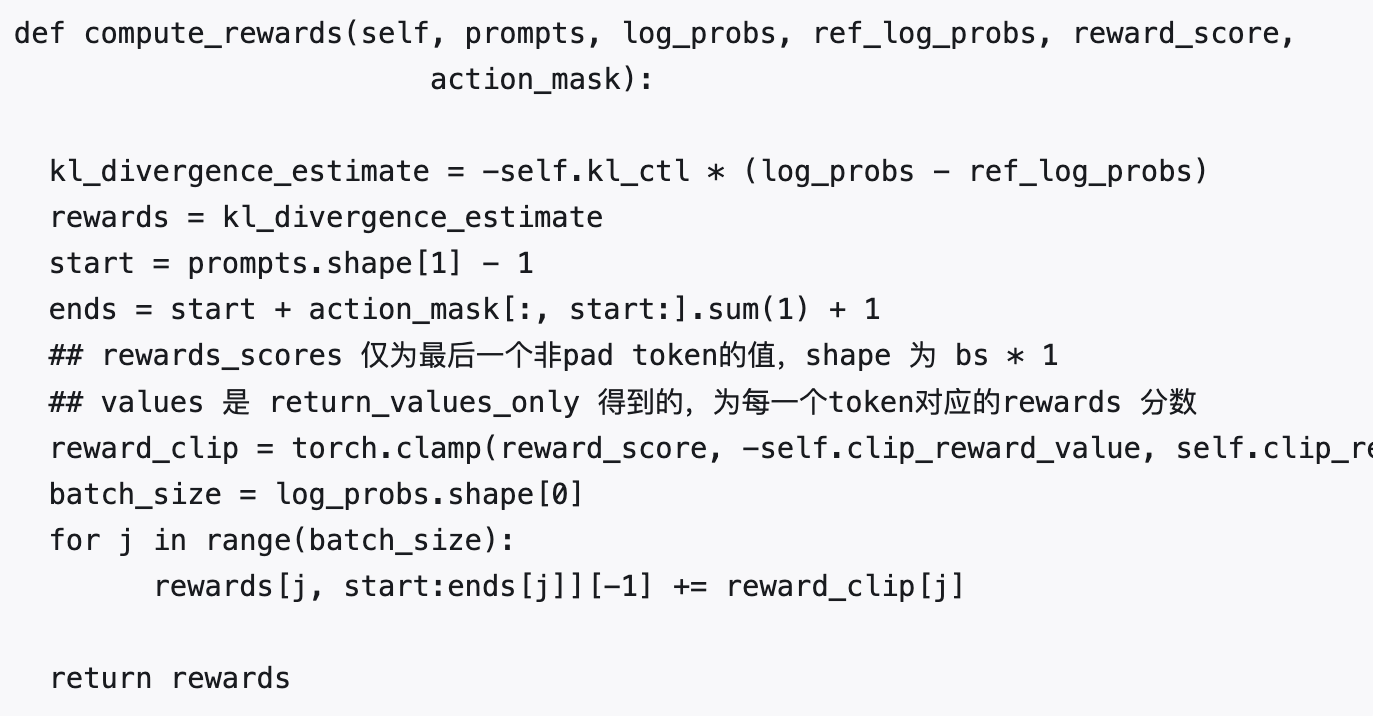
1、每个token的reward的值为:(等价于KL正则项)
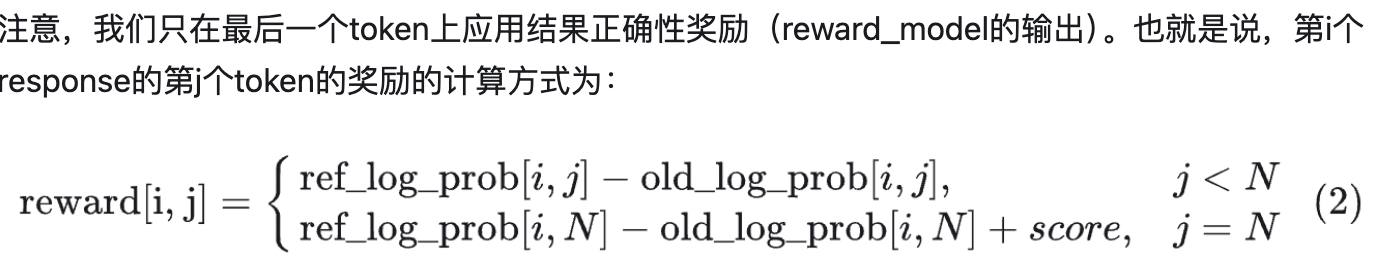
图片展示了PPO算法中计算每个token奖励的公式。公式分为两部分,当j < N时,reward等于ref_log_prob[i,j]减去old_log_prob[i,j];当j = N时,reward等于ref_log_prob[i,N]减去old_log_prob[i,N]加上score。其中,i代表response的序号,j代表token的序号,N为response的总token数。该公式与上下文紧密相关,是对上文提到的计算每个token奖励值的原理说明,用于更新actor模型。

图片展示的是一个名为compute_rewards的函数代码,用于计算每个token的reward值。函数接收prompts、log_probs、ref_log_probs、reward_score、action_mask等参数。关键部分是计算kl_divergence_estimate,即KL正则项,然后将该值赋给rewards。接着通过start和ends变量确定非pad token的范围,对reward_score进行torch.clamp操作,得到reward_clip,最后将reward_clip累加到对应token的reward中。该函数与上文提到的计算每个token的reward值相呼应。

Tips:1、 Reward 值一般clamp一下防止太大或者太小(或者除标准差也行)。

2、用critic model得到所有token的Value值,然后计算GAE。
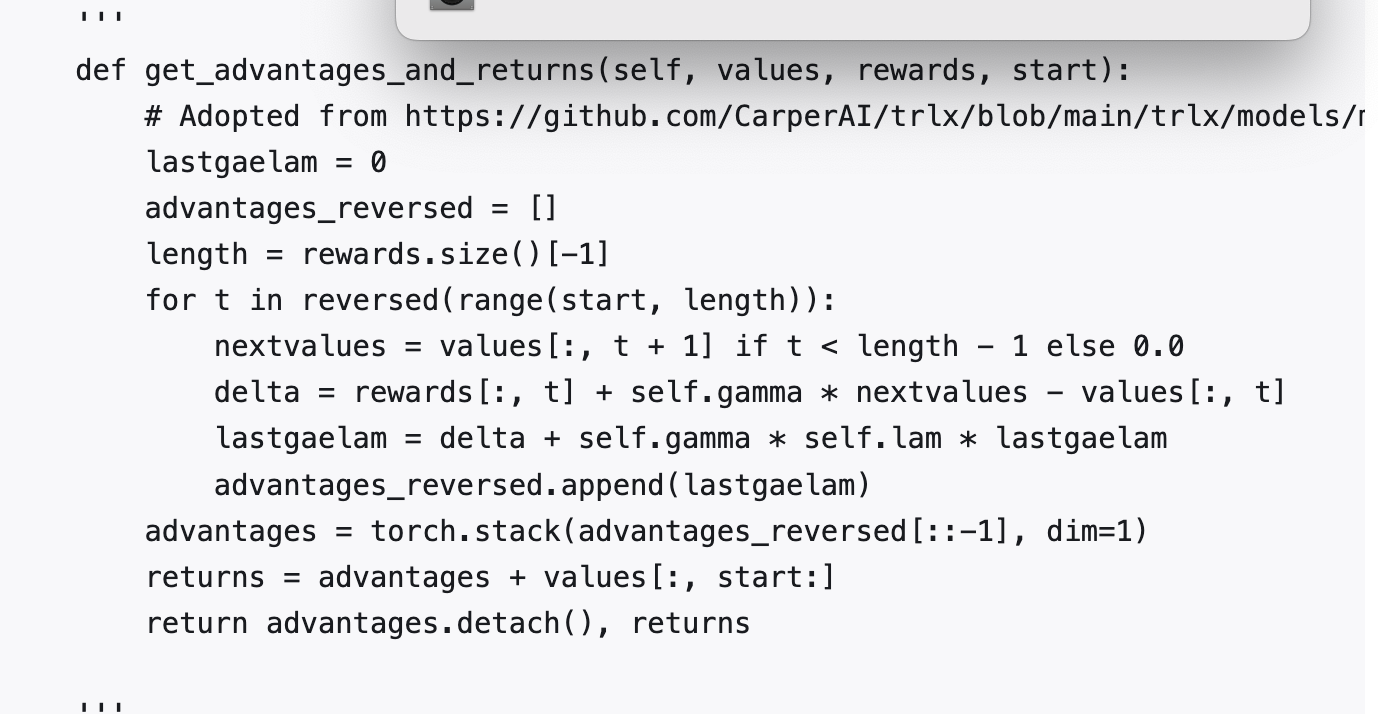
图片展示的是一个Python函数代码片段,名为get_advantages_and_returns,位于文档中计算GAE(Generalized Advantage Estimation)的上下文。函数接收values、rewards、start等参数,计算并返回advantages和returns。关键部分包括计算delta、lastgaelam、advantages_reversed等,最后通过torch.stack将advantages_reversed逆序排列并拼接,再与values拼接计算returns。该代码与上下文紧密相关,用于实现GAE计算过程。

Tips: 1、critic模型通常用reward model初始化。2、value取得后要记得去掉padding和注意mask掉prompt部分

然后,更新actor模型:
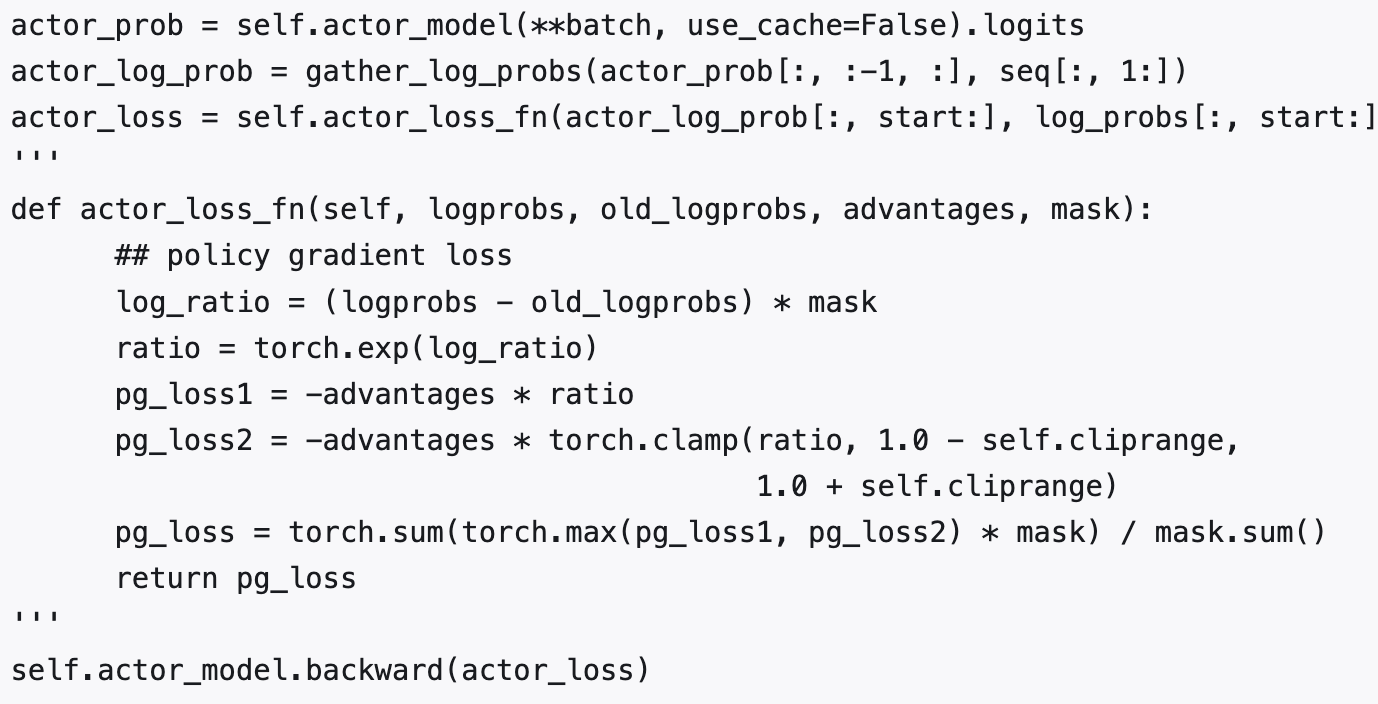
图片展示的是PPO算法中actor模型更新的代码片段。代码定义了actor_loss_fn函数,用于计算策略梯度损失。首先计算log_ratio,再通过torch.exp得到ratio,接着计算pg_loss1和pg_loss2,最后通过torch.sum求和并除以mask.sum得到最终的pg_loss。此外,还展示了调用actor_loss_fn函数计算actor_loss,并对actor_model进行反向传播。该图片与文档中更新actor模型的内容紧密相关,直观呈现了计算过程。

Tips:1、注意计算loss的时候要把log取e的指数再去掉,因为目标loss里是取的比值,不是log后相减。

最后,更新critic模型:
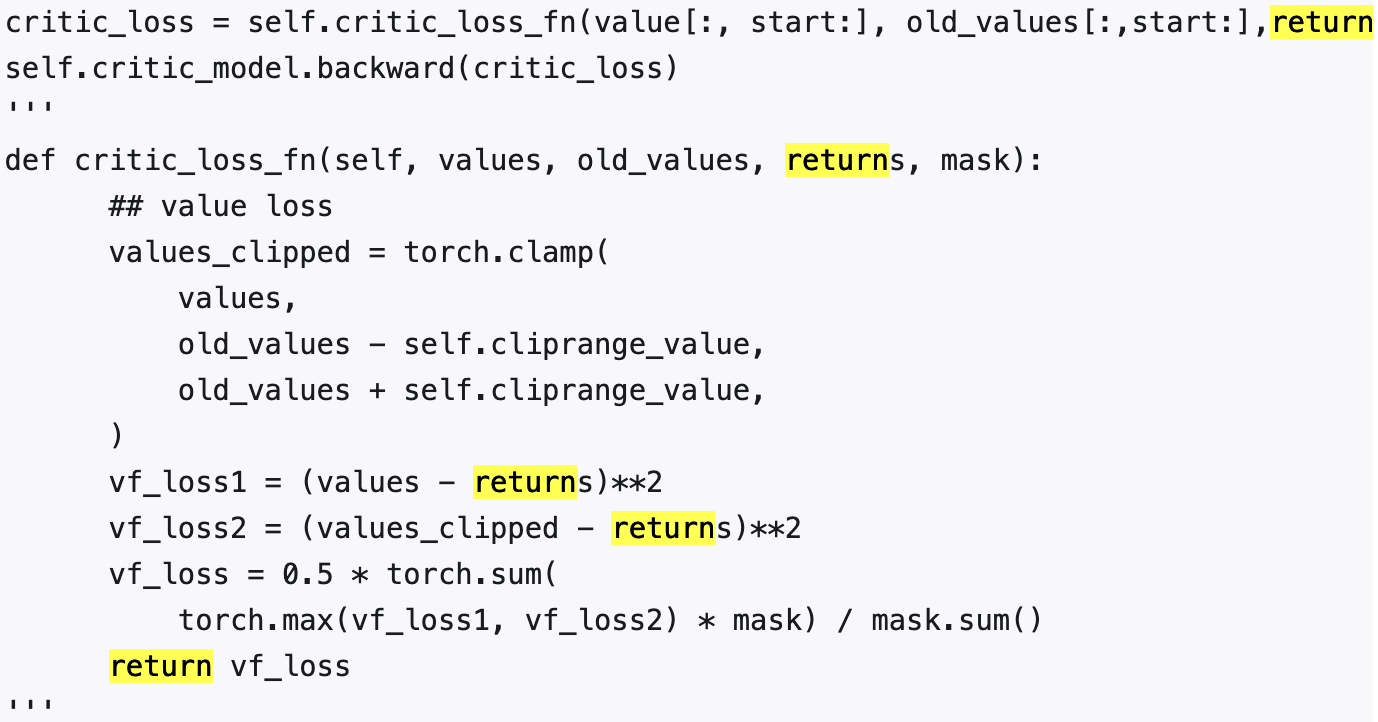
图片展示的是RLHF中PPO算法中critic模型更新的代码片段。代码定义了critic_loss_fn函数,计算critic的loss。关键部分是计算value loss,通过将values与returns相减取平方,得到vf_loss1和vf_loss2,再取最大值并乘以mask,最后除以mask的和,得到最终的vf_loss。代码中还对values进行了clipping操作。该图片与上下文紧密相关,是对上文提到的更新critic模型步骤的代码实现说明。

Tips: 1、returns是经过gae修订后的总收益值。2、Value同样会做Clipping,并且最终loss为clip和未clip两个loss的更大值

当然,RL还有一些其他的一些trick可以参考,比如对advantage进行标准化,actor loss增加策略熵正则项来提升exploration能力。

GRPO

GRPO是deepseek采用的RL方法,它和PPO的区别为:

1、每个prompt都采样生成一组答案,每个组内部单独计算GAE,所以目标变为:
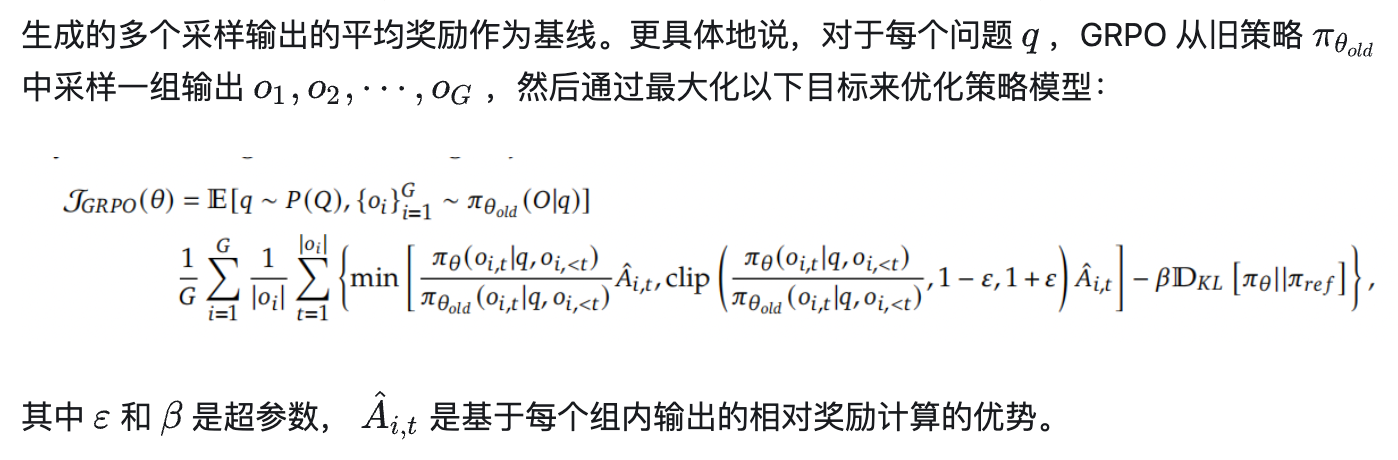
图片展示了GRPO优化策略模型的目标公式。对于每个问题q,GRPO从旧策略中采样一组输出,将生成的多个采样输出的平均奖励作为基线,通过最大化特定目标优化策略模型。公式中,ε和β是超参数,Âᵢ,ₜ是基于组内输出相对奖励计算的优势。图片内容与上文提到的GRPO目标相呼应,详细呈现了其数学表达,是对GRPO目标在数学层面的具体阐述,帮助理解GRPO在优化策略时的计算原理。

2、GAE的计算不使用critic模型去预测,而是直接使用reward在同组上的归一化值代替。
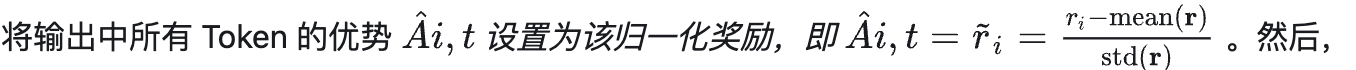
图片展示了GRPO方法中将输出中所有Token的优势设置为归一化奖励的计算公式。公式为:将输出中所有Token的优势A_i,t设置为该归一化奖励,即A_i,t = r_i = (r_i - mean(r)) / std(r) 。该图片与上文介绍的GRPO方法相关,是对上文提到的GAE计算不使用critic模型,而是直接使用reward在同组上的归一化值代替这一内容的数学表达,直观呈现了归一化奖励的计算方式。

这里的Intuiation是使用一个需要学习的critic模型去预测每个token的Value很难做到很精确,所以干脆去掉critic模型;同一个prompt生成不同的答案的reward model来评估哪些生成是好的,为了使不同prompt之间的reward是可比的,就用同一个组的不同reward计算均值和标准差来归一化。注意这里同一个答案的每个token的A是相同的,也就是说一个答案更好,它生成每个token都相同的好,差的都一样的差。

3、GRPO目标函数里的KL正则,不是像PPO一样加在reward里的,而是直接加在actor优化的loss中的,如果加在loss中就需要用采样的方法来进行估计KL梯度,GRPO在形式上采用K3形式的KL估计(by john schulman),但是实际已经有人在知乎上抛出其实k2形式的估计才是KL梯度的无偏估计,效果更好。
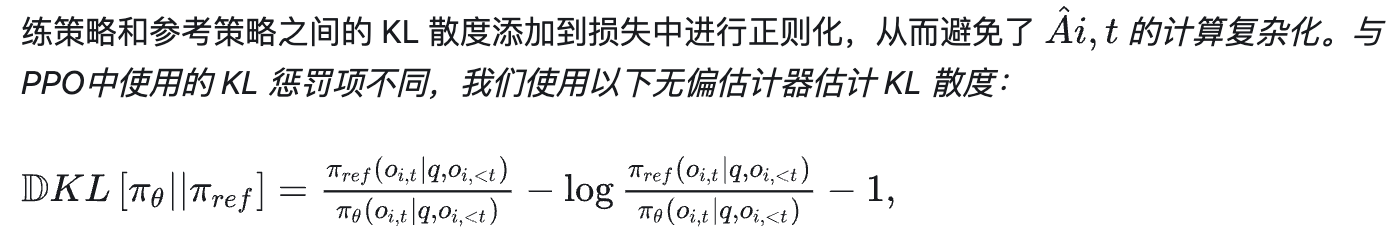
图片展示了GRPO目标函数中KL正则的计算公式。公式为狄利克雷散度KL散度,计算方式是参考策略πref在给定状态o_i,t、动作q和历史动作o_{i, < t}时的值,除以当前策略πθ在相同条件下的值,再减去参考策略与当前策略比值的对数,最后减1。该公式与PPO中使用的KL惩罚项不同,GRPO采用此无偏估计器来估计KL散度,以简化PPO训练难度,便于收敛和规模扩展。

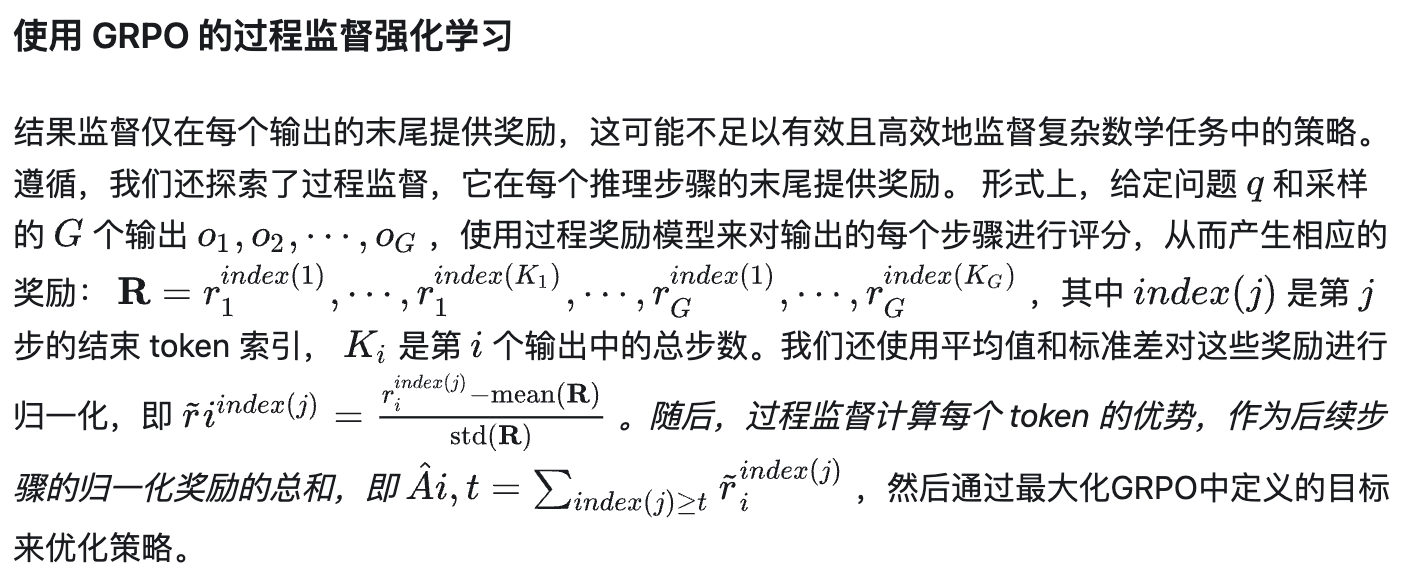
4、GRPO可以很好的适配到过程监督中:

图片介绍了使用GRPO(Generalized Reward-Process Optimization)进行过程监督强化学习的内容。它指出结果监督仅在每个输出的末尾提供奖励,可能不足以有效监督复杂数学任务中的策略,因此引入过程监督,它在每个推理步骤的末尾提供奖励。形式上,给定问题q和采样的G个输出,使用过程奖励模型对输出的每个步骤进行评分,产生相应奖励。还对奖励进行归一化处理,计算每个token的优势,通过最大化GRPO中定义的目标来优化策略。

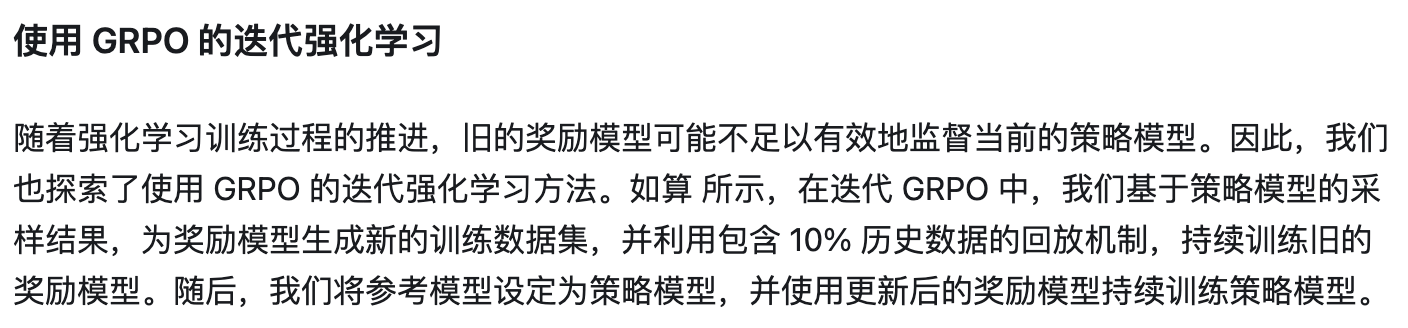
5、GRPO的奖励模型也是要迭代更新的:

图片展示了使用GRPO的迭代强化学习方法。随着强化学习训练过程推进,旧奖励模型可能不足以有效监督当前策略模型,因此探索了此方法。在迭代GRPO中,基于策略模型采样结果生成新训练数据集,利用含10%历史数据的回放机制持续训练旧奖励模型,随后将参考模型设定为策略模型,使用更新后的奖励模型持续训练策略模型。该图与上下文紧密相关,直观呈现了GRPO迭代强化学习的训练流程。

总结:GRPO做的优化是在简化PPO训练的难度,来达到更容易收敛和scale的目的。其实目前在对RLHF的优化上很多的优化都是在降低训练难度,下面的改进方法也都是。

Reinforce++

Reinforce++可以看成PPO的简化版,它使用了PPO的Loss,但是GAE的计算同样舍弃了critic模型的部分,而是直接由reward计算得到:A(st,at)=∑t′=tTrtA(s_t, a_t)=\sum_{t^{'}=t}^{T}r_t,注意这里没有加折扣系数(因为折扣系数的影响不大),相当于GAE的λ和γ\lambda和\gamma都为1。同时增加了很trick来增加训练稳定性。实验结果显示Reinforce++比GRPO更稳定,并能达到比肩PPO的性能。Reinforce++使用的trick包括:

1、Token level KL-penalty

这个reward的计算跟PPO是相同的,将KL的计算加在reward shaping上:
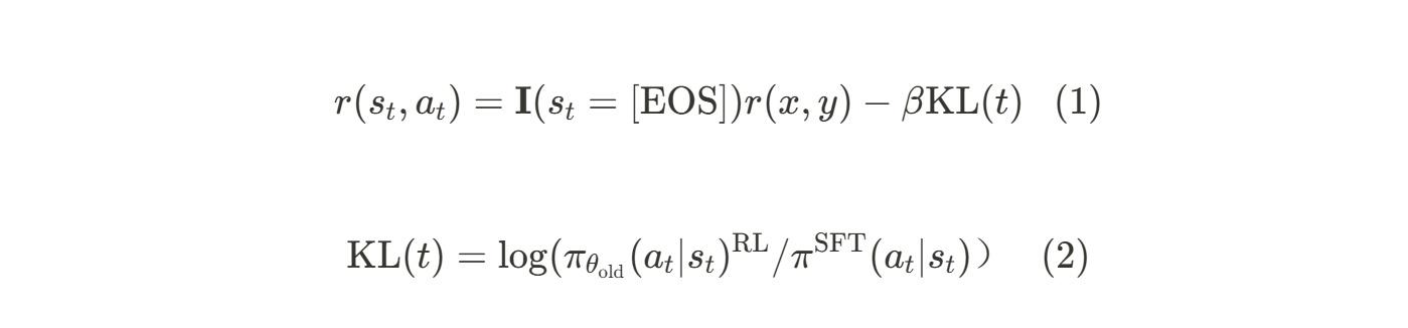
图片展示了Reinforce++算法中用于计算奖励的公式(1)和KL散度(2)。公式(1)为r(s_t, a_t) = I(s_t = [EOS])r(x, y) - βKL(t),其中I(s_t = [EOS])为当s_t为[EOS]时的指示函数,r(x, y)为奖励函数,β为惩罚系数,KL(t)为KL散度。公式(2)为KL(t) = log(π_θ_old(a_t|s_t)^RL / π^SFT(a_t|s_t)),表示两个策略在给定状态s_t和动作a_t时的对数比值。这两公式是Reinforce++算法中用于调整奖励和控制策略差异的关键计算。

2、mini-batch updates

基本是常见的训练技巧:

- 小批量样本:将训练数据划分为多个小批量(mini-batch),而不是使用整个数据集进行更新。

- 频繁更新:通过在每个小批量上进行多次参数更新,可以更快地收敛,同时减少内存消耗。

- 随机性引入:小批量更新引入了随机性,有助于避免局部最优解,提高模型的泛化能力。

3、Reward Normalization and clipping

PPO的技巧

4、PPO-clip

Importance sampling+clipping保持新旧策略分布接近
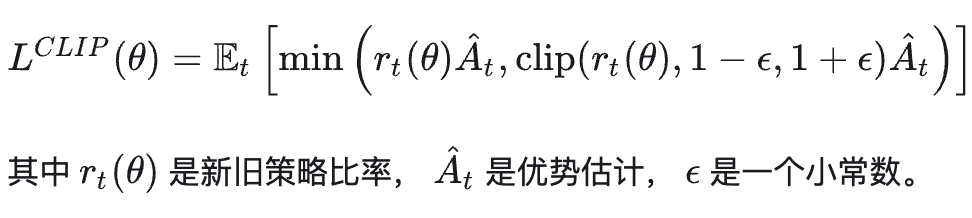
图片展示了PPO-clip的损失函数公式,即LCLIP(θ) = E_t [min(r_t(θ)A_t, clip(r_t(θ), 1 - ε, 1 + ε)A_t)] 。其中r_t(θ)是新旧策略比率,A_t是优势估计,ε是一个小常数。该公式与上下文紧密相关,上下文提到PPO-clip是通过引入优势估计和策略剪裁来保持新旧策略分布接近,此公式正是其损失函数表达,直观呈现了PPO-clip的计算逻辑。

5、Advantage 归一化

Advantage定义为整条输出答案的reward值减去当前token之后的KL reward之和,这是符合Token level KL-penalty部分中Reinforce++的reward的定义的,intuiation是当前token之后跟SFT模型的输入分布差别越小,收益越大。
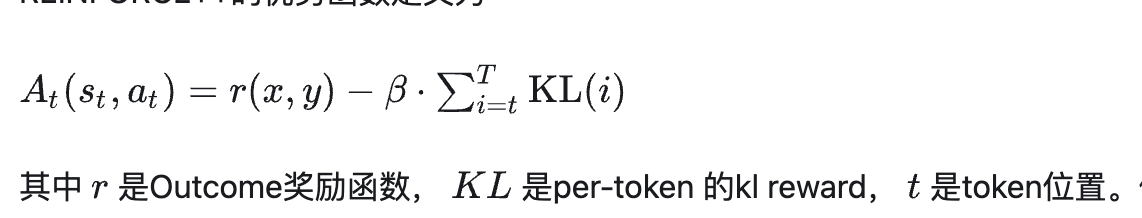
图片展示了Reinforce++的优劣函数定义公式。公式为A_t(s_t, a_t) = r(x, y) - β ∑_i=t^T KL(i),其中r是Outcome奖励函数,KL是per-token的kl reward,t是token位置。该图片与文档中介绍Reinforce++的内容相关,是对文档中提到的Reinforce++奖励定义的数学表达,直观呈现了其计算方式,帮助理解其在模型训练中的作用。

然后对Advantage要做同batch的归一话处理。

DAPO

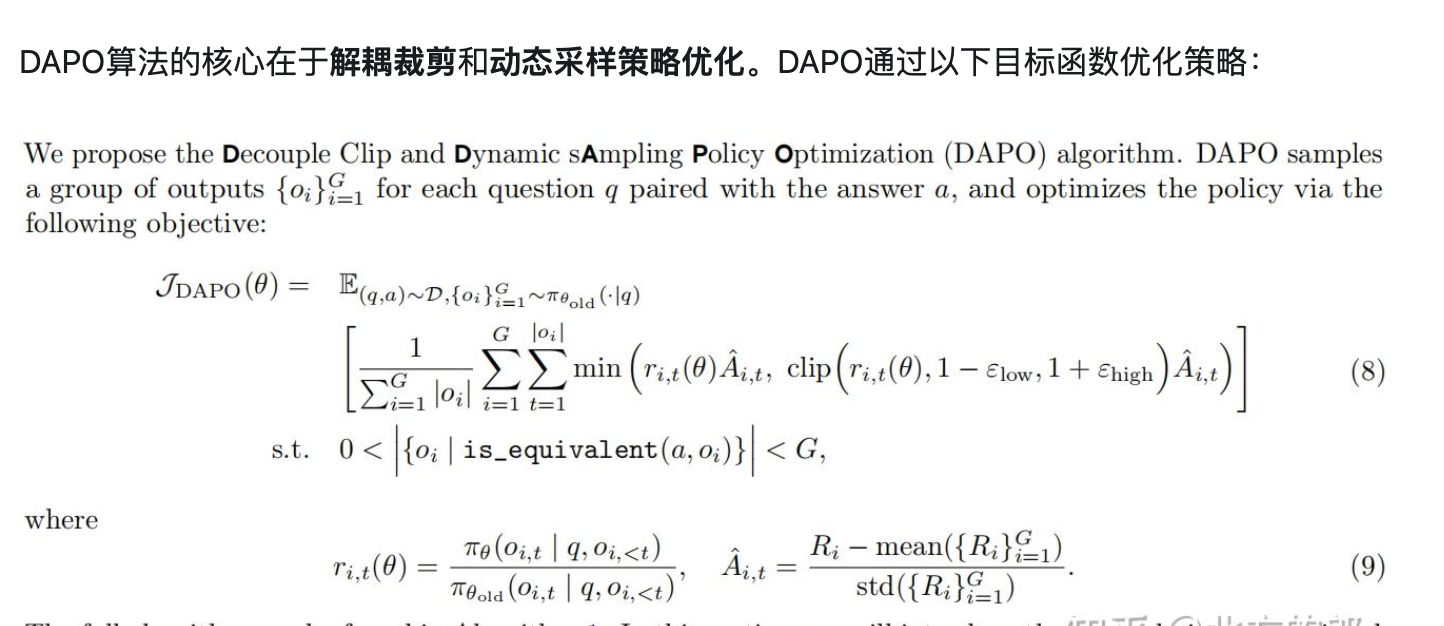
最近看字节公布的一个新的RL算法DAPO,DAPO实际上还是延用了GRPO的大部分思路,不过在LongCoT的实际操作上做了一些变动(猜测了GRPO可能并未公布的一些训练技巧),这些变动包括:

1、loss的变化:token-level的策略损失,注意跟GRPO的区别在归一化上,有点类似gradient accumulation的两种做法,理论正确的归一化做法会效果更好一些(l1+l2+l3m1+m2+m3\frac{l_1+l_2+l_3}{m_1+m_2+m_3}和13∗l1m1+13∗l2m2+13∗l3m3\frac{1}{3}*\frac{l_1}{m_1}+\frac{1}{3}*\frac{l_2}{m_2}+\frac{1}{3}*\frac{l_3}{m_3},后者的计算会缩小长文本的loss,所以对长文本loss的BP不友好)。

图片展示了DAPO算法优化策略的目标函数公式。公式中,DAPO通过采样一组输出{oi}G i=1,对每个问题q配对答案a进行优化,目标函数为JDAPO(θ)。公式包含对每个样本的奖励r和动作概率A的计算,以及对等价输出数量的约束条件。其中,r i,t(θ)为在时间t的奖励,A i,t为动作概率,R i为奖励,εlow和εhigh为阈值。该公式与上下文紧密相关,是对DAPO算法核心优化策略的数学描述。

2、删除KL的正则约束,因为长链式推理模型的训练中,模型分布可能会显著偏离初始模型,所以这种限制并不必要。

3、Clip-Higher策略:因为策略训练中熵崩溃,所以需要增加探索空间,于是对clip上界设置的更高一些,加大对新token的激励。

4、动态采样:通过动态采样策略,过滤掉准确率为1和0的提示,确保每个批次中的提示都具有有效的梯度信号。

5、Overlong Reward Shaping:保证训练稳定
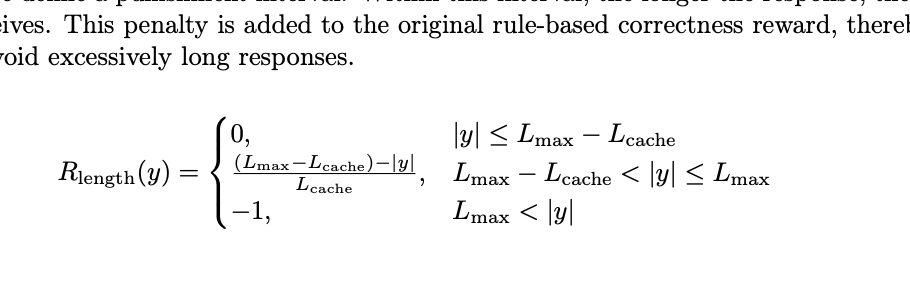
图片展示了长文本奖励函数公式,用于避免过长响应。公式中,当响应长度|y|小于等于最大长度L_max减去缓存长度L_cache时,奖励为0;当响应长度大于L_max - L_cache且小于等于L_max时,奖励为(L_max - L_cache - |y|)/ L_cache;当响应长度大于L_max时,奖励为-1。该公式与上下文提到的避免过长响应策略相呼应,是长链式推理模型训练中防止模型生成过长回答的措施之一。

DPO

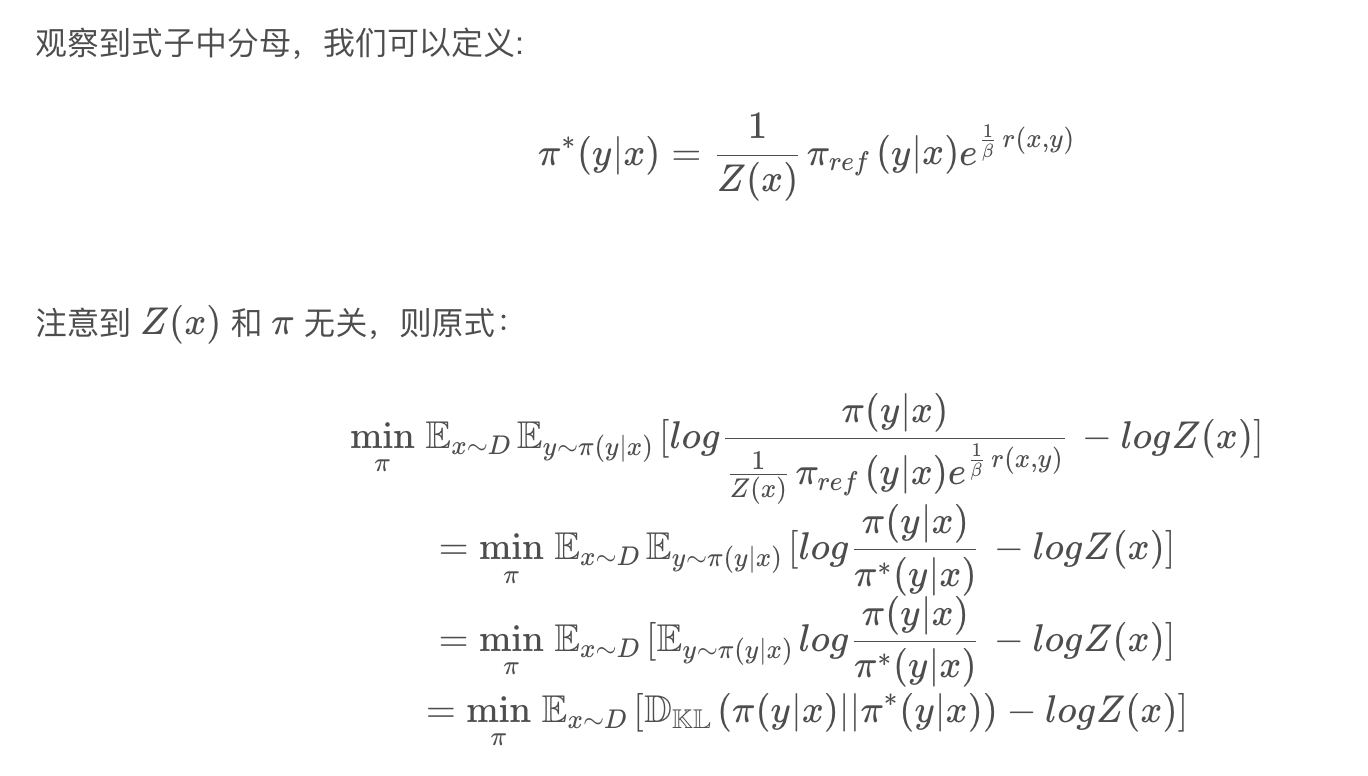
DPO的创新点在于直接根据人类的偏好来优化语言模型,不用显示训练reward model。它的推导分两步:

一、从RLHF的目标函数去推导最优的策略(将KL展开, reward作为确定值, 策略作为求解的变量):
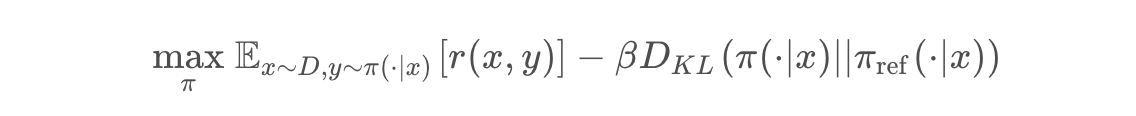
图片展示的是RLHF目标函数的推导公式。公式为在π下对x和y的期望奖励r(x, y)减去β倍的KL散度DKL(π(·|x) || πref(·|x))。该公式是RLHF从目标函数出发推导最优策略的步骤之一,即在给定参考策略πref的情况下,寻找使奖励期望最大化的策略π。此公式与上下文紧密相关,是上下文介绍的RLHF目标函数推导内容的核心表达式。

图片展示了DPO(Diverse Policy Optimization)中推导最优策略时的数学公式。公式为最小化π关于x和y的期望值,其中包含对数项和Z(x)项。Z(x)是求和表达式,对所有y求和,y的概率分布为π_ref(y|x)乘以指数项e^(1/β)r(x,y)。该公式是DPO推导最优策略的关键部分,与上下文提到的从RLHF目标函数推导最优策略相呼应,是后续计算最优策略和得到最终loss function的基础。

图片展示了DPO方法中从RLHF目标函数推导最优策略时的数学推导过程。首先定义了分母中的π*(y|x)表达式,接着指出Z(x)和π无关,从而简化原式。通过一系列等式变换,最终得到目标函数为π(x|y)与π*(y|x)的KL散度减去logZ(x)。该图片与上下文紧密相关,是对上文提到的将KL展开、将reward作为确定值、策略作为求解变量等推导步骤的数学呈现,是理解DPO方法推导过程的关键内容。

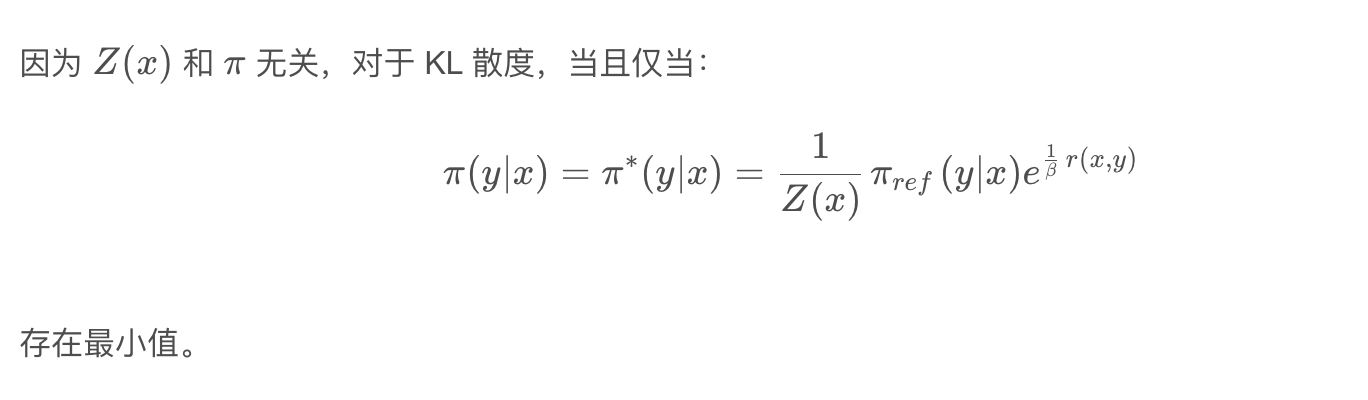
图片展示了RLHF目标函数中关于KL散度的推导内容。因Z(x)与π无关,当且仅当π(y|x) = π*(y|x) = 1/Z(x)πref(y|x)e^(1/3)r(x,y)时,KL散度存在最小值。这与上文提到的从RLHF目标函数推导最优策略时,将KL展开,reward作为确定值,策略作为求解变量的内容相关,是推导最优策略过程中对KL散度性质的说明。

所以最优策略就是上式,根据最优策略得到reward为:

图片展示的是RLHF目标函数中reward的计算公式。公式为r(x, y) = βlog(π_r(y|x)/π_ref(y|x)) + βlogZ(x),其中x为输入,y为输出,π_r(y|x)为参考策略的输出概率,π_ref(y|x)为参考策略的输出概率,Z(x)为归一化常数。该公式是RLHF目标函数推导中从最优策略得到reward的步骤之一,与上下文提到的将KL展开、reward作为确定值、策略作为求解变量等内容相呼应,是DPO推导过程中的关键数学表达。

二、把reward作为BT模型需要优化的参数,得到最终的loss function:

p∗(y1≻y2∣x)=er∗(x,y1)er∗(x,y1)+er∗(x,y2)=σ(r∗(x,y1)−r∗(x,y2))p^∗(y_1≻y_2|x)=\frac{e^{r^∗(x,y1)}}{e^{r^*(x,y_1)}+e^{r^∗(x,y_2)}}=\sigma(r^*(x,y_1)-r^*(x, y_2))

直接对所有偏好对进行最大似然估计:

图片展示了DPO(Diverse Policy Optimization)中负对数似然损失函数的推导公式。对于所有数据对D = {x^(i), y_ω^(i), y_l^(i)}(i=1到N),根据极大似然估计,损失函数L(r, D)为所有数据对中r(x, y_ω) - r(x, y_l)大于0的n次方的乘积。公式中σ为Sigmoid函数,r(x, y_ω)和r(x, y_l)分别代表策略对x和y_ω、y_l的奖励。该图片与上下文紧密相关,是对DPO推导中负对数似然损失函数部分的数学表达。

取对数、取负就得到了负对数似然损失函数:

图片展示的是负对数似然损失函数公式,即L_R(r_φ, D) = -E_((x, y_w, y_l)~D) log σ(r_φ(x, y_w) - r_φ(x, y_l))。该公式是DPO(Diverse Policy Optimization)方法中负对数似然损失函数的数学表达,用于计算模型在给定数据集D上,对所有偏好对(x, y_w, y_l)的负对数似然值。公式中σ表示Sigmoid函数,r_φ(x, y_w)和r_φ(x, y_l)分别代表模型对y_w和y_l的评分。此公式是DPO方法中计算损失函数的关键部分,与上下文介绍的DPO推导过程紧密相关。

带入最优策略的reward得到最终DPO的Loss为:

图片展示了最终DPO的Loss公式$L_{DPO}(\pi_{\theta};\pi_{ref}) = -\mathbb{E}{(x,y_w,y_l)\sim D} [\log \sigma (\beta \log \frac{\pi{\theta}(y_w|x)}{\pi_{ref}(y_w|x)} - \beta \log \frac{\pi_{\theta}(y_l|x)}{\pi_{ref}(y_l|x)})]$。该公式是在推导DPO的过程中,把reward作为BT模型需要优化的参数,经对偏好对进行最大似然估计,取对数、取负得到负对数似然损失函数,再带入最优策略的reward后得出。其在OpenRLHF代码中有相应实现,与后续介绍的KTO的数据形态和做法形成对比。

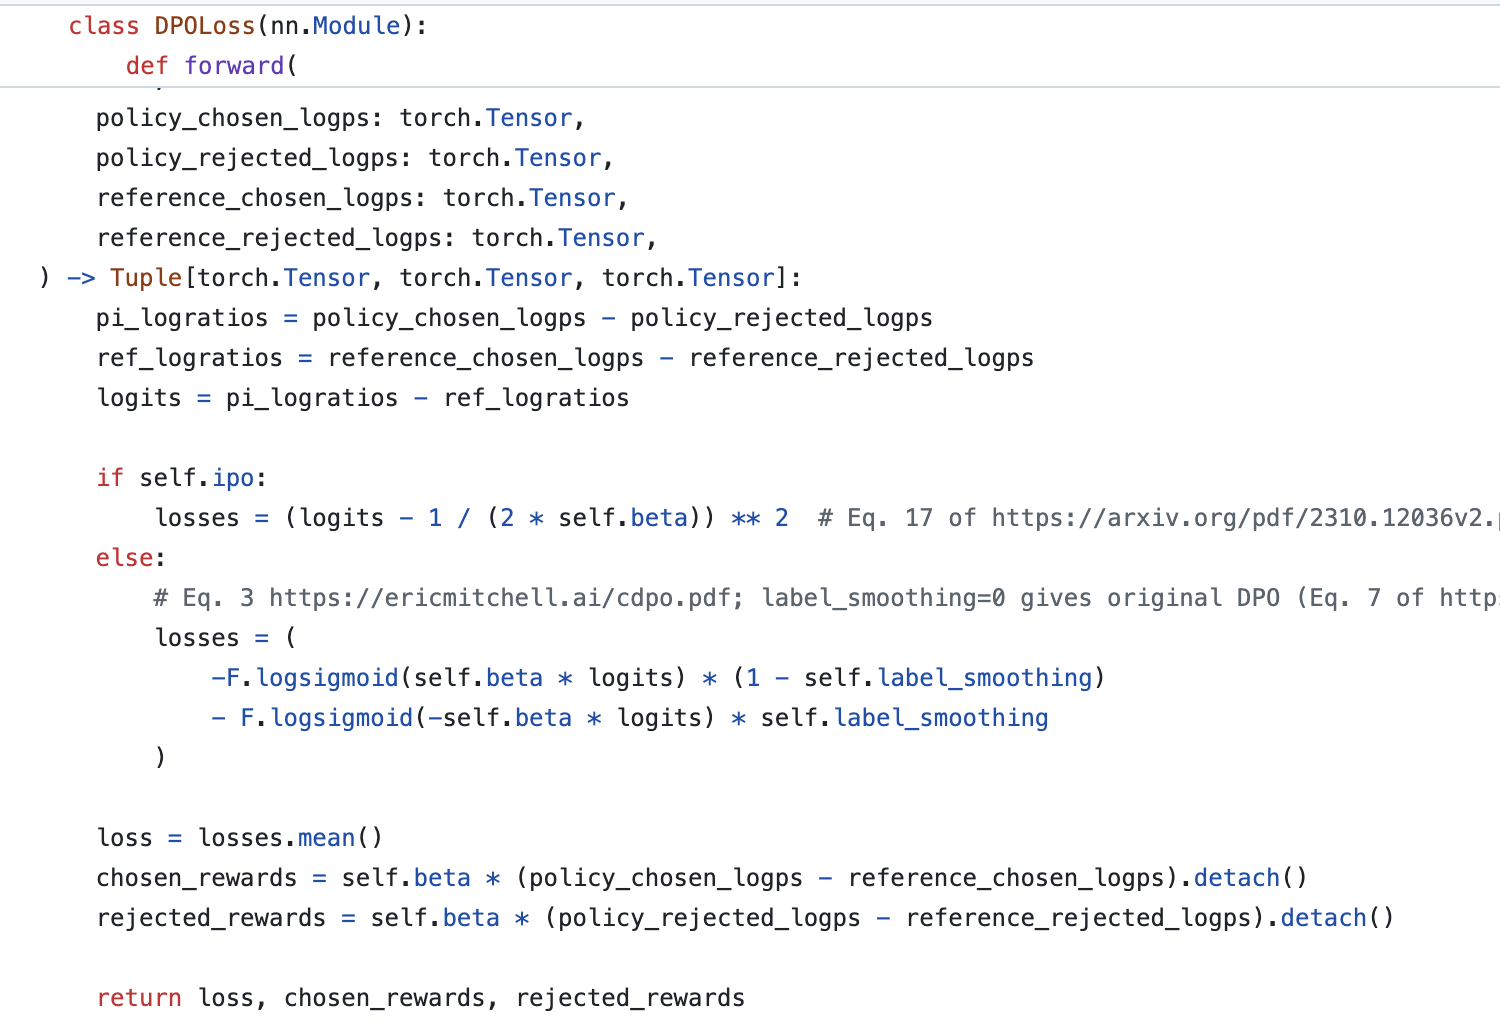
这个loss的实现非常简单,OpenRLHF代码如下:

图片展示的是OpenRLHF中DPOLoss类的代码。该类继承自nn.Module,包含forward方法,接收多个Tensor参数。在计算loss时,先计算pi和ref的logratios,再计算logits。若启用ipo,按特定公式计算losses;若不启用,按另一公式计算losses。最后计算并返回loss及chosen_rewards、rejected_rewards。此代码与文档中介绍的DPO Loss实现内容相关,直观呈现了DPO Loss的计算过程。

KTO

相比DPO依赖pairwise的数据去做对比去训练,KTO需要的数据形态就是只需要标注这个答案是不是所期望的就好了,具体做法也很简单,就是拆开DPO的loss,正样本计算chosen的loss,负样本计算rejected部分的loss:
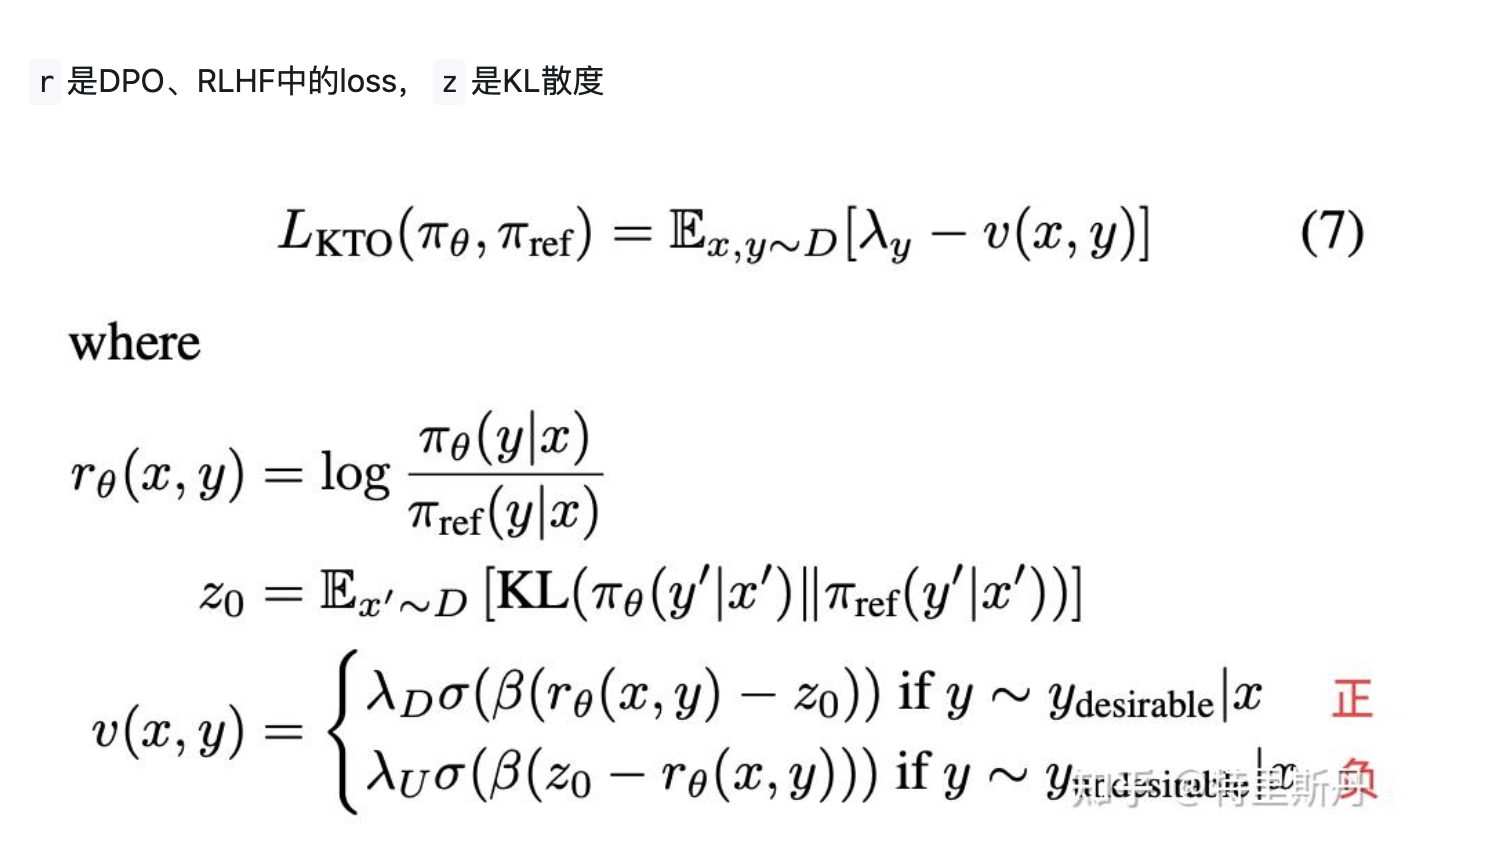
图片展示了KTO的Loss公式,是DPO、RLHF中的loss。公式为$L_{KTO}(\pi_{\theta},\pi_{ref}) = \mathbb{E}{x,y\sim D}[\lambda_y - v(x,y)]$,其中$r{\theta}(x,y) = \log \frac{\pi_{\theta}(y|x)}{\pi_{ref}(y|x)}$,$z_0 = \mathbb{E}{x'\sim D}[\text{KL}(\pi{\theta}(y'|x')||\pi_{ref}(y'|x'))]$,$v(x,y) = \begin{cases} \lambda_d\sigma(\beta(r_{\theta}(x,y) - z_0)) & \text{if } y \sim y_{\text{desirable}}|x \\ \lambda_u\sigma(\beta(z_0 - r_{\theta}(x,y))) & \text{if } y \sim y_{\text{undesirable}}|x \end{cases}$。图片与上下文紧密相关,直观呈现了KTO Loss的计算公式,帮助理解其在DPO、RLHF中的应用。

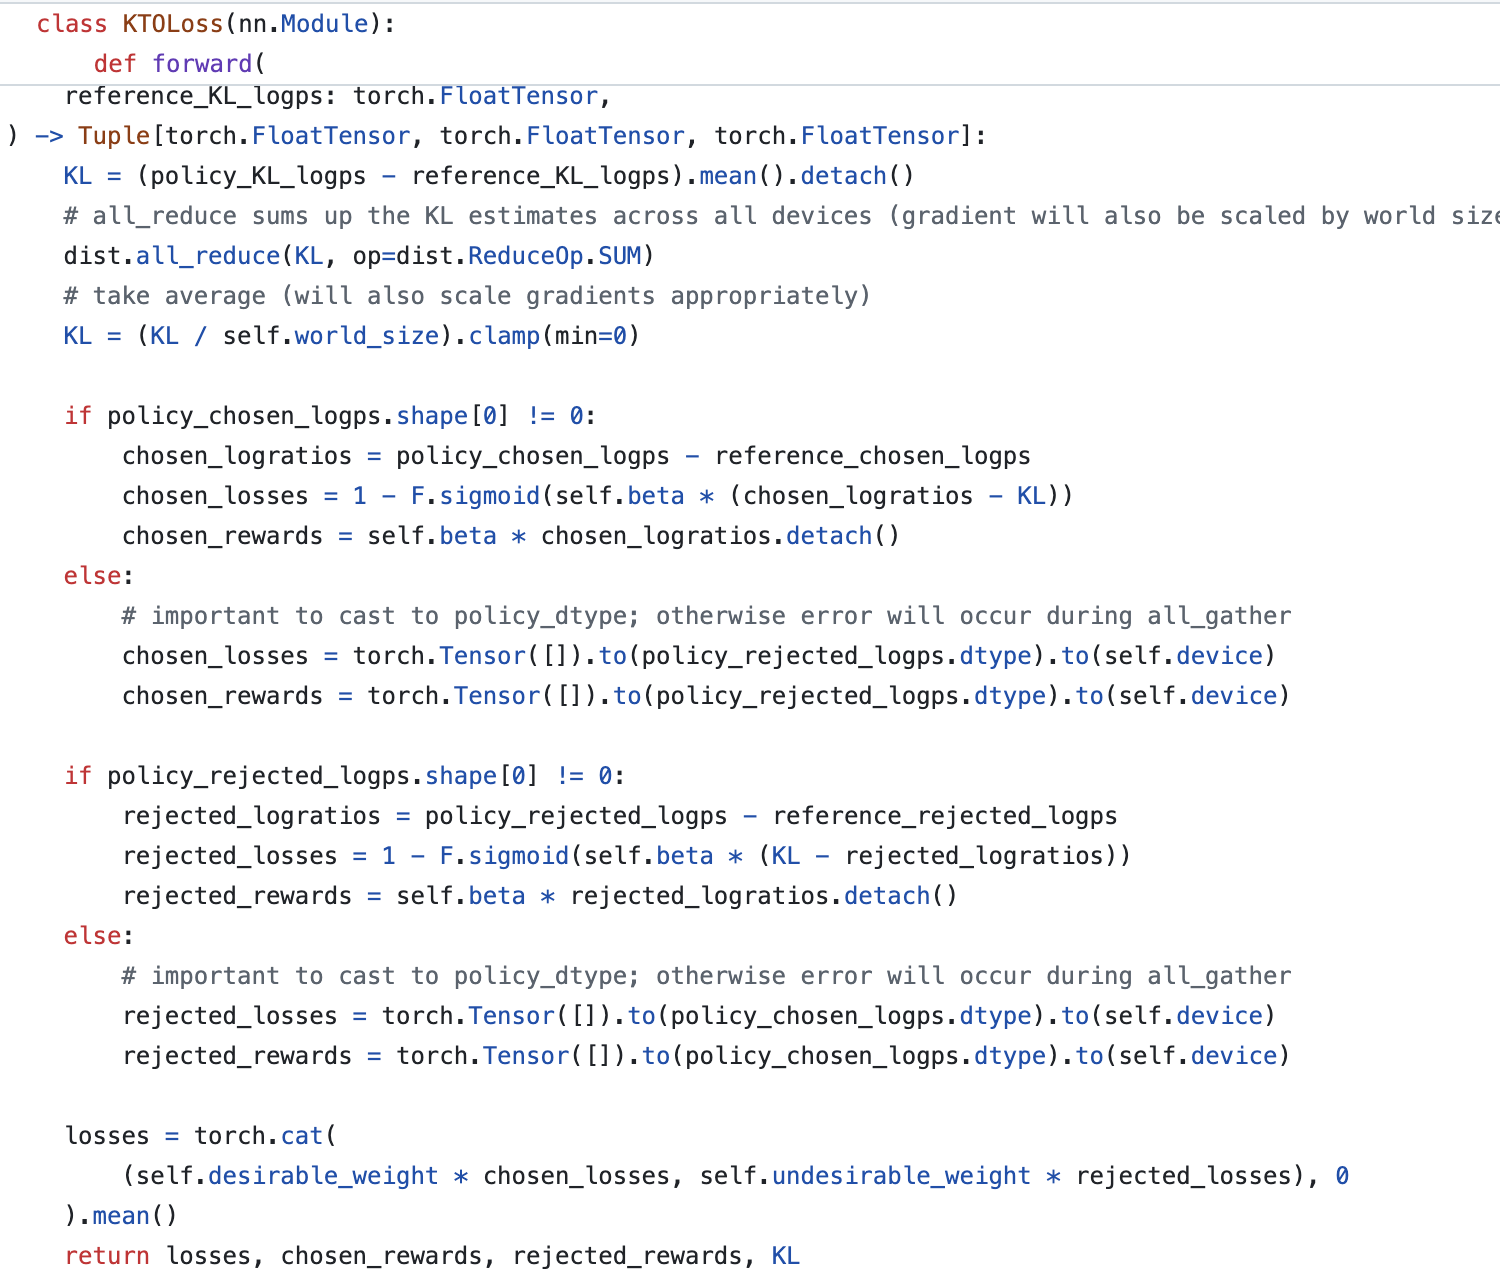
OpenRLHF中实现的代码如下:

图片展示的是OpenRLHF中KTOLoss类的代码实现。该类继承自nn.Module,包含def forward方法。代码中定义了reference_KL_logsps和KL等变量,通过计算KL、chosen_logs、chosen_losses、chosen_rewards、rejected_logs、rejected_losses、rejected_rewards等值,最后通过torch.cat函数将chosen_losses和rejected_losses按0维维度拼接,并计算其均值,返回losses、chosen_rewards、rejected_rewards和KL。此代码与文档中KTO训练方法相关,用于实现KTO的loss计算。

Conclusions

1、Human Feedback不是必须的,比如如果是数学或者编程可以直接获得最终反馈的(结果对or错),就不用人工标注反馈信号了。
2、Reward Model 也不是必须的,DPO和KTO可以不用显示的训练reward model,所以对于一些比较难以用准确衡量的优化目标(e.g.,reasoning, factuality, and instruction-following)可以用DPO去训练,而对于可以用reward衡量的目标(e.g.,truthfulness, helpfulness, conciseness, relevance, harmlessness and debiasing)可以使用PPO这样的强化学习,所以一般是post training阶段会使用两阶段训练(先offline-RL(DPO), 再online-RL(PPO) 参考《Qwen2.5 tech report》)。
3、RLHF的发展趋势是朝着更简单更容易scale up的方向的,去掉critic model同时使用其他的一些tricks增加性能和稳定性,可以使得RL更容易训练。但是很多时候有些trick并不一定work的,还是要自己去实验才行。
4、怎么通过RLHF有效学习多个preference目标呢?我们发现直接用一个reward model很多时候很难直接去学习,但是使用多个reward model的串行方法去学习时又会出现catastrophic forgetting的问题,所以我们的一篇paper讨论了这个问题,巧妙使用课程式构造多段对比数据可以实现另一种形式的rehearsal,从而在减少catastrophic forgetting的同时提升学习性能。(参考我们的paper 《Are U a Joke Master? Pun Generation via Multi-Stage Curriculum Learning towards a Humor LLM》 ACL findings 2024)
5、Long CoT的训练从SFT模型开始还是从Base模型开始?从Base模型训练可以有更好的exploration,但是采样效率可能会低,可能会无法收敛;从SFT模型训练可以有更好的采样效率,更容易收敛,但是最终效果上可能会差一些。同样SFT和RL的对比上也有类似的结论:SFT更会memorize但是容易过拟合,RL更能泛化但是不容易收敛,所以可以结合起来使用(《SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training》)
6、ORM vs PRM:在数学、coding等问题上,一般需要在Long CoT的训练数据上训练来提升推理效果,ORM只根据最终答案的正确性提供反馈,不关心推理过程;PRM对推理链中的每一步都提供反馈,确保整个思考过程正确。MCTS是一种对CoT的搜索策略。有以下结论:a、PRM的效果一般比ORM更好(符合直觉,PRM可以缓解”推理答案正确,但推理过程出现错误,但我们标注为正确”的情况),但是PRM的数据很难标注,因为要判断过程的好坏;所以从数据scaling的角度看ORM可能更适合Scale(参考 DeepSeek)。b、通过active learning标注难样本收益更大(符合直觉)(《Let's verify step by step》)c、PRM可以结合MCTS达到更好的效果(《rStar-Math: Small LLMs Can Master Math Reasoning with Self-Evolved Deep Thinking》)d、采用PRM和ORM的两段式监督会不会有更好的效果???(待验证),e、推理步骤的在隐空间进行是否就足够(参考Coconut),除了显示推理的压缩,有没有办法直接在隐空间推理?