《Why DPO is a Misspecified Estimator and How to Fix It》深度解读
二次解读。原文离线版:
ICLR 2026 Oral:DPO 从一开始就是错的!.md
一手来源:微信公众号原文 <https://mp.weixin.qq.com/s/3azAmLsNYaFP-Y58Q495aw>;论文 arXiv:2510.20413v1(2025-10-23)TeX 源码;作者主页标注 ICLR 2026 oral:<https://ece.iisc.ac.in/~aditya/research.html>;ICLR 2026 slides:<https://iclr.cc/media/iclr-2026/Slides/10008563.pdf>。
论文作者:Aditya Gopalan(IISc Bangalore)、Sayak Ray Chowdhury(IIT Kanpur)、Debangshu Banerjee(HP AI Research)。
结论先行
这篇论文证明的是一条比公众号标题更窄、也更有用的命题:DPO(Direct Preference Optimization,直接偏好优化)在表格型策略类(tabular policy class,即每个“提示词-回答”条件概率都可独立取值)下与两阶段 RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)的等价推导,不能无条件迁移到真实大语言模型使用的低维参数化策略类。论文把 DPO 写成奖励函数空间里的加权反向 KL(Kullback–Leibler)投影:当生成偏好数据的真实奖励函数不在策略类隐式奖励流形上时,DPO 的输出由投影方向和偏好对采样频次共同决定,可能出现偏好顺序反转、期望奖励低于初始策略、以及对训练数据配比高度敏感。
作者提出的修复方法 AuxDPO 给 DPO 的隐式奖励增加一组辅助变量 δ。这组变量被约束在策略梯度矩阵的零空间附近,用来吸收真实奖励中模型参数无法表达的分量。理论结果显示,在大 β 局部区域和精确优化假设下,加入 δ 后优化目标可以把策略推向两阶段 RLHF 的局部解;实验上,AuxDPO 在 RewardBench v2 和 MMLU-Pro 的 ID/OOD 设置中整体优于 DPO、IPO、DPOP,尤其在低训练参数比例、LoRA、只训练末层等能力受限场景收益更明显。
对工程实践的含义是:DPO 不是必然失败,但其稳定性依赖“真实奖励能否被当前策略参数隐式表达”和“偏好对覆盖比例是否恰好有利”。当训练能力被 LoRA、冻结层、小模型或数据配比限制时,应把 DPO 当作一个可能错配的估计器来监控,而不是当作 RLHF 的无条件等价物。
术语与实验角色
| 术语 | 定义 | 在论文中的角色 |
|---|---|---|
| Prompt / response | 输入提示 s 和候选回答 a。论文假设有限集合 S×A,大小为 m。 |
偏好比较的基本单位。 |
| Preference pair | 三元组 (s, a_w, a_l),表示在提示 s 下标注者或标注模型偏好 a_w 胜过 a_l。 |
DPO、IPO、AuxDPO 的训练数据。 |
| BTL 模型 | Bradley–Terry–Luce 偏好模型:`P(a≻a' | s)=σ(r*(s,a)-r*(s,a')),σ` 是 sigmoid。 |
Policy πθ |
参数为 θ∈R^d 的条件分布模型;LLM(large language model,大语言模型)中通常是 Transformer 加 softmax。 |
被对齐的对象。 |
Reference/base policy πθ0 |
对齐前的初始策略,常见为 SFT(supervised fine-tuning,监督微调)模型。 | KL 正则的锚点;DPO 隐式奖励在 θ0 处为 0。 |
| KL | Kullback–Leibler 散度,衡量两个概率分布的差异;文中也用于 Bernoulli 偏好概率之间的散度。 | 既出现在 RLHF 正则项,也出现在 DPO 的加权投影刻画。 |
| RLHF | Reinforcement Learning from Human Feedback,先训奖励模型 rφ,再最大化 E[rφ(s,a)] - β KL(πθ‖πθ0) 的两阶段流程。 |
论文用作对照的“理想局部解”。 |
| DPO | Direct Preference Optimization,直接偏好优化;用偏好对优化 β log πθ/πθ0 的差值。 |
论文分析对象。 |
| IPO / DPOP | 论文比较的两类直接对齐基线。IPO 来自 Azar et al. 2023 的 general preference paradigm;DPOP 来自 Pal et al. 2024 的 DPO-Positive 思路,强调避免 chosen 响应概率相对 base 下降。 | 实验对照方法。 |
| LoRA | Low-Rank Adaptation,低秩适配微调;只训练注入到线性层的低秩矩阵,显著降低可训练参数量。 | 低容量场景,放大 DPO 错配风险。 |
| Implicit reward | DPO 隐式奖励 `rθ^β(s,a)=β log(πθ(a | s)/πθ0(a |
Implicit reward manifold R^β |
所有可由 θ 生成的隐式奖励集合 {rθ^β},是 R^m 中至多 d 维的流形。 |
DPO 实际能搜索的奖励空间。 |
| Fisher information matrix | Fρ,θ0=E[∇logπθ0 ∇logπθ0^T],衡量策略分布对参数的局部敏感度。 |
局部 RLHF 更新等价于自然梯度。 |
Null space N(Aρ,θ0) |
满足 Aρ,θ0 r=0 的奖励方向集合;这些方向不改变局部策略目标。 |
AuxDPO 用来补足表达盲区的方向。 |
| AuxDPO | 在 DPO 的 margin 中加入辅助变量 δ,并用零空间约束/惩罚控制 δ。 |
论文提出的修复算法。 |
| ID / OOD | ID(in-distribution)指同数据集划分训练/评测;OOD(out-of-distribution)指在 UltraFeedback 训练、在 held-out benchmark 评测。 | 检验对齐方法泛化能力的两种设置。 |
DPO 的几何刻画:从监督损失到加权 KL 投影
论文的出发点是 DPO 常用推导里的隐藏前提。DPO 原论文在表格型策略下得到奖励-策略等价关系:
这条关系要求策略类能表示任意条件分布。真实 LLM 是参数化策略: 远小于 。此时所有可表达的隐式奖励 只构成 中的低维流形 。
论文 Proposition 1 给出关键等式:若偏好由 按 BTL 模型生成,且每个三元组 的偏好对数为 ,则 DPO 的 population loss 最小化等价于
这里 是两个 Bernoulli 分布之间的 KL 散度。该式说明 DPO 在做的事是把真实奖励 投影到 上;投影权重由偏好对频次 决定。若 ,投影能命中真实奖励,DPO 与局部 RLHF 一致;若 ,投影落点取决于数据配比,没有性能保证。
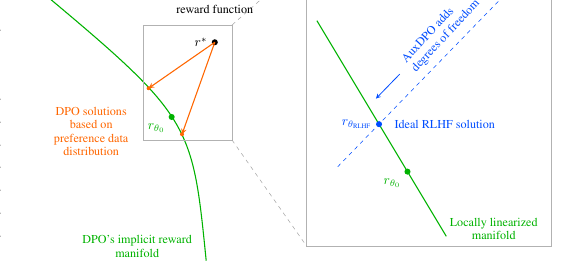
左图的黑点 是真实奖励,绿色曲线是策略类能表达的隐式奖励流形;橙色点表示不同偏好数据分布下可能的 DPO 解。右图是局部线性化后的视角:蓝色点 是两阶段 RLHF 在局部二次近似下对应的隐式奖励;AuxDPO 通过增加受控自由度,把解推向该等价类。
局部线性化:DPO 和 RLHF 各自看见什么
论文用大 regime 做局部分析。 越大,策略相对 的移动越小,泰勒近似误差越可控。隐式奖励在 附近一阶展开为:
其中 的列是各 的 score function,即 。因此 DPO 的局部可达奖励近似为列空间 。
两阶段 RLHF 在同一局部区域里被近似为二次目标:期望奖励用一阶项、KL 惩罚用 Fisher 二阶项。最优性条件给出:
这是一条自然策略梯度更新:把真实奖励投影到参数空间时,用 Fisher 矩阵校正参数方向的尺度。由此,所有满足同一 的奖励函数属于同一个 RLHF 等价类;同一等价类内的奖励差异 落在 ,不会改变局部策略更新。
论文 Proposition 7 进一步说明:DPO 的线性化隐式奖励 恰好是每个 RLHF 等价类中 Mahalanobis 范数最小的代表元。这解释了两者的关系:DPO 不是随机偏离 RLHF,而是在每个等价类里选了一个低维代表;当真实奖励含有零空间分量时,这个代表元会丢掉对偏好拟合有用、但对即时策略移动不可见的成分。
反例:为什么能力受限会让 DPO 学到相反顺序
论文构造了一个可手算的三动作例子。真实奖励等价取为 ,所以真实顺序是 。策略只有一个标量参数:
在 处,策略梯度方向是 ,也就是局部隐式奖励只能沿 方向变化:它只能表达“提高 、降低 ,同时基本不动 ”这类奖励差。
如果训练数据中 与 的比较次数远大于其他比较,即 ,DPO 会优先拟合 这对偏好。由于可用方向只有 ,拟合结果近似为 。这会产生三个后果:
- 学到的奖励顺序变成 ,与真实顺序 相反;
- 最优回答 的概率下降,次优回答 的概率上升;
- 期望奖励 低于初始策略 。
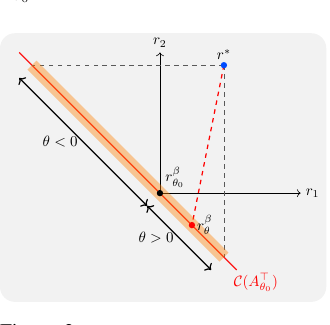
图中红线 是 DPO 局部可达奖励方向;蓝点 不在该方向上。若数据让投影落到 一侧,DPO 会沿着可达方向远离真实最优。论文同时指出,这个反例使用 population loss 和均匀 base policy,因此它排除“数据太少”或“coverage 不足”作为唯一解释;失败来自模型容量与数据配比的相互作用。
AuxDPO:给不可表达分量一个受控出口
AuxDPO 的修法直接对应上述几何诊断。既然 与 RLHF 隐式奖励 的差是零空间元素 ,就把搜索空间从 扩展为:
在局部视角下, 覆盖 , 覆盖零空间;rank-nullity 关系使二者合起来能覆盖整个奖励空间 。因此优化目标不再被迫把 硬压到低维流形上。
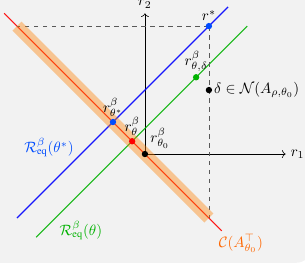
蓝线是产生 RLHF 最优策略的奖励等价类 ;红线仍是 DPO 的低维可达方向;绿线表示固定 时辅助变量 可搜索的方向。加入 后,偏好拟合可以把解推向蓝色等价类,而不是停留在红色流形的最近投影。
论文给出的经验版 AuxDPO margin 可写为:
损失仍是 logistic preference loss,但多了两类约束:小参数场景用 SVD/Householder 求 的正交基 ,直接优化 ;大模型场景按 batch 构造 ,加惩罚 和小幅稳定项 。附录实现细节给出 8B 训练配置:λ_null=1.0、λ_amp=0.01、delta_cap=1.0、aux_lr=5e-3。
需要注意 δ 的参数量是 2n,每个训练样本的 chosen/rejected 各一个标量。论文强调通常 n≪d,所以新增参数量相对模型权重较小;但 δ 仍然是按样本记忆的变量,其泛化依赖零空间约束和优化正则,不能只按“只增加 2n 个参数”理解风险。
实验证据:提升集中在 OOD 和低容量设置
实验使用三类模型:Llama3.1-8B、Llama3.2-1B、Qwen3-0.6B;训练数据为清洗、二值化后的 UltraFeedback;评测为 RewardBench v2 与 MMLU-Pro。表 1 的数值是相对 base policy 的平均准确率变化百分比,不是原始准确率;红色表示低于 base。
| Model | Dataset | Setting | DPO | AuxDPO | IPO | DPOP |
|---|---|---|---|---|---|---|
| Llama3.1-8B | MMLU-Pro | ID | 57.14 | 63.26 | 59.18 | 61.22 |
| Llama3.1-8B | MMLU-Pro | OOD | 8.16 | 14.28 | 10.20 | 6.12 |
| Llama3.1-8B | RewardBench v2 | ID | 56.01 | 66.72 | 61.34 | 62.27 |
| Llama3.1-8B | RewardBench v2 | OOD | 14.31 | 32.44 | 20.17 | 19.87 |
| Llama3.2-1B | MMLU-Pro | ID | 39.58 | 45.83 | 43.75 | 44.21 |
| Llama3.2-1B | MMLU-Pro | OOD | 6.25 | 12.52 | 14.58 | 4.16 |
| Llama3.2-1B | RewardBench v2 | ID | 77.21 | 86.37 | 69.72 | 71.21 |
| Llama3.2-1B | RewardBench v2 | OOD | 14.11 | 43.27 | 20.42 | 18.76 |
| Qwen3-0.6B | MMLU-Pro | ID | 53.12 | 61.78 | 47.48 | 56.67 |
| Qwen3-0.6B | MMLU-Pro | OOD | 11.34 | 22.22 | 15.56 | 17.78 |
| Qwen3-0.6B | RewardBench v2 | ID | 55.10 | 65.31 | 53.06 | 51.02 |
| Qwen3-0.6B | RewardBench v2 | OOD | -8.16 | 18.36 | -8.23 | -6.25 |
表中最有信息量的不是“AuxDPO 全部第一”——Llama3.2-1B 的 MMLU-Pro OOD 上 IPO 更高——而是两个稳定趋势:第一,AuxDPO 的 OOD 增益普遍大于 ID 增益;第二,在 Qwen3-0.6B 的 RewardBench v2 OOD 上,DPO/IPO/DPOP 都低于 base,只有 AuxDPO 为正。这与理论预测一致:跨域或低容量时,真实奖励更可能落在隐式奖励流形之外,DPO 的投影错配更容易显形。
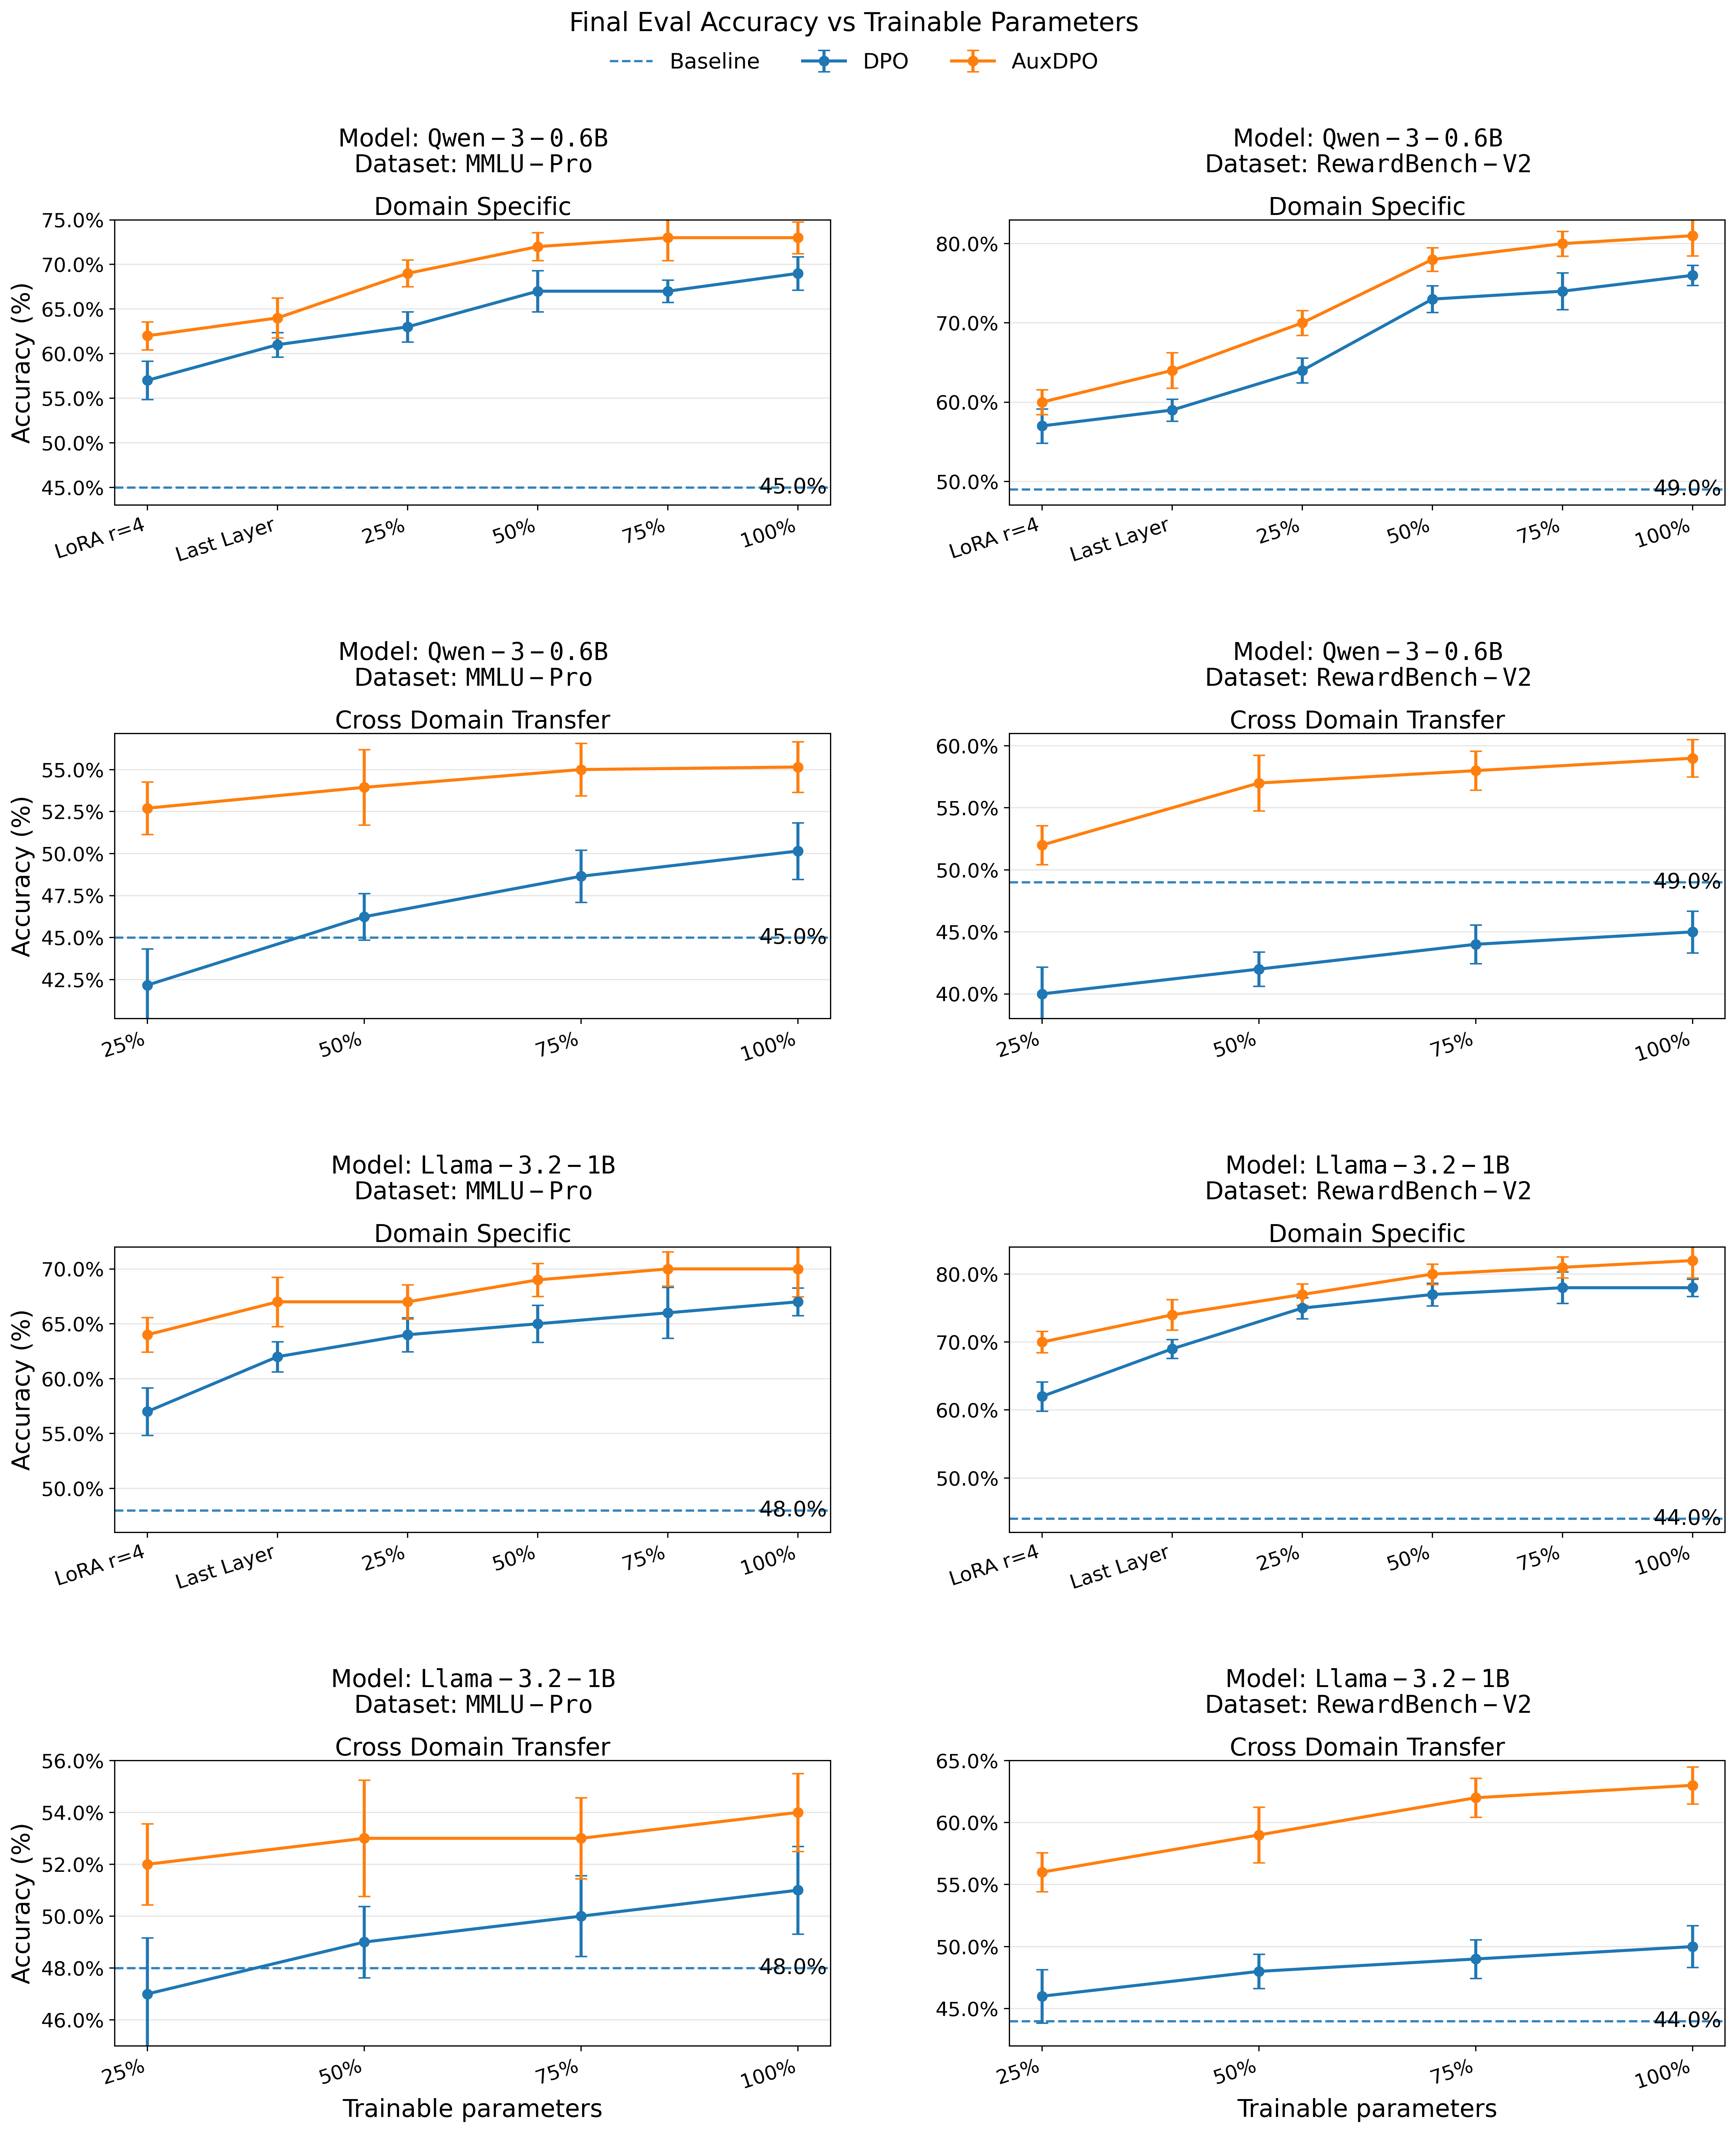
上图来自论文附录,比较 Qwen3-0.6B 与 Llama3.2-1B 在 25%/50%/75%/100% 可训练参数、LoRA r=4、Last Layer 等配置下的 DPO/AuxDPO 表现。低容量端 AuxDPO 与 DPO 的分离更明显,符合“参数化策略类表达不足导致错配”的机制解释。
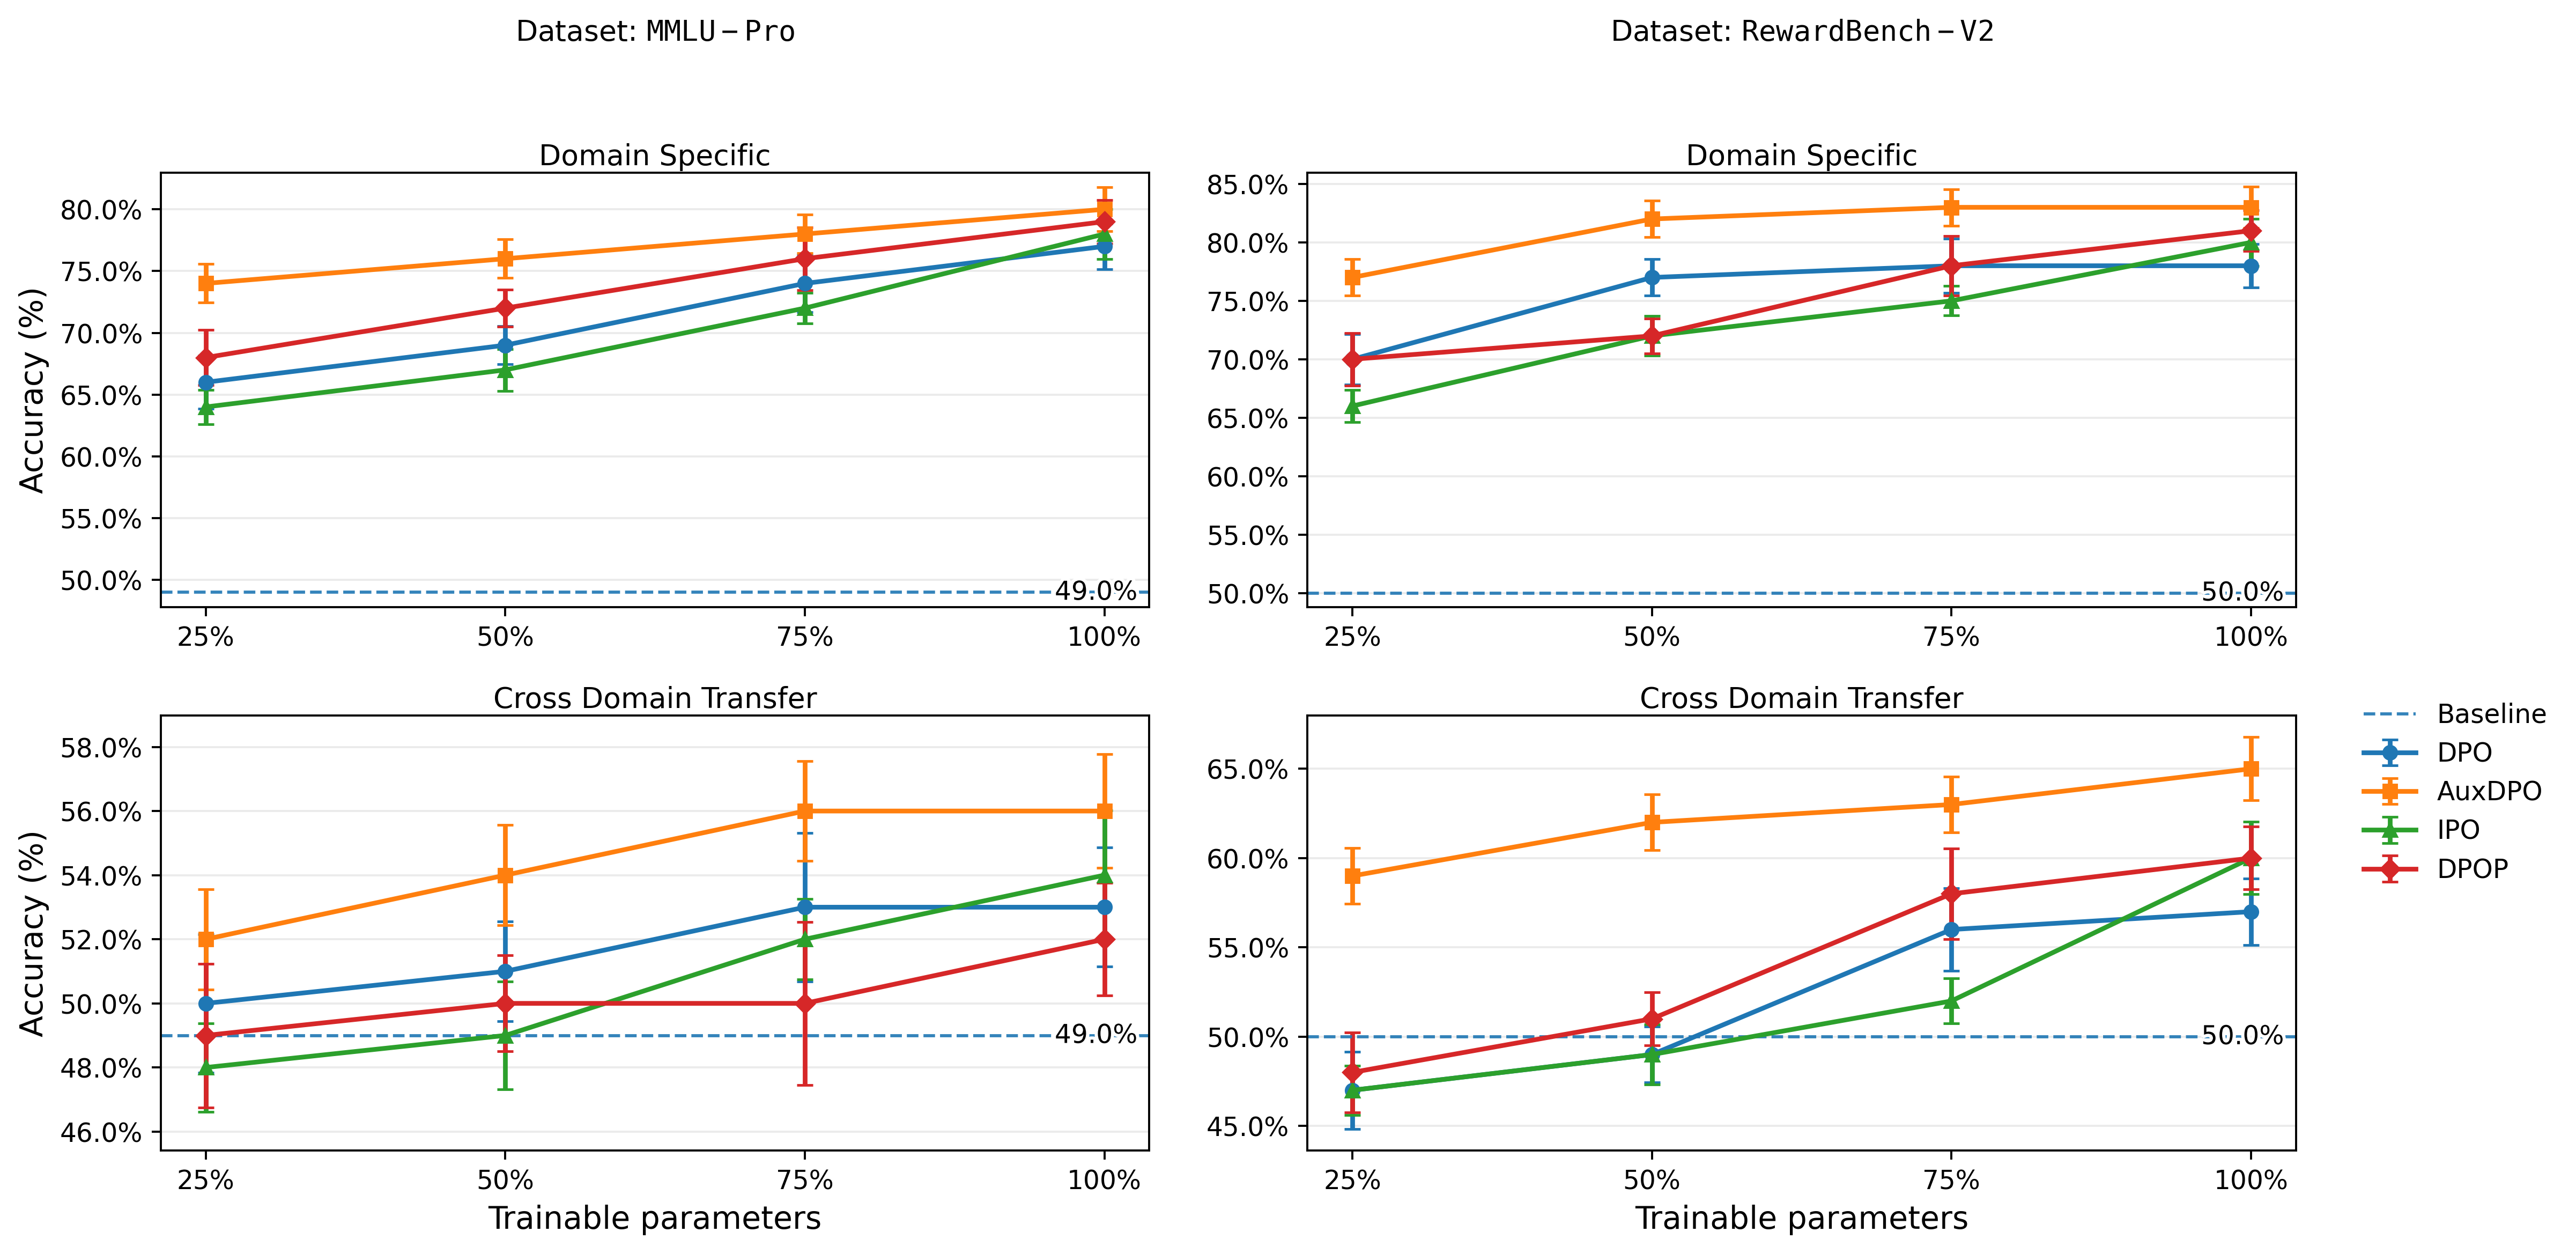
8B 结果说明 AuxDPO 不是只在小模型上有效;在多数 ID/OOD 面板中,它相对 DPO/IPO/DPOP 保持更高曲线。由于每个面板只改变算法与可训练参数配置,数据、token budget、划分保持一致,这些图比单独的最终分数更能支撑“修复错配”这一因果解释。
对公众号转述的校正
公众号标题“DPO 从一开始就是错的”传播效果强,但论文证据支持的表述更精确:DPO 的原始等价证明从表格型策略出发;当策略类是真实 LLM 的低维参数化模型时,DPO 成为一个可能错配的统计估计问题。论文没有证明 DPO 在所有任务上都会变差,也没有否定 DPO 在工程中的可用性;它给出的是失败条件、可构造反例和一种有理论动机的修复路径。
公众号中“DPO 压出来的结果就是一团糟”“全面碾压”等说法需要降调。论文自己的表格显示,AuxDPO 在大多数设置领先,但不是所有单元格第一;合成实验中 IPO/DPOP 在不平衡数据下也失败,在平衡数据下 DPO 可以恢复。正确的读法是:DPO 的风险被低估了,尤其在参数高效微调和分布外偏好泛化场景中。
限制与未解决问题
- 局部性假设:理论结果依赖大
β,也就是策略不远离πθ0的局部区域。实际训练常用较小β或较长训练,局部近似的误差需要额外评估。 - 精确优化假设:反例和修复都基于 population loss 的全局或近似全局最小化。有限步 SGD(stochastic gradient descent,随机梯度下降)、早停、学习率 schedule 可能改变落点。
- BTL 偏好假设:真实人类偏好常有噪声、位置偏置、长度偏置、标注者混合效应;BTL 是可控分析框架,不是完整人类偏好模型。
- 奖励可识别性:论文比较的是“生成偏好的真实奖励”。在 LLM 对齐里,
r*通常不可观测;实验只能用 held-out preference accuracy(留出偏好准确率)和 benchmark accuracy(基准准确率)间接验证。 - AuxDPO 的记忆风险:
δ是逐样本变量,若λ_null、λ_amp、delta_cap设置不当,可能拟合训练对噪声。论文用零空间约束降低风险,但更系统的正则消融仍有限。 - 评测范围:实验覆盖 UltraFeedback 训练、RewardBench v2、MMLU-Pro 与三种开源模型。对更强 base model、多轮对话、智能体式工具调用、长输出任务,仍需独立复现。
工程检查清单
- 估计表达盲区:使用 LoRA、adapter、只训末层或冻结大部分层时,默认 DPO 的隐式奖励流形更窄;提高对偏好反转和 OOD 衰退的监控优先级。
- 审计偏好对配比:按 prompt 来源、任务类型、回答长度、难度和 chosen/rejected 来源统计
n_{s,a,a'}的等效配比;高度倾斜的 pair 分布会改变 DPO 投影方向。 - 监控绝对概率:不只看 chosen-relative-to-rejected,还看 chosen logprob、rejected logprob、期望奖励代理、长度分布和 base KL。
- 增加 OOD 验收:ID 提升不能推出跨域稳定;至少保留一个不与训练分布同源的 held-out preference benchmark。
- 低容量场景优先试 AuxDPO 思路:若不能引入论文实现,可先做数据层面的近似修复——重采样平衡 pair 覆盖、提高可训练参数比例、或对高风险子集使用两阶段 RLHF/奖励模型验证。
- 复现论文时对齐口径:表 1 是相对 base 的百分比变化;表 2 是原始准确率/胜率。比较不同论文或内部实验时,先把指标口径统一。
最小可复现实验
用论文的三动作例即可在几分钟内复现核心现象:设 r*=[1,2,0]、πθ∝[e^θ,e^-θ,1]、均匀 θ0=0,生成 BTL 偏好。第一组令 n12=n23=5,n31=50;第二组令三者均为 10。直接最小化 population logistic loss,观察第一组中 θ>0、a1 概率超过 a2、πθ^T r*<1,第二组中该失败消失。随后加入满足 Aθ0 δ=0 的辅助变量,检查第一组能否回到 a2≻a1≻a3。这个实验不需要 LLM,也能把“容量受限 + pair 配比 + 零空间补偿”的机制链条单独跑出来。
参考材料
- 论文 PDF:
references/2510.20413.pdf,arXiv:2510.20413v1,2025-10-23。 - 论文 TeX 源码与实验图:
references/source/。 - ICLR 2026 proceedings 页面 PDF:
references/iclr2026-paper-conference.pdf。 - 解读新增高清图:
analysis-assets/。