来源:内部资源 飞书原文:内部资源
On-Policy Distillation:OPD 和 SFT/RL 比较
符号速查表
阅读本文前可先参考以下符号的读法与含义:
| 符号 | 读法 | 含义 |
|---|---|---|
| "x" / eks | prompt(输入提示) | |
| "y" / wai | 模型生成的 response(完整序列) | |
| "y t" | 第 个生成的 token | |
| "y less than t" | 第 个 token 之前已生成的所有 token | |
| "L" / el | response 的 token 总数(序列长度) | |
| "s t" | 第 步的状态(prefix),即 | |
| "pi theta" / 派西塔 | student 模型的策略(概率分布), 是可训练参数 | |
| "pi T" / 派T | teacher 模型的策略(概率分布),=Teacher,参数固定 | |
| "pi theta of y given x" | 给定 prompt ,student 生成完整序列 的概率 | |
| "pi theta of y t given s t" | 给定 prefix ,student 生成第 个 token 的条件概率 | |
| "p t" | student 在第 个 prefix 上的 next-token 分布, | |
| "q t" | teacher 在第 个 prefix 上的 next-token 分布, | |
| "P" "Q" / 皮 丘 | 一般概率分布(KL 中 P 为目标分布,Q 为近似分布) | |
| "D K L of P given Q" | P 对 Q 的 KL 散度,衡量两个概率分布的差异 | |
| "E" / 期望 | 期望(expectation), 表示 服从 下求期望 | |
| "花体D" / mathcal D | prompt 的数据分布 | |
| "花体V" / mathcal V | 词表(vocabulary) | |
| "R of x y" | 奖励函数(Reward),给定 prompt x 和 response y 的得分 | |
| "product" / 连乘 | 连乘符号, 表示从第 1 到第 项相乘 | |
| "sum" / 求和 | 求和符号 | |
| "given" / 给定 | 条件符号, 表示"给定 B 时 A" | |
| "given" / 双竖线 | KL 散度中的方向分隔符, 表示"P 对 Q" |
On-Policy Distillation(OPD)解决的问题是:如何让 student 在自己真实会访问的生成状态上,获得比最终 Reward 更稠密、比固定轨迹更贴近serving分布时候的监督信号
本文尝试重点回答五个问题:
- OPD 的 on-policy 到底指什么
- OPD 的 sequence KL 如何分解成 prefix 上的 token-level KL
- sampled-token OPD 与 full-vocabulary OPD 分别在估计什么
- OPD 相比 SFT 和 outcome-reward RL 改变了什么
- OPD 适用于哪些场景,又会在什么条件下失效
本文中的 OPD 是一类训练范式,不是唯一固定的 loss。共同部分是:trajectory 由当前 student 生成,teacher 在 student-generated prefix 上提供分布监督。具体监督 metric 可以是 forward KL 散度、reverse KL 散度或其他能衡量概率分布距离的工具
预备知识:KL 散度与 Forward / Reverse KL
KL 散度(Kullback-Leibler Divergence)衡量两个概率分布之间的差异。设 为目标分布, 为近似分布,则:
它满足非负性(,当且仅当 时取零),但不满足对称性:。这一非对称性正是 forward KL 与 reverse KL 的来源,也是理解 OPD 行为的关键。
Forward KL:
以目标分布 加权。当 但 时,,惩罚极大。因此 有质量的地方, 绝对不能为零—— 必须铺开覆盖 的每一个区域,行为上称为 Mode-Covering(模态覆盖)。若 是多峰分布, 倾向于把所有峰都罩住,结果可能比较平、比较散。
在 LLM 语境下,forward KL 由 teacher 概率加权:只要 teacher 认为某个 token 重要,就能直接推动 student 提高该 token 的概率,即使 student 原本几乎不会采到它。SFT、off-policy KD 与 full-vocabulary forward KL 都具有这种 mode-covering 作用,适合冷启动和扩展 student 的 action support。
Reverse KL:
以近似分布 加权。当 但 时,,惩罚极大。因此 有质量的地方, 必须也有质量—— 不敢把概率质量放在 没有的地方,行为上称为 Mode-Seeking(模态寻找)。 倾向于集中在 的某一个高概率峰上,可能完全忽略其他峰。
现代 reasoning OPD 通常使用 reverse KL(式 8),即 ,以 student 分布 为 、teacher 分布 为 。其 mode-seeking 特性意味着:若某个关键 token 在 student 下的概率近似为零,student 几乎不会生成对应状态,reverse KL 也难以把它从零召回。这正是 OPD 不能完全替代 SFT 的根本原因(详见后文"OPD 不能完全替代 SFT")。
公式细节:为什么乘 Q(x)、为什么用 log
以 reverse KL 为例,拆解两个最常见的疑问。
为什么要乘 Q(x)
是每个 x 处的点态差异,它随 x 变化,本身是一个随机变量。要把它压缩成一个标量衡量"整体差多少",就需要求期望——而期望的权重正是 Q(x):
就是离散分布下求期望的写法。权重 Q(x) 代表"这个 x 在 Q 看来有多重要":Q 概率大的地方,差异权重就大;Q 概率为零的地方直接被忽略。
如果不乘 Q(x),直接把点态差异相加会怎样? 设 Q={A:0.9, B:0.1},P={A:0.5, B:0.5}:
| A | B | |
|---|---|---|
| +0.59 | -1.61 |
直接相加:0.59 + (-1.61) = -1.02,负数,没有意义。乘 Q(x) 加权后:0.9×0.59 + 0.1×(-1.61) = 0.37 > 0。A 是 Q 的主场(权重 0.9),正贡献压过了 B 的负贡献。
为什么要用 log
1. 把"概率比"翻译成"比特差"。 信息论中符号 x 的最优码长为 (概率越小码长越长)。用 P 的编码传输 x 比用 Q 的编码多花的比特数为:
具体例子:Q={A:1/2, B:1/4, C:1/8, D:1/8},P 为均匀分布(每个 1/4,码长均为 2 bits):
| 符号 | Q(x) | P 的码长 | Q 的码长 | 多花的比特 = |
|---|---|---|---|---|
| A | 1/2 | 2 | 1 | +1 |
| B | 1/4 | 2 | 2 | 0 |
| C | 1/8 | 2 | 3 | -1 |
| D | 1/8 | 2 | 3 | -1 |
按 Q 的出现频率加权平均: bits,即 。物理意义:数据服从 Q 却用了 P 的编码,平均每个符号浪费 0.25 比特。
2. 把自回归的连乘变成连加。 这对 LLM 至关重要。式 (10) 的分解:
sequence 概率是连乘,log 之后变成连加,sequence-level KL 才能精确分解到每个 prefix 上的 token-level KL。没有 log,OPD 的整个数学结构就不成立。
为什么整体一定非负:Jensen 不等式
虽然每一项 可以为负,但加权求和后整体非负,由 Jensen 不等式严格保证。
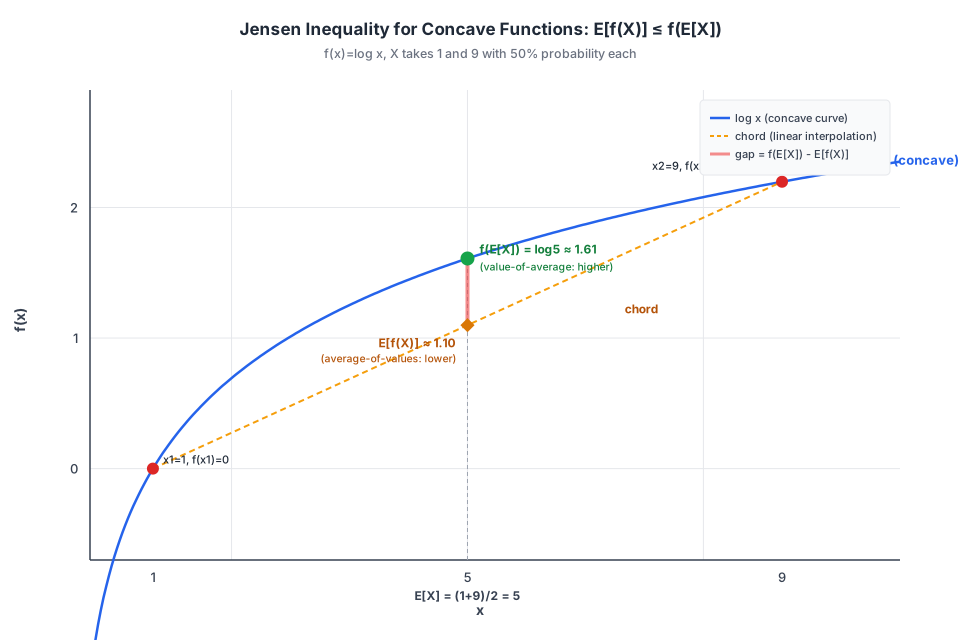
log 是凹函数(图像向上拱),凹函数满足:函数的平均值 ≤ 平均值的函数值,即 。
这两句话说的是两种不同的计算顺序:
| 说法 | 计算顺序 | 数学表达 |
|---|---|---|
| 函数的平均值 | 先把每个 X 代入函数 f,再对结果求平均 | |
| 平均值的函数值 | 先把 X 求平均,再代入函数 f |
以 , 以 50% 概率取 1、50% 概率取 9 为例:
- 平均值的函数值(先平均再 log):
- 函数的平均值(先 log 再平均):
- ✓
几何上,凹函数的曲线始终在弦的上方:在均值 处,曲线上的点(先平均再函数)比弦上的点(先函数再平均)更高,两者的高度差就是 。
把 改写。原式为 ,利用 改写为:
改写的目的是让里面变成 ,从而可以令 后对 直接用 Jensen。以下用具体例子 , 逐步演示。
第一步:令 ,X 是随机变量。 服从 分布,所以 的取值随 变化:
| x | Q(x) | X = P(x)/Q(x) |
|---|---|---|
| A | 0.9 | 0.5/0.9 ≈ 0.556 |
| B | 0.1 | 0.5/0.1 = 5 |
即 以 90% 概率取 0.556,以 10% 概率取 5。
第二步:为什么 ?
分子的 与分母的 约掉,剩下 。这一步不依赖 P、Q 的具体取值,只要两者都是合法概率分布就恒成立。数值验证:。
的含义。 是 P 和 Q 在每个 处的概率比值,按 Q 的概率加权平均后恰好为 1。直觉上:Q 概率大的地方 偏小(分母大),Q 概率小的地方 偏大(分母小),加权平均后正好抵消——因为两者都是归一化的概率分布,总量都是 1。这不是巧合,是数学恒等式。
为什么要约掉 ? 同时出现在期望的权重和 的分母中,约掉后才能利用 P 是概率分布(总和为 1)这一性质。不约掉则无法直接看出期望等于多少。
Forward KL 和 Reverse KL 都成立吗?完整推导链如下。 注意第②步的负号是关键,,不是 :
| 步骤 | Reverse KL | Forward KL |
|---|---|---|
| ① 原式 | ||
| ② 改写(翻分子分母,加负号) | ||
| ③ 令随机变量 | ||
| ④ 算期望(约掉) | ||
| ⑤ Jensen(log 是凹函数) | ||
| ⑥ 加负号得非负 |
关键规则:期望的权重分布 = 随机变量分母中的分布,才能约掉。 Reverse KL 权重是 Q、令 (分母 Q),匹配;Forward KL 权重是 P、令 (分母 P),匹配。若搞反(如 Reverse KL 中令 ),则 不能约,也不等于 1。第④步的 只是中间量,最终通过第⑤步 Jensen 和第⑥步的负号才得到 。
第三步:对 用 Jensen。 log 是凹函数,满足 ,代入 :
数值验证:。
第四步:加负号得到非负性。 因为 ,两边乘 (不等号翻转):
数值:。
"负数项是局部节省"的含义。 回到原式 :
| x | Q(x) | log(Q/P) | Q(x)×log(Q/P) | 含义 |
|---|---|---|---|---|
| A | 0.9 | +0.588 | +0.529 | Q 在 A 上更集中,用 P 编码多花比特 |
| B | 0.1 | -1.609 | -0.161 | Q 在 B 上更稀疏,用 P 编码反而省比特 |
B 项的负数就是"局部节省"——Q 概率小的地方,P 的编码反而更短。但 B 的权重仅 0.1,而 A 权重 0.9 且 Q(A)>P(A),正贡献压过负贡献,合计 。Jensen 不等式从数学上保证:只要 P、Q 都是合法概率分布,正贡献必然压过负贡献,整体非负。
对比总结
| Forward KL | Reverse KL | |
|---|---|---|
| 加权方 | 目标分布 | 近似分布 |
| 行为 | Mode-Covering 模态覆盖 | Mode-Seeking 模态寻找 |
| 的倾向 | 覆盖 的所有区域 | 集中在 的某个峰 |
| 风险 | 过度发散、平均化 | 模态丢失、多样性压缩 |
| LLM 中的典型用途 | SFT、off-policy KD、冷启动 | OPD、on-policy 策略迁移 |
预备知识:自回归分解
(符号含义见文首速查表)
大语言模型是自回归的——一个 token 一个 token 依次生成,整句话的概率等于每个位置条件概率的连乘:
读作 "product from t equals 1 to L",表示从第 1 到第 个 token 的连乘。
以生成 "我 爱 编 程" 为例:
teacher 同理。两个模型的序列概率比等于各 token 概率比的连乘:
再利用 ,连乘就变成了连加:
这个分解是 OPD 的数学根基:sequence-level KL 因此可以精确拆到每个 prefix 上的 token-level KL,不需要对指数级的序列空间求和,只需在 student 实际生成的轨迹上逐 token 计算概率比。
问题定义
设 prompt 来自数据分布 。student policy 为 ,固定 teacher policy 为 。student 自回归生成 response:
第 个 prefix state 为:
在同一个 student-generated state 上,student 与 teacher 分别给出完整 next-token distribution:
“On-policy”只说明式(2)的 prefix 来自当前 student。teacher 不负责生成训练 trajectory,而是在 student 已经到达的状态上提供监督
SFT
**在固定轨迹分布上做最大似然。**给定固定 demonstration ,SFT 最小化 negative log-likelihood:
式(4)它的监督很稠密,可以看作是对 one-hot empirical target 的 cross-entropy。但所有 prefix 都来自数据或 teacher:
训练时 student 总是在正确 prefix 上预测下一个 token;推理时 prefix 却由 student 自己生成。若早期 token 出错,后续状态可能从未在训练中出现,误差会沿自回归过程累积。这是 SFT 的 exposure bias
SFT 的优势是:teacher 可以直接展示 student 当前几乎不可能采到的 token、知识与完整策略,因此比较适合冷启动和扩展 student 的初始策略
Outcome-Reward RL
**在 Student 轨迹上优化稀疏结果,**传统 RL 或 RLVR 直接最大化 student rollout 的任务 Reward:
Policy-gradient theorem 给出:
RL 的 prefix 与推理分布一致,因此没有式(5)的 teacher-forcing mismatch;外部 Reward 还允许 student 发现 teacher 没有展示过的策略。
困难在于:数学、代码等 RLVR 常只有 sequence-level 0/1 Reward。同一个 被分给上千个 token,无法直接指出错误从哪个 prefix 开始。全对或全错 group 还可能没有相对 Advantage,导致rollout 不产生梯度
OPD 的 Sequence-level Objective
现代 reasoning OPD 常把 student sequence distribution 与 teacher sequence distribution 的 reverse KL 作为目标:
展开 KL 定义:
利用自回归分解:
式 (10) 即前文预备知识中自回归分解的结果:序列概率比的 log 等于各 token 概率比的 log 之和。
再对每个 prefix 上的 action 取条件期望:
因此 sequence reverse KL 可精确分解为 student trajectory 上的 conditional KL 之和:
式(12)是 OPD 最核心的数学结构:trajectory distribution 来自 student,而每个访问状态上的局部目标由 teacher distribution 定义
式 (12) 的期望是 ,即轨迹 y 是从 student 自己的策略 采样出来的。这意味着"在哪些状态 /prefix 上计算损失" 这件事本身就受 影响—— 你改了参数,采样到的轨迹分布也会变
数学上,完整的梯度需要同时考虑:
- 损失函数本身对 的导数(直接项)
- 采样分布 随 变化带来的导数(分布依赖项)
实际的时候会使用semi-gradient 近似
- 先用当前策略 rollout 出一批 prefix,把这些 prefix 当作固定样本
- 只在这些固定 prefix 上对 conditional KL 做反向传播
- 不把梯度回传到离散采样过程
这就是 semi-gradient—— 只对目标函数的 "直接部分" 求导,忽略状态分布随参数变化的间接影响。这和强化学习里 Q-learning 的 semi-gradient 是同一个思路:把采样到的状态当作固定的,只对价值函数的参数求导
Teacher 作为稠密隐式 Reward
定义逐 token teacher signal:
在 student action distribution 下取期望:
所以最大化式(13)的期望等价于最小化局部 reverse KL。与普通 Reward 不同, 依赖当前 student policy;它不是环境给出的固定结果,而是 teacher 定义的局部行为目标
Full-vocabulary、Sampled-token 与 Top-K OPD
Full-vocabulary OPD
在每个 prefix 上直接计算:
它直接比较完整 next-token distribution,监督最稠密;但保存 student/teacher vocabulary logits 的内存和通信成本约为 ,代表batch_size,代表序列长度,为词表大小
Sampled-token OPD
若只查询 student 实际采到的 token,定义:
根据式(11):
所以式(16)是局部 conditional KL 数值的无偏单样本估计,同时方差较大。工程中常把负的 logprob gap 视为 stop-gradient Advantage:
需要区分“KL 数值的无偏估计”和“完整 sequence objective 的精确梯度”。式(19)还常只使用当前的 token signal,而不把未来 teacher signal 归因给更早 action。因此它是更低成本的 sampled semi-gradient,不能解释成对式(8)全部 state-distribution derivative 的精确求导。
Top-K OPD
Top-K OPD 只保留 student 或师生联合高概率候选集合 ,在归一化后的子分布上计算 KL:
它在 sampled-token 与 full-vocabulary 之间折中,但会丢失集合外的概率密度信息。teacher 与 student 的 top-K overlap 也通常是判断 OPD 是否可学的重要指标。
OPD 与 SFT 和 Outcome-Reward RL对比
为什么 OPD 相比 SFT 更有效
训练状态分布从 Teacher 变为 Student
SFT 的局部损失在固定状态分布上取期望:
OPD 则在当前 student occupancy 上取期望:
式(23)把监督预算集中在 student 真正会到达的 prefix,包括 teacher demonstration 中没有出现过的错误 prefix。随着 student 更新, 也同步刷新。
OPD 不能完全替代 SFT
Reverse-KL OPD 只能在 student 已经能够访问的高概率区域中有效塑形。若关键策略在 student 下的概率近似为零,student 几乎不会生成对应状态,teacher signal 也难以把它从零召回。常见两阶段结构是:
第一阶段把新知识与新轨迹放入 student support;第二阶段在 student 自己的状态分布上修正 exposure bias。
先看一下 state coverage 与 action support。 对一般discount MDP,student 的未归一化状态访问分布为:
描述 student 能访问哪些状态。对每个已访问状态,action support 另行定义为:
扩大 表示 rollout 到达了更多 prefix;扩大 则表示在某个给定 prefix 上,更多 action 获得了可被采样的概率。两者位于不同层次:student 可以仅依靠原本已有的高概率 token 组合访问更多 prefix,却不让任何固定 prefix 上的候选 token 集合变大。新的 state–action pair 也可能只是来自新增状态,而不是原状态下新增 action。
在 LLM 中,state 就是 prefix 。On-policy rollout 会把 teacher 带到 student 实际产生的正确或错误 prefix,因此改善的是 state-side exposure bias;但 sampled-token OPD 的 action 仍满足 。如果 teacher 偏好的 token 在该 prefix 下几乎不会被 student 采到,teacher 就很少有机会通过这个 token 提供直接监督。
Reverse KL 为什么难以从零“召回”动作。 固定一个已访问状态,记 、。Reverse KL 为:
当 teacher 固定,且 覆盖 student support 时,正确的参数梯度是:
上式没有单独的 ,因为 teacher 参数不随 更新。若 student logits 为 且 ,对候选 token 还可以写成:
显式包含因子 :在严格截断或 mask 后若 ,该动作没有直接梯度;若 极小,梯度与在有限 rollout 中被采到的概率也都极小。普通 softmax 在精确实数下通常对整个词表给出正概率,概率小到在有限 group、top-p/top-k 截断或有限精度下近似不可见。
Full-vocabulary reverse-KL OPD 能消除 sampled-token Monte Carlo 的漏采和方差,并通过 softmax coupling 同时改变多个 logits;但仍由 student 概率 加权,因此几何上仍是 mode-seeking,不能等同于 action support expansion。
相比之下,forward KL 为:
由 teacher 概率 加权:只要 teacher 认为某动作重要,它就能直接推动 student 提高该动作概率,即使 student 很少自行采到它。Teacher-generated SFT、off-policy KD 与 full-vocabulary forward KL 都具有这种 mode-covering 作用
因此更准确的分工是:SFT 或 off-policy KD 先把 teacher 的关键 action 和 trajectory 放入 student 的有效 support;OPD 再沿 student 自己访问的状态持续纠偏。前者主要解决“student 根本不会走这一步”,后者主要解决“student 真走到这里以后如何避免继续犯错”
为什么 OPD 相比 Outcome-Reward RL 更高效
监督密度不同
终局 RL 对一条 trajectory 通常只有一个结果信号:
OPD 对每个访问状态都可以给出局部 teacher signal:
这使错误 response 也能产生大量训练信息,并显著降低“整条答案错了,但不知道从哪里开始错”的 credit-assignment 难度。
OPD 与 RL 优化的目标不同
RL 的方向由外部reward 定义;只要 verifier 可信,student 可以发现 teacher 从未展示过的策略。OPD 的方向由 teacher distribution 定义,主要任务是迁移和恢复 teacher 已具备的行为。
因此 OPD 训练更高效并不意味着它在能力发现上支配 RL。更准确的分工是:
Qwen3 在同一 off-policy distilled 8B 初始化上报告:RL 使用约 17,920 GPU hours,OPD 使用约 1,800 GPU hours;其 OPD 在对应数学与代码评测上也更高。这是在特定 teacher、数据和任务下的结果,不是所有任务都能有固定十倍提升的定律。
OPD 的应用
| 应用方向 | Teacher 与监督信号 | 价值与适用条件 |
|---|---|---|
| Strong-to-Weak Distillation | 大 teacher 在小 student 的自生成 prefix 上提供 logits | 把 reasoning、instruction following 或模式切换能力迁移到低成本模型;Qwen3 对多种 Dense 和 MoE lightweight models 使用“off-policy distillation 冷启动 + OPD”的两阶段结构 |
| 数学、代码与长链推理 | teacher 在错误推理轨迹的早期分叉点提供局部信号 | 减少终局 0/1 Reward 的 credit-assignment 稀疏性;适合有强 reasoning teacher、但 verifier 稀疏或 RL rollout 昂贵的场景 |
| 通用序列任务与 Instruction Tuning | GKD 式的 student-state distillation | 已在摘要、机器翻译、算术推理和 FLAN instruction tuning 中验证,说明 OPD 的核心价值并不限于 RLVR |
| 个性化与持续学习 | 用更新前 checkpoint 作为 teacher,在当前模型轨迹上恢复行为 Learn new knowledge -> opd restore behavior -> conitinue learning |
模型学习企业知识或领域语料后,可能遗忘 instruction following、语气、格式、工具调用与预算行为,OPD 用于把这些行为恢复回来 |
| 摊销昂贵 RL 策略 | 高成本 RL 搜索出的最终 policy 作为 teacher | 把强策略迁移给原始模型、小模型或多个部署版本;部署模型不需要重复经历完整 RL curriculum |
| On-Policy Self-Distillation | teacher 与 student 共享参数,通过正确答案、reference solution、hint 等 privileged context 打破对称(式 29) | 不部署独立大 teacher 也能获得稠密监督 其中 可以是正确答案、reference solution、hint 或其他 privileged context。teacher 在 student rollout 上解释和利用这些信息,从而在不部署独立大 teacher 的情况下提供稠密监督。 |
| OPD 与 RL 联合 | teacher KL 作为主要监督的一部分,与 verifier reward 联合优化 | 适用于 teacher 是有用但不完美的行为先验、verifier 才是最终目标的场景:RL 提供超越或纠正 teacher 的通道,OPD 提供 dense shaping 与行为保持;不应与只用于防漂移的弱 reference regularization 混为一谈 |
应用场景详解:Teacher 不一定是更大的模型
OPD 的核心是"在 student 自己的状态分布上,用一个 teacher 分布提供稠密监督"。teacher 不一定是更大的模型,只要能提供比最终 Reward 更稠密的信号即可。以下是除强到弱蒸馏之外的典型用法:
1. 持续学习:防止灾难性遗忘。 用更新前的 checkpoint 作为 teacher,在当前模型学习新知识后,用 OPD 把旧行为恢复回来。典型场景是模型学了企业知识库或领域语料后,遗忘了 instruction following、语气、格式、工具调用与预算行为。流程为 Learn new knowledge → OPD restore behavior → continue learning。这里 teacher 不是"更强"的模型,而是"更守规矩"的旧版本,OPD 在当前模型的轨迹上逐 token 拉回旧行为,比简单混合旧数据重训更精准。
2. On-Policy Self-Distillation:不需要独立大 teacher。 teacher 和 student 共享同一套参数,通过 privileged context 打破对称:,,其中 可以是正确答案、reference solution、hint 等。teacher 在 student rollout 过程中"看到"正确答案从而提供更优的 next-token 分布,student 看不到答案只能靠自己推理。这样不部署独立大 teacher 也能获得稠密监督。
3. 摊销昂贵 RL 策略。 RL 训练(尤其是长链推理的 RLVR)成本极高,把 RL 搜索出的最终强策略作为 teacher,用 OPD 快速迁移给更小的部署模型、同一模型的多个版本或量化版本。部署模型不需要重复经历完整 RL curriculum。Qwen3 报告 RL 使用约 17,920 GPU hours,OPD 仅使用约 1,800 GPU hours。
4. OPD 与 RL 联合训练。 OPD 不替代 RL,而是互补:RL 提供外部 verifier Reward,负责搜索和发现 teacher 不会的新解法;OPD 提供稠密 shaping 和行为保持,防止 RL 把模型训崩(输出重复、格式崩坏)。适用于 teacher 有用但不完美、verifier 才是最终目标的场景。注意这和"弱 reference regularization"不同——这里 teacher KL 是主要监督的一部分,不是仅仅防漂移。
5. 通用序列任务,不限于推理。 OPD 的价值不限于数学/代码 RLVR,已在摘要、机器翻译、算术推理和 FLAN instruction tuning 中验证。任何有强 teacher、但终局 Reward 稀疏或 rollout 昂贵的场景都适用。
核心洞察:teacher 不一定是"更大的模型",它可以是旧版本、带答案的自己、RL 训出的策略——只要能在 student 的状态上提供稠密信号,OPD 就适用。
| 用法 | teacher 是谁 | 解决什么问题 |
|---|---|---|
| 强到弱蒸馏 | 更大的模型 | 能力迁移、降本部署 |
| 持续学习 | 更新前的 checkpoint | 防止灾难性遗忘 |
| Self-Distillation | 同一模型 + privileged context | 不需要独立大 teacher |
| 摊销 RL | RL 训出的强策略 | 避免重复昂贵 RL |
| OPD+RL 联合 | 有用但不完美的 teacher | 稠密 shaping + 外部探索 |
| 通用任务 | 任意强 teacher | 替代稀疏终局 Reward |
局限
| 失效条件 | 机制 | 备注 |
|---|---|---|
| 强 Teacher 不等于有效 Teacher | OPD 是否有效主要取决于三个条件:
| 更大的 teacher 可能因为局部分布与 student 不重叠而提供近似平坦、难以利用的梯度;思维模式更接近的较小 teacher 反而可能更有效 |
| 长轨迹中的 Teacher 反馈会退化 | student prefix 越深,越可能偏离 teacher 自然生成的状态。teacher 从深层 student prefix 继续生成时的正确率优势会下降,过长 response 还可能出现 suffix entropy 与 gradient spike,再向前传播 | OPD 修复的是 student 的 train–test state mismatch,不保证 teacher 对任意 off-manifold student state (轨迹越长,student 自己生成的 prefix 越可能偏离 teacher 的自然分布)都可靠 |
| Reverse KL 的单峰化 | teacher 高熵或存在多条合理路径时,reverse KL 的 mode-seeking 会压缩 student 多样性 | 需要同时监控 pass@1、pass@K、top-1/top-K probability mass 和 token entropy,而不能只看 teacher KL 是否下降 |
| 计算与系统成本 | 每轮 OPD 至少包含 student rollout、teacher forward 和 student backward。Full-vocabulary KL 还需要处理词表级 logits | 大 teacher、MoE、长 context 和跨 tokenizer 会增加显存、通信与调度成本 |
| 纯 OPD 不保证超越 Teacher | 纯 distribution matching 的固定点是 student 在访问状态上逼近 teacher,它没有可靠环境 Reward 所提供的外部改进标准 | 若目标是发现 teacher 不会的新解法,仍需搜索、RL、verifier 或更强 privileged information |
结论
OPD 最准确的定位不是“在线版 SFT”,也不是“更便宜的 RL”,而是在 student 自身状态分布上进行的稠密策略迁移。
三类方法的分工可以概括为:
SFT 让 student 看见原本不会生成的知识和轨迹;OPD 在 student 真正会遇到的 prefix 上逐 token 迁移 teacher;RL 依据外部 Reward 搜索 teacher 之外的改进。实际后训练系统通常需要三者组合,而不是寻找一个统一替代品。
参考文献
- On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes
- Qwen3 Technical Report
- On-Policy Distillation
- Self-Distilled Reasoner: On-Policy Self-Distillation for Large Language Models
- Rethinking On-Policy Distillation of Large Language Models: Phenomenology, Mechanism, and Recipe
- Entropy-Aware On-Policy Distillation of Language Models